AI 에이전트를 활용하여 압도적인 경쟁 우위를 확보하세요
Claude를 활용하면 더 효과적으로 계획하고, 실행하며, 협업하는 AI 에이전트를 구축할 수 있습니다.


탁월한 추론 능력과 인간 수준의 응답을 제공합니다.
AI 에이전트를 위한 최고의 모델
Claude는 고객 지원부터 코딩에 이르는 다양한 AI 에이전트 시나리오에서 다른 모델을 능가하는 성능을 보여 줍니다.
인간의 감각을 갖춘 AI 에이전트
Claude의 대화형 스타일은 AI 에이전트와 사용자 간의 진정한 협업을 이끌어 냅니다.
브랜드를 보호하는 AI
Claude는 정직성, 탈옥 저항성, 브랜드 안전성 측면에서 최고 수준을 자랑합니다.
Claude의 강력한 AI 기능을 앱에 통합해 프로덕션급 에이전트를 더 빠르게 제공할 수 있습니다.
기존 프롬프트
모든 고객 지원 티켓을 가장 관련성이 높은 카테고리로 분류합니다. 선택할 수 있는 카테고리 목록은 다음과 같습니다. {{CATEGORY_LIST}} 지원 티켓의 내용은 다음과 같습니다. {{TICKET_CONTENT}}
어떤 부분을 개선하고 싶으신가요?
분류 근거를 포함해 줘.
너는 고객 지원 티켓을 분류하는 데 특화된 AI 어시스턴트야. 너의 임무는 제공된 티켓 내용을 분석한 뒤, 사전 정의된 목록 중 가장 적절한 카테고리에 티켓을 할당하는 거야. 또한 분류 결정에 대한 근거를 제시해야 해.
먼저, 사용 가능한 카테고리를 확인해:
<category_list>
{{CATEGORY_LIST}}
</category_list>
이제 분류해야 하는 지원 티켓의 내용은 다음과 같아:
<ticket_content>
{{TICKET_CONTENT}}
</ticket_content>
다음 단계를 따라 작업을 수행해야 해:
– 티켓 내용을 주의 깊게 읽고 분석한다.
– 해당 내용이 각 카테고리와 어떻게 연관되는지 고려한다.
– 티켓에 가장 적합한 카테고리를 선택한다.
– 추론 프로세스를 자세히 설명한다.
응답 시 다음 구조를 사용해 줘:
<classification_analysis>
이 섹션에서는 사고 프로세스를 다음과 같이 세분화해야 해:
– 티켓 내용 중 가장 관련성이 높은 부분들을 인용한다.
– 각 카테고리를 나열하고 티켓 내용과의 연관성을 기술한다.
– 각 카테고리에 대해, 티켓을 분류할 수 있는 이유와 그렇지 않은 이유를 제시한다.
– 가장 가능성이 높은 상위 3개 카테고리를 순위별로 제시한다.
</classification_analysis>
<classification>
<category>선택한 카테고리를 여기에 입력하세요</category>
<reasoning>해당 카테고리를 선택한 이유를 간략하게 요약하세요</reasoning>
</classification>
분석은 철저히 하고, 설명은 명확하게 작성해. 너의 목표는 충분한 근거를 바탕으로 정확한 분류를 제시하는 거야.
더 효과적인 AI 에이전트
- API를 통해 에이전트와 워크플로우 구축
- Workbench에서 프롬프트 테스트 및 개선
- 프런티어 기능을 에이전트에 탑재
- 모든 개발자가 AI 에이전트를 구축할 수 있도록 지원
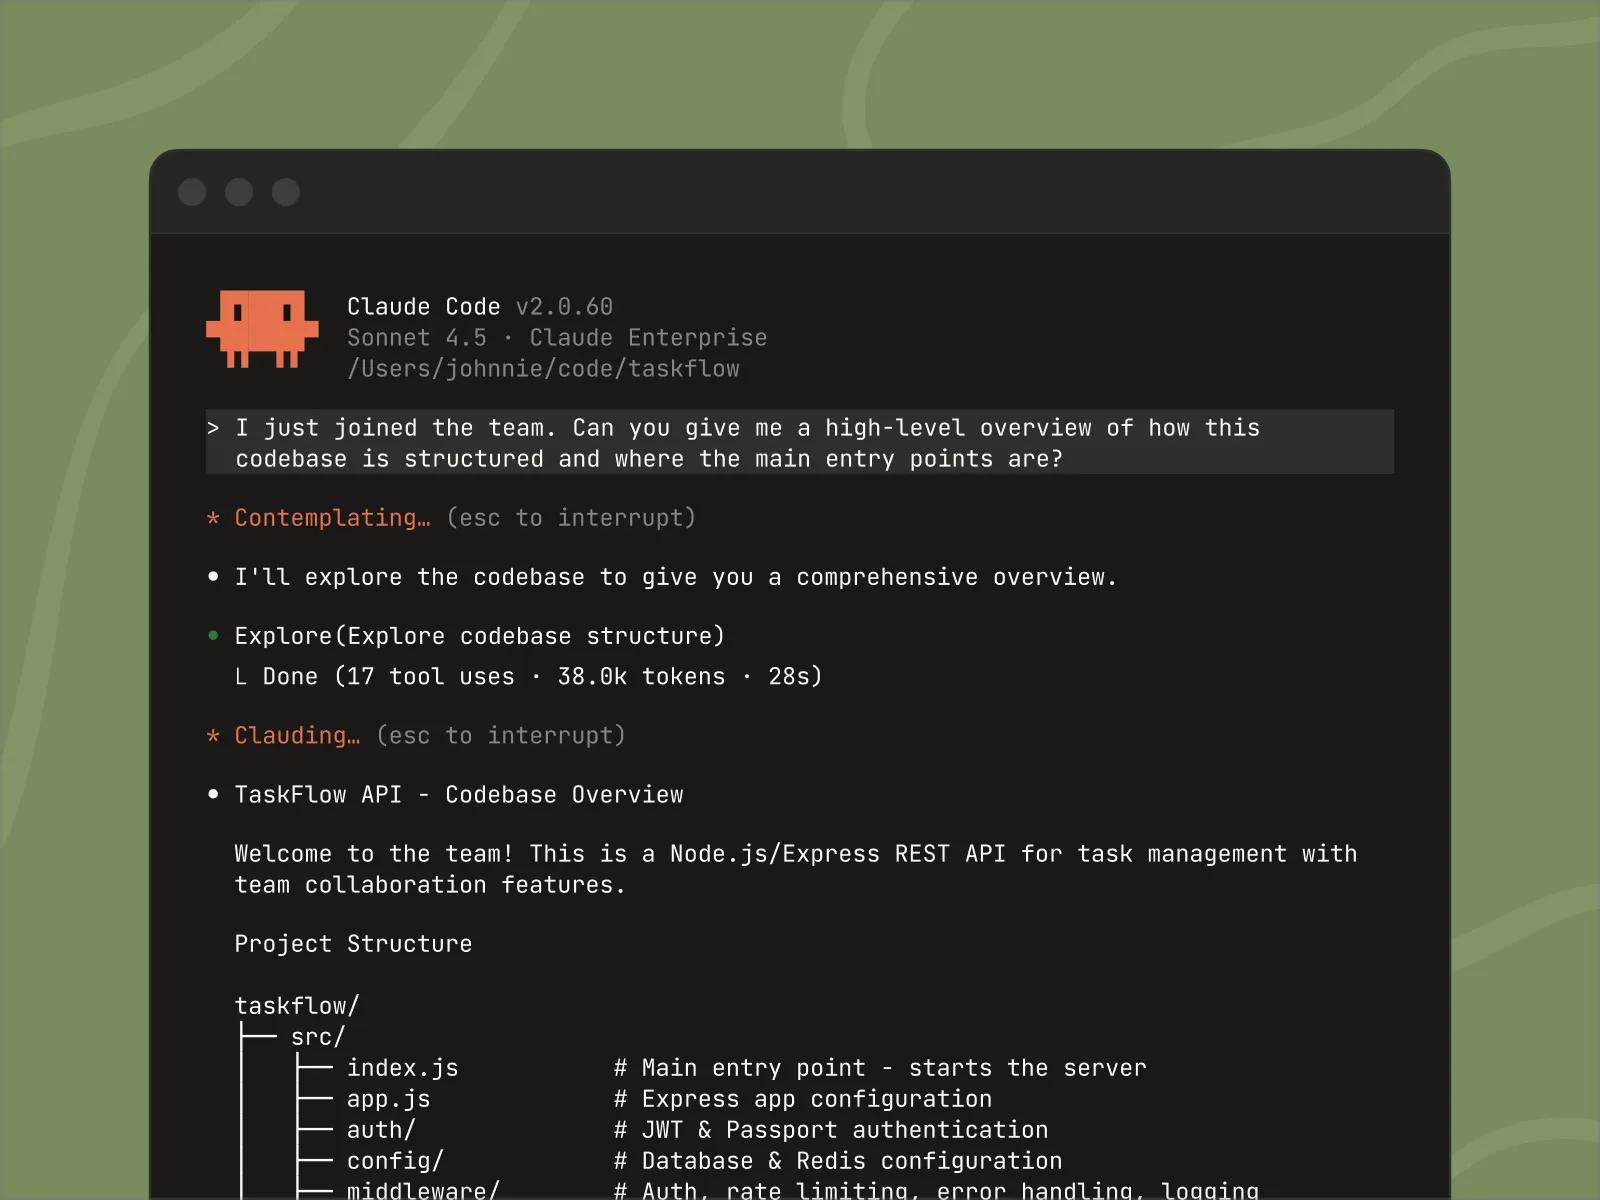
Claude와 협력하여 코딩해 보세요
Claude Code는 에이전틱 도구입니다. 개발자는 터미널에서 직접 Claude와 협업하며, 코드 마이그레이션부터 버그 수정까지 다양한 작업을 맡길 수 있습니다.
“Claude Fable 5.1은 지금까지 CursorBench 3.2에서 평가한 모델 중 가장 뛰어난 성능을 보였으며, 최대 노력 수준에서 73.4%의 점수를 기록했습니다. 특히 자신이 수행한 작업을 검증하는 데 탁월한 능력을 보여, 어려운 코딩 작업도 처음부터 끝까지 맡아 수행할 수 있습니다.”
“저희는 AI 모델을 지속적으로 평가하고 있습니다. 이번에 진행한 테스트에서 Claude Fable 5.1은 인상적인 결과를 보여 주었죠. Claude Code를 활용해 모든 추론 노력 수준에서 테스트한 빌드 실패 사례의 근본 원인을 정확하게 찾아냈습니다. 또한 이전 Anthropic 모델보다 더 효과적으로 소통하며, 진행 상황에 대한 업데이트도 더 간결하고 이해하기 쉽게 전달합니다.”

“개발자들은 실제 소프트웨어 작업을 맡아 끝까지 완료할 수 있는 에이전트를 원합니다. GitHub Copilot CLI와 VS Code에서 테스트한 결과, Claude Opus 5.5는 측정한 모델 중 가장 적은 토큰과 단계를 사용한 모델 중 하나였습니다. VS Code에서는 Claude Opus 5의 절반도 안 되는 단계로 더 많은 터미널 작업을 해결했죠. 이제 개별 작업의 효율성을 높이는 데 그치지 않고, 개발자들이 더 큰 규모의 프로젝트를 실현할 수 있도록 지원하고 있습니다.”


