고객 사례

500만
매월 고객 비즈니스 워크플로우에서 실행되는 AI 에이전트


10x
프로덕션 에이전트를 더 빠르게 구축하세요
최첨단 모델, 에이전트 실행 환경, 컨텍스트 관리, 인프라가 함께 작동하도록 설계되었습니다.






미국에서 실행해야 하는 워크로드의 경우, 입력 및 출력 토큰 기준 1.1배의 요금으로 미국 전용 추론을 사용할 수 있습니다. 더 알아보기.
Opus 5의 패스트 모드를 사용하면 표준 요금의 2배로 최대 2.5배 빠른 처리 속도를 경험할 수 있습니다. 더 알아보기.
프롬프트 캐싱 가격은 5분 TTL을 기준으로 적용됩니다. 확장된 프롬프트 캐싱에 대해 알아보세요.
Messages API를 통해 Claude의 최첨단 모델에 액세스하고, 완전한 제어와 맞춤형 설정을 통해 구축할 수 있습니다.
코드 실행
API 호출에서 Python 코드를 실행하고, 시각화를 생성하며, 데이터를 분석할 수 있습니다.
구조화된 출력
Claude의 응답이 지정한 JSON 스키마를 따르도록 합니다.
도구 사용
Claude가 수백 가지 외부 도구 및 API와 상호작용하도록 설정하면 더 폭넓은 작업을 수행할 수 있습니다.
컴퓨터 사용
Claude가 브라우저나 데스크톱을 보고 조작하여 API가 없는 애플리케이션의 작업을 자동화할 수 있습니다.
인용
소스 문서를 기반으로 응답을 제공합니다.
파일
대화 간에 문서를 업로드하고 참조할 수 있습니다.
컨텍스트 창
최대 100만 개의 컨텍스트 토큰으로 더 포괄적이고 데이터 집약적인 사용 사례를 실행합니다.
압축
토큰 한도에 근접하면 오래된 컨텍스트를 자동으로 요약합니다.
컨텍스트 편집
도구 호출과 결과를 자동으로 지웁니다.
웹 검색 및 가져오기
웹의 최신 데이터를 Claude로 가져옵니다.
매월 고객 비즈니스 워크플로우에서 실행되는 AI 에이전트
프로덕션 에이전트를 더 빠르게 구축하세요
장기 실행 에이전트를 대규모로 구축하고 배포하세요.
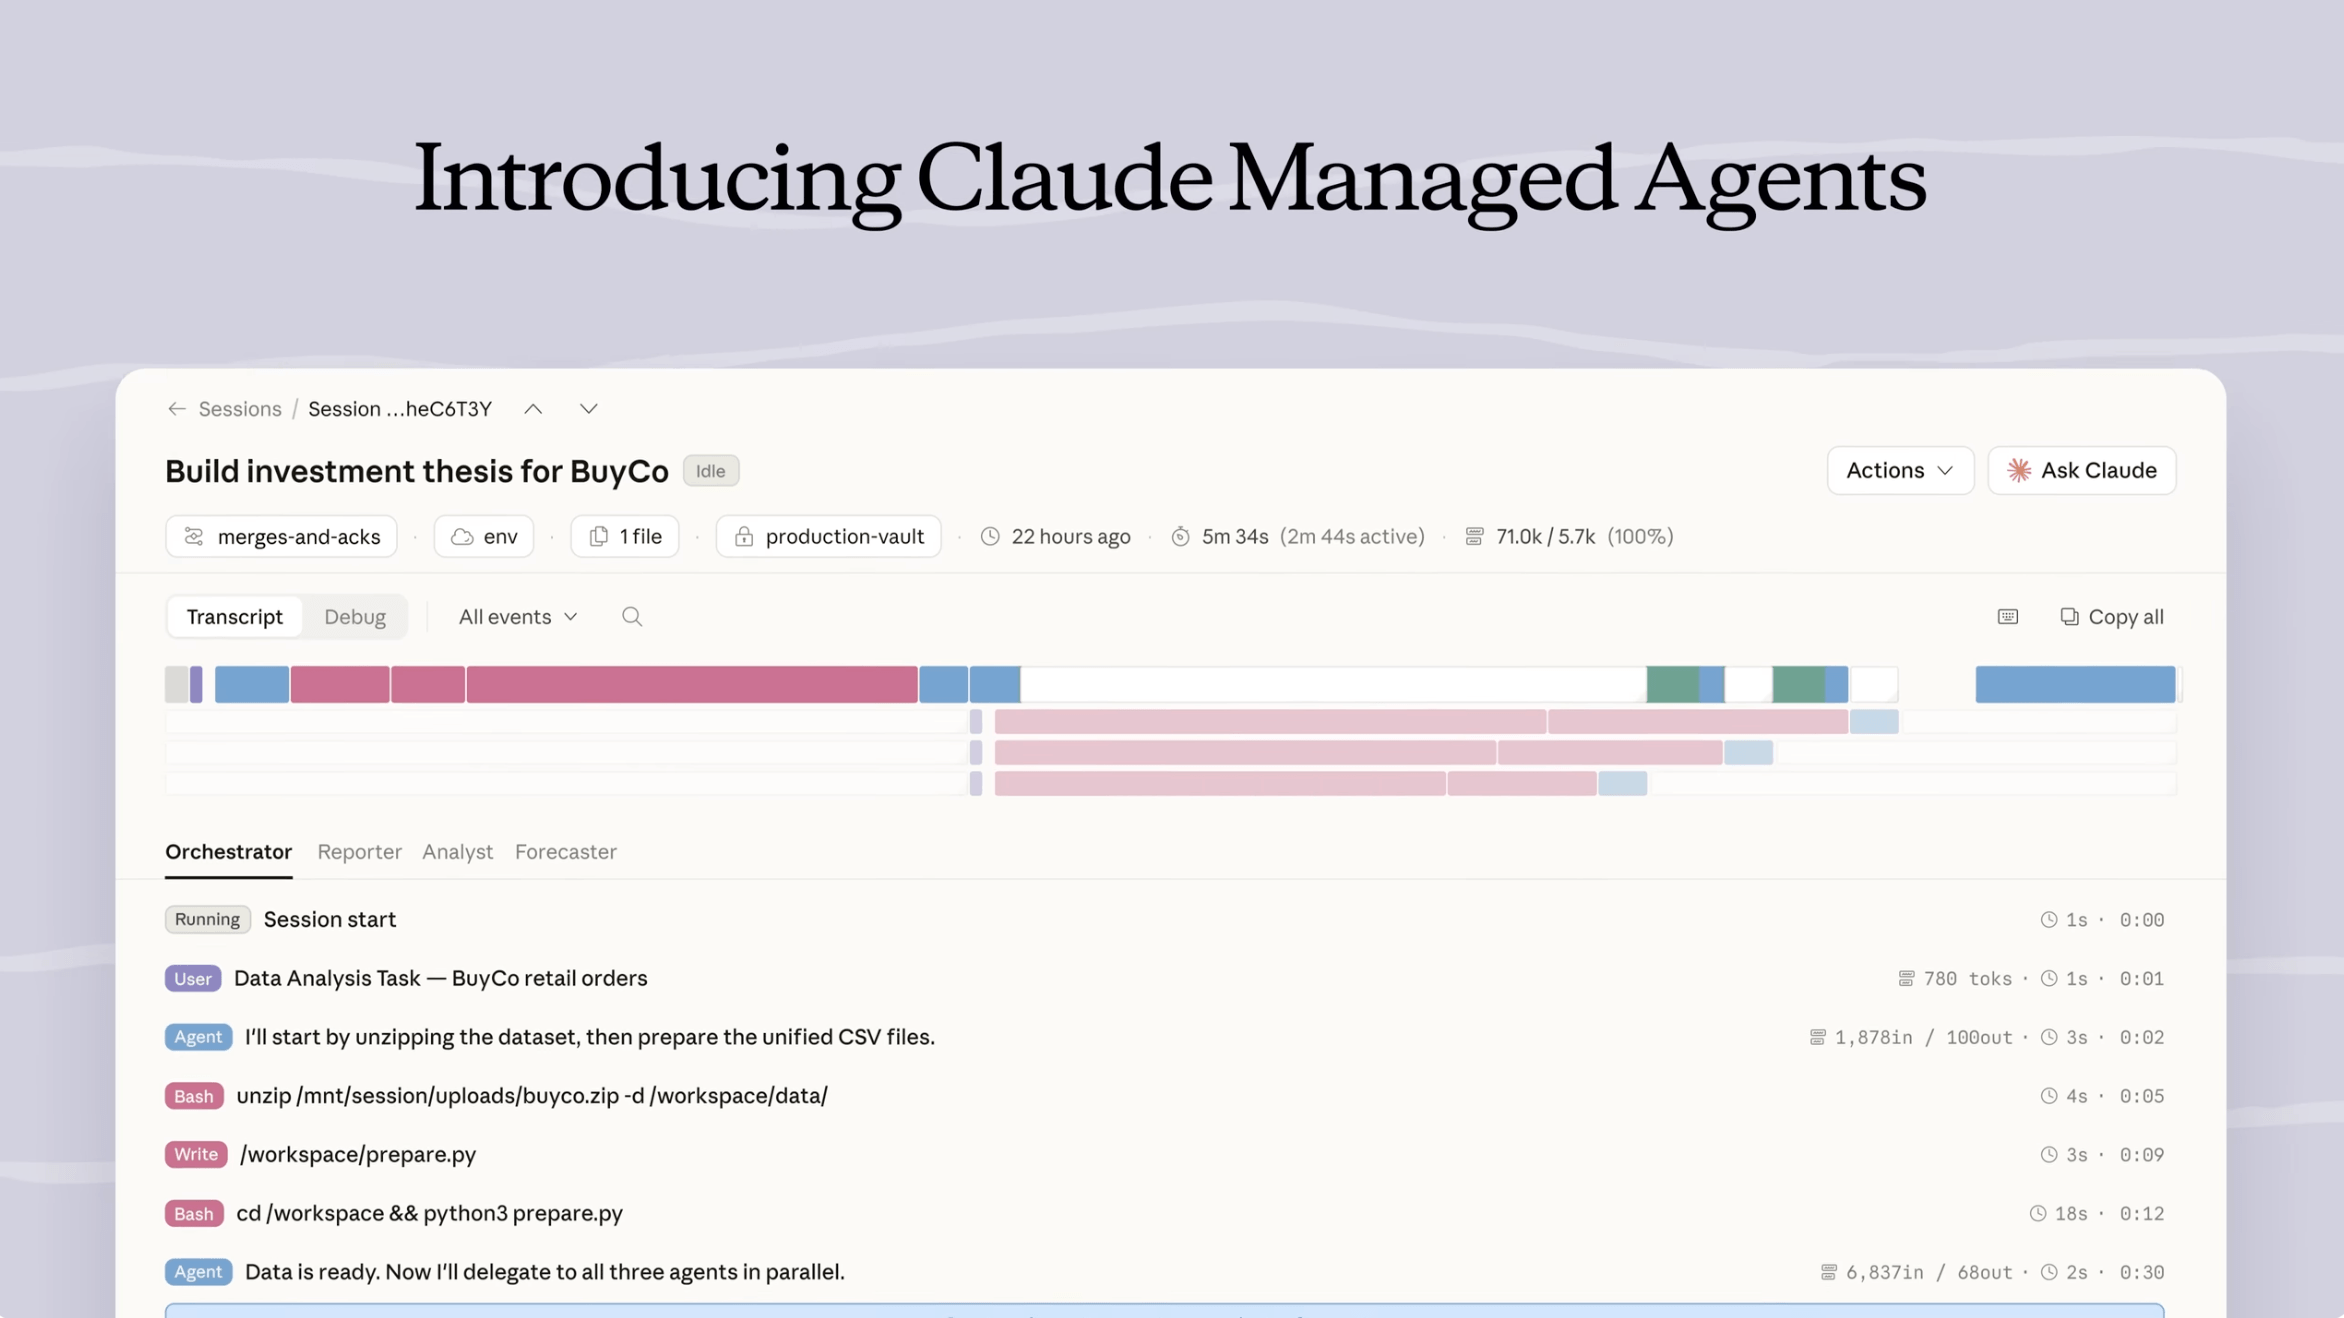
인증 정보는 샌드박스 외부에 유지되고, 암호화가 기본으로 적용되며, 상태는 자동으로 유지됩니다.
세션 추적은 모든 에이전트가 수행한 작업과 작업 이유를 기록하며, 기본 제공 분석 기능을 통해 에이전트 성능을 개선합니다.
기반 실행 환경은 Claude에 최적화되어 있습니다. 모델이 개선됨에 따라 에이전트도 함께 개선됩니다.
Claude의 기능을 확장하고 맞춤 설정할 수 있습니다.
AI 통합을 위한 개방형 표준을 통해 Claude를 도구와 데이터에 연결하세요.
사전 구축된 Skills나 맞춤형 Skills를 통해 Claude에 전문 지식, 절차, 모범 사례를 학습시켜 보세요.
에이전트는 여러 세션에 걸쳐 정보를 기억하며, 메모리 파일을 사용자의 인프라에 유지합니다.




기존 Anthropic 약정으로 파트너가 제공하는 Claude 기반 솔루션 비용을 결제해 보세요.
데이터에 대한 제어 기능과 보호 장치를 제공합니다.
자격을 갖춘 고객에게 Zero Data Retention(ZDR)의 프라이버시 보호와 함께 오용을 탐지하기 위한 최첨단 안전 장치를 제공합니다.
클라우드 공급업체에서 데이터가 저장되는 위치와 요청이 처리되는 위치를 선택하세요. 아시아 태평양, 캐나다, 유럽, 미국 리전이 제공됩니다.
Anthropic은 Anthropic은 기본적으로 상용 배포에서 생성된 고객 데이터를 Claude 학습에 사용하지 않습니다.




엔터프라이즈 보안과 지원이 기본 제공되는 Claude Platform에서 직접 구축하세요. 또는 Amazon Web Services, Google Cloud, Microsoft Foundry를 포함한 기존 클라우드에서 Claude를 사용할 수도 있습니다.
대규모 요청을 비동기 방식으로 처리하고 비용을 50% 절감할 수 있습니다.
Claude에 배경 지식과 사례를 제공하면 비용을 최대 90%까지 절감할 수 있습니다.
Claude가 작업에 얼마나 많은 노력을 기울일지 선택하세요.
더 빠르고 경제적인 모델이 더 지능적인 모델을 호출하여 계획이나 작업을 평가함으로써 성능을 개선합니다.


Quora의 경우 일괄 처리를 통해 비용을 절감하는 동시에, 실시간으로 처리할 필요가 없는 많은 쿼리를 실행하는 데 따른 복잡성을 줄일 수 있습니다.
분석 및 제어 기능이 기본으로 내장된 명령 센터입니다.
너는 고객 지원 티켓을 분류하는 데 특화된 AI 어시스턴트야. 너의 임무는 제공된 티켓 내용을 분석한 뒤, 사전 정의된 목록 중 가장 적절한 카테고리에 티켓을 할당하는 거야. 또한 분류 결정에 대한 근거를 제시해야 해.
먼저, 사용 가능한 카테고리를 확인해:
<category_list>
{{CATEGORY_LIST}}
</category_list>
이제 분류해야 하는 지원 티켓의 내용은 다음과 같아:
<ticket_content>
{{TICKET_CONTENT}}
</ticket_content>
다음 단계를 따라 작업을 수행해야 해:
– 티켓 내용을 주의 깊게 읽고 분석한다.
– 해당 내용이 각 카테고리와 어떻게 연관되는지 고려한다.
– 티켓에 가장 적합한 카테고리를 선택한다.
– 추론 프로세스를 자세히 설명한다.
응답에 다음 구조를 사용해:
<classification_analysis>
이 섹션에서는 사고 프로세스를 분석해:
– 티켓 내용에서 가장 관련성이 높은 부분을 인용한다.
– 각 카테고리를 나열하고 티켓 내용과 어떻게 연관되는지 설명한다.
– 각 카테고리마다 티켓을 해당 카테고리로 분류해야 하는 근거와 분류하지 않아야 하는 근거를 모두 제시한다.
– 가장 가능성이 높은 상위 3개 카테고리의 순위를 매긴다.
</classification_analysis>
<classification>
<category>선택한 카테고리를 여기에 기재</category>
<reasoning>이 카테고리를 선택한 이유를 간결하게 요약</reasoning>
</classification>
분석은 철저히 하고, 설명은 명확하게 작성해. 너의 목표는 충분한 근거를 바탕으로 정확한 분류를 제시하는 거야.
프롬프트의 프로토타입을 만들고, Skills와 파일을 업로드하고, 에이전트를 구성하세요.
볼트와 메모리가 포함된 호스팅된 환경에서 에이전트를 실행하세요.
사용량, 비용, 캐싱, 속도 제한을 모델과 API 키별로 추적하세요.
워크스페이스별로 API 키, 멤버, 토큰 한도, 보안을 제어하세요.


"개발자는 실제 소프트웨어 작업을 맡아 완료할 수 있는 에이전트를 원합니다. GitHub Copilot CLI와 VS Code에서 테스트한 결과, Claude Opus 5.5는 측정한 모델 중 가장 적은 토큰과 단계를 사용한 것으로 나타났습니다. VS Code에서는 Opus 5 대비 절반도 안 되는 단계로 더 많은 터미널 작업을 해결했습니다. 개별 작업을 더 효율적으로 처리하는 것을 넘어서, 개발자가 더 큰 규모 프로젝트를 더 쉽게 실현하도록 지원합니다."
“For Lovable builders, Opus 5.5 means faster builds with the same quality, whether you’re starting from scratch or working on a live app. It gathers context once, makes fewer and more complete edits, and doesn’t get stuck retrying, finishing in a third to half fewer steps and using significantly fewer tokens along the way.”


"Claude Opus 5.5를 사용한 내부 평가 전반에서 토큰 효율성이 뚜렷하게 향상된 것을 확인했습니다. 또한 동일한 작업을 더 적은 비용으로 빠르게 완료할 수 있었습니다."


"금융 기업에는 일관되게 정확한 결과가 필요합니다. Claude Opus 5.5는 가장 낮은 노력 설정에서도 BigFinance Bench에서 높은 노력 설정의 Opus 5를 크게 압도하면서도 출력 토큰은 약 60% 더 적었습니다. 답변은 더 짧고 더 체계적이었으며, 슬라이드는 더 밀도가 높아 업계 표준에 더욱 부합합니다."


"Claude Opus 5.5는 중간 노력 수준을 기본값으로 설정할 수 있는 최초의 모델입니다. 테스트 결과, 높은 노력 수준의 Opus 5와 동일한 성능을 발휘하면서도, 사용되는 출력 토큰은 20~25% 적었습니다. 길고 복잡한 조사에도 항상 명확하고 실행 가능한 답변을 제시했습니다. 따라서 고객은 더 적은 비용으로 더 많은 작업을 수행할 수 있습니다."


"고객은 방대한 양의 콘텐츠에 Box AI를 사용하기 때문에, 속도와 비용이 최우선 사항입니다. 평가에서 Claude Opus 5.5는 Opus 5가 사용했던 토큰의 3분의 1만 사용했고, 정확성은 유지하면서 답변 내용을 40% 줄였습니다. 금융 서비스와 공공 부문과 같은 분야에서 콘텐츠 전반에 걸쳐 에이전트를 실행하는 팀에게 이 점이 매우 중요할 것으로 봅니다."


“In Epic’s early testing, Claude Sonnet 5.5 cleared the same quality bar you’d expect from a higher-tier model, holding up on a system design audit and a data-flow review. The new model managed tens of thousands of lines of code for gameplay system architecture, kept responses snappy, handled multi-hour tasks, and delivered with less prescriptive prompting.”
“Without changing any of our prompts, Claude Sonnet 5.5 did better than Sonnet 5 on almost all of our offline Slackbot evals, in fewer steps and with about 14% fewer output tokens. When someone gives Slackbot a task, quality and speed are what matter most, and Sonnet 5.5 allows Slackbot to deliver better outcomes for users, faster.”


“We fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions and resolved tickets faster than the Claude models we use in production today. Tickets were processed 20% faster, getting our customers the help they need without the wait.”


“Claude Fable 5.1은 저희 인시던트 조사 평가에서 선도적인 모델입니다. 이 평가는 실제 프로덕션 인시던트를 활용해 저희 에이전트인 Bits Investigation이 근본 원인 분석을 얼마나 효과적으로 수행하는지 측정합니다. 에이전트의 결과물은 저희 엔지니어가 파악한 근본 원인과 대조해 평가합니다. 이 평가에서 Fable 5.1은 Opus 5보다 뛰어난 추론 능력을 보여주었으며, 저희가 테스트한 가장 복잡한 프로덕션 인시던트를 성공적으로 진단했습니다.”
“저희는 출시 당일 Devin의 Opus 5 트래픽을 Claude Fable 5.1로 전환합니다. 저희 테스트에서 Fable 5와 동등하거나 조금 더 나은 결과를 더 낮은 작업당 비용으로 보여주었으며, 새로운 캐시 읽기 요금 체계 덕분에 그동안 Opus에 맡겨 두었던 워크로드에서도 Fable 급 모델이 마침내 경제성을 갖추게 되었습니다. 코드 리뷰부터 시작합니다.”
“다른 세 개의 프런티어 모델이 이상 없다고 판단한 라쿠텐 메디컬의 임상 연구 프로젝트를 Claude Fable 5.1에 검토하도록 요청했습니다. Fable 5.1은 어떤 모델도 발견하지 못한 허점을 찾아냈고 추가 검증이 필요하다고 강조했습니다. 이어서 완전히 새로운 가설을 제시해, 저희가 포기했던 데이터셋을 단 하루 만에 새로운 연구 방향으로 전환시켰습니다. Claude와 같은 프런티어 모델이 이런 방식으로 새로운 연구를 탐색하도록 이끌어 준 것은 처음입니다.”


“Claude Fable 5.1에서 가장 돋보이는 것은 글쓰기입니다. 더 이해하기 쉽고 더 알차며, 저희 작성 지침도 더 잘 따릅니다. Fable 5와의 블라인드 테스트에서 저는 Fable 5.1의 글과 결과물을 선택했습니다. 또한 Canva Code에서는 실제 음악과 박자에 맞는 플레이를 갖춘 리듬 게임을, 직접 생성한 레벨에 맞춰 구현했습니다. 저희가 테스트한 다른 어떤 모델도 해내지 못한 일입니다.”


“저희 리서치 평가 모음에서 Claude Fable 5.1은 최고 점수를 새로 기록했습니다. 한 과제에서는 다른 모델에서도, 그동안의 인간 연구자에게서도 본 적 없는 완전히 다른 관점의 새로운 해법을 내놓아 기존의 정체 구간을 크게 뛰어넘는 결과를 만들어 냈습니다. 창의적인 문제 해결과 어려운 문제를 푸는 데 필요한 통찰을 얻는 데서 더 뛰어납니다.”


"Claude를 선택한 결정은 전적으로 데이터에 기반한 것이었습니다. 여러 모델 제공업체를 나란히 두고 테스트한 결과, Claude는 사례 해결률과 고객 만족도 점수에서 일관되게 최고의 결과를 제공했습니다."
"Anthropic과의 파트너십은 매우 특별했습니다. 그들의 가이드와 지원 덕분에 저희 엔지니어링 팀이 모델을 최대한 활용할 수 있었습니다."
개발자 뉴스레터 구독
제품 업데이트, 사용 방법, 커뮤니티 스포트라이트 등 다양한 소식을 전해드립니다. 매달 이메일로 받아보세요.