Anthropic이 Claude를 활용해 셀프 서비스 데이터 분석을 지원하는 방법
많은 데이터 사이언스 및 데이터 엔지니어링 팀이 입증할 수 있듯이, 셀프서비스 데이터 분석을 지원하는 것은 전통적으로 어려운 일이었습니다.
광범위하고 비정규화된 표를 통해 비기술적 동료들이 데이터 모델을 더 쉽게 접근할 수 있도록 하는 경우, 비즈니스 규모에 따라 정의가 일관되지 않는 중복 관점이 발생하는 경우가 많습니다(따라서 SQL을 배우려는 의도가 거의 없는 직원들의 격차를 해소하는 데 거의 도움이 되지 않습니다). 또는 사용자를 위해 더 링펜싱된 환경을 만드는 것은 비즈니스 질문의 긴 테일을 놓치는 경우가 많으며, 팀이 업무를 사일로화하면서 지표와 대시보드가 과도하게 커지는 경우가 많습니다.
LLM의 증가로 인해 이러한 과제를 피하는 셀프 서비스 분석을 위한 또 다른 경로가 제공됩니다. 하지만 Claude를 창고에 맡기고 에이전트가 이를 실행하도록 내버려 두면 정확성에 대한 잘못된 인식을 줄 수 있습니다.
임시 요청에서 해방되겠다는 초기 기대는 이러한 설정이 이해 관계자를 기초적인 인프라, 문서, 전문 지식에서 분리한다는 사실을 깨닫게 되면서 두려움으로 바뀌게 됩니다.
Anthropic은 비즈니스 분석 쿼리의 95%가 Claude를 통해 자동화되며, 전체 정확도는 95%에 달합니다. 이 반복적인 반복 업무를 Claude에 맡기면 데이터 사이언스팀이 인과적 모델링, 예측, 머신러닝과 같은 더 전략적인 업무에 집중할 수 있습니다.
Anthropic의 최고 Claude Code 사용자 수십 명과 만나, 분석 에이전트의 다양한 디자인 패턴을 확인한 뒤, LLM을 사용하는 다른 데이터 팀을 위한 모범 사례를 마련했습니다. 이 게시물에서는 셀프서비스 비즈니스 인사이트를 도출하는 Claude의 역량을 극대화하기 위한 팁과 접근 방식을 소개합니다.
- 분석 정확도가 코드 생성 문제가 아니라 컨텍스트 및 검증의 문제인 이유
- 대부분의 오류를 일으키는 세 가지 실패 사례
- 이러한 오류를 해결하기 위해 구축한 에이전트 분석 스택
- 효과를 측정하는 방법 및
- 대부분의 Skill을 개발하는 방법을 보여주는 기본 템플릿(부록 참조)
데이터는 소프트웨어가 아닙니다
LLM의 생성형 능력은 양날의 검입니다. 복잡한 문제에 대한 창의적인 해결책을 제공하는 메커니즘은 잘못된 결과를 유발할 수 있습니다. 분석 에이전트의 과제를 완전히 이해하려면 분석 에이전트를 코딩 에이전트와 비교하는 것이 좋습니다.
코딩은 모델의 창의성을 발휘할 수 있는 개방형 솔루션 영역이며, 문서화와 테스트는 할루시네이션을 방지하는 자연스러운 안전 장치 역할을 합니다. 반대로 분석 사용 사례의 경우, 적절한 하나의 데이터 소스를 기반으로 단 하나의 정답을 도출해야 하는 경우가 많으며, 이 때는 정답의 정확성을 입증할 수 있는 결정적인 방법이 없습니다.
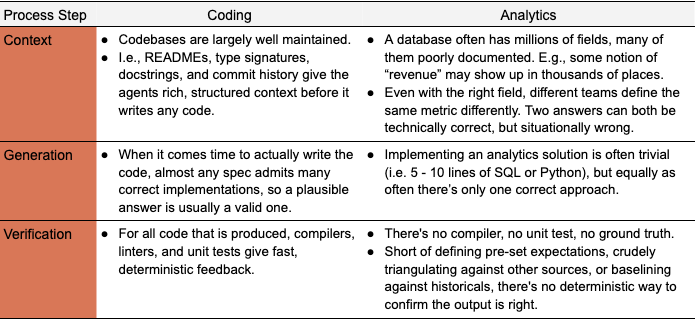
셀프 서비스 에이전트 비즈니스 분석의 복잡성은 주로 데이터의 모호성에 있습니다. 핵심 문제는 사용자의 질문을 데이터 모델의 특정 최신 엔티티에 매핑하고, 이를 바탕으로 올바른 작업 방식을 파악하는 능력에 있습니다. 그렇게 할 수 있다면, 결과로 실행되는 데이터와 SQL은 훨씬 더 간단해집니다.
부정확한 응답의 대부분을 차지하는 원인인 이 문제의 세 가지 특징을 확인했습니다.
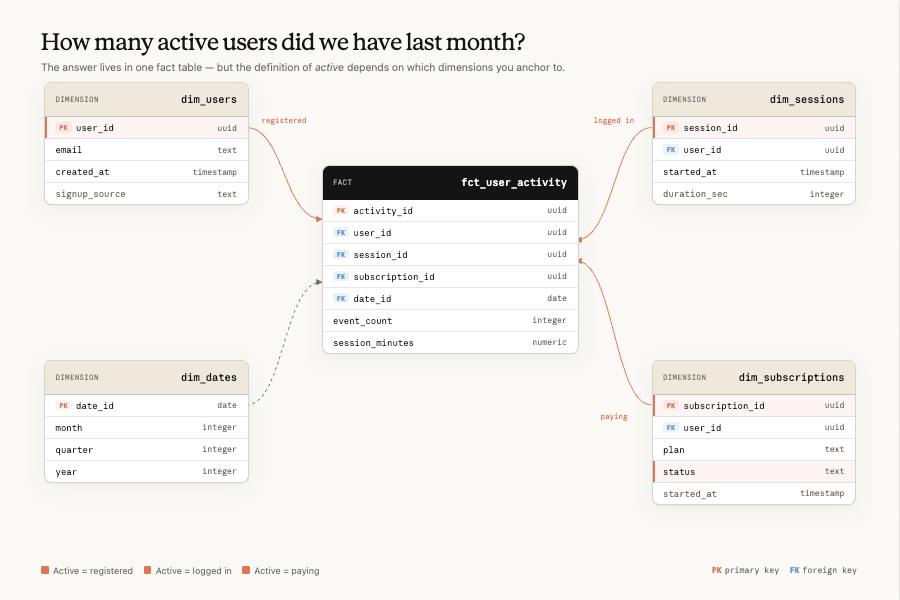
- Concept <> 엔티티 모호성: 데이터 모델에 수백 개의 실행 가능한 옵션이 존재하면(잠재적으로 수백만 개의 필드 중에서), 에이전트는 사용자의 질문에 가장 잘 답하는 필드를 선택할 수 없습니다. 예를 들어, 활성 사용자 수를 측정할 때, '활성' 상태는 어떤 행동을 의미할까요? 사기성 사용자를 포함하고 있나요? 어느 기간을 기준으로 과거 데이터를 사용하나요?
- 데이터 노후화: 데이터 소스, 비즈니스 정의, 스키마가 지속적으로 변경되며, 자산과 에이전트 지식이 오래되면서 미묘하게 잘못된 답변을 반환하기 시작합니다.
- 검색 실패: 올바른 정보가 실제로 데이터 모델에 있고 적절한 주석이 달려 있을 수 있지만, 검색 공간이 너무 광대하기 때문에 에이전트가 단순히 해당 정보를 찾지 못합니다.
에이전틱 셀프서비스 분석 스택
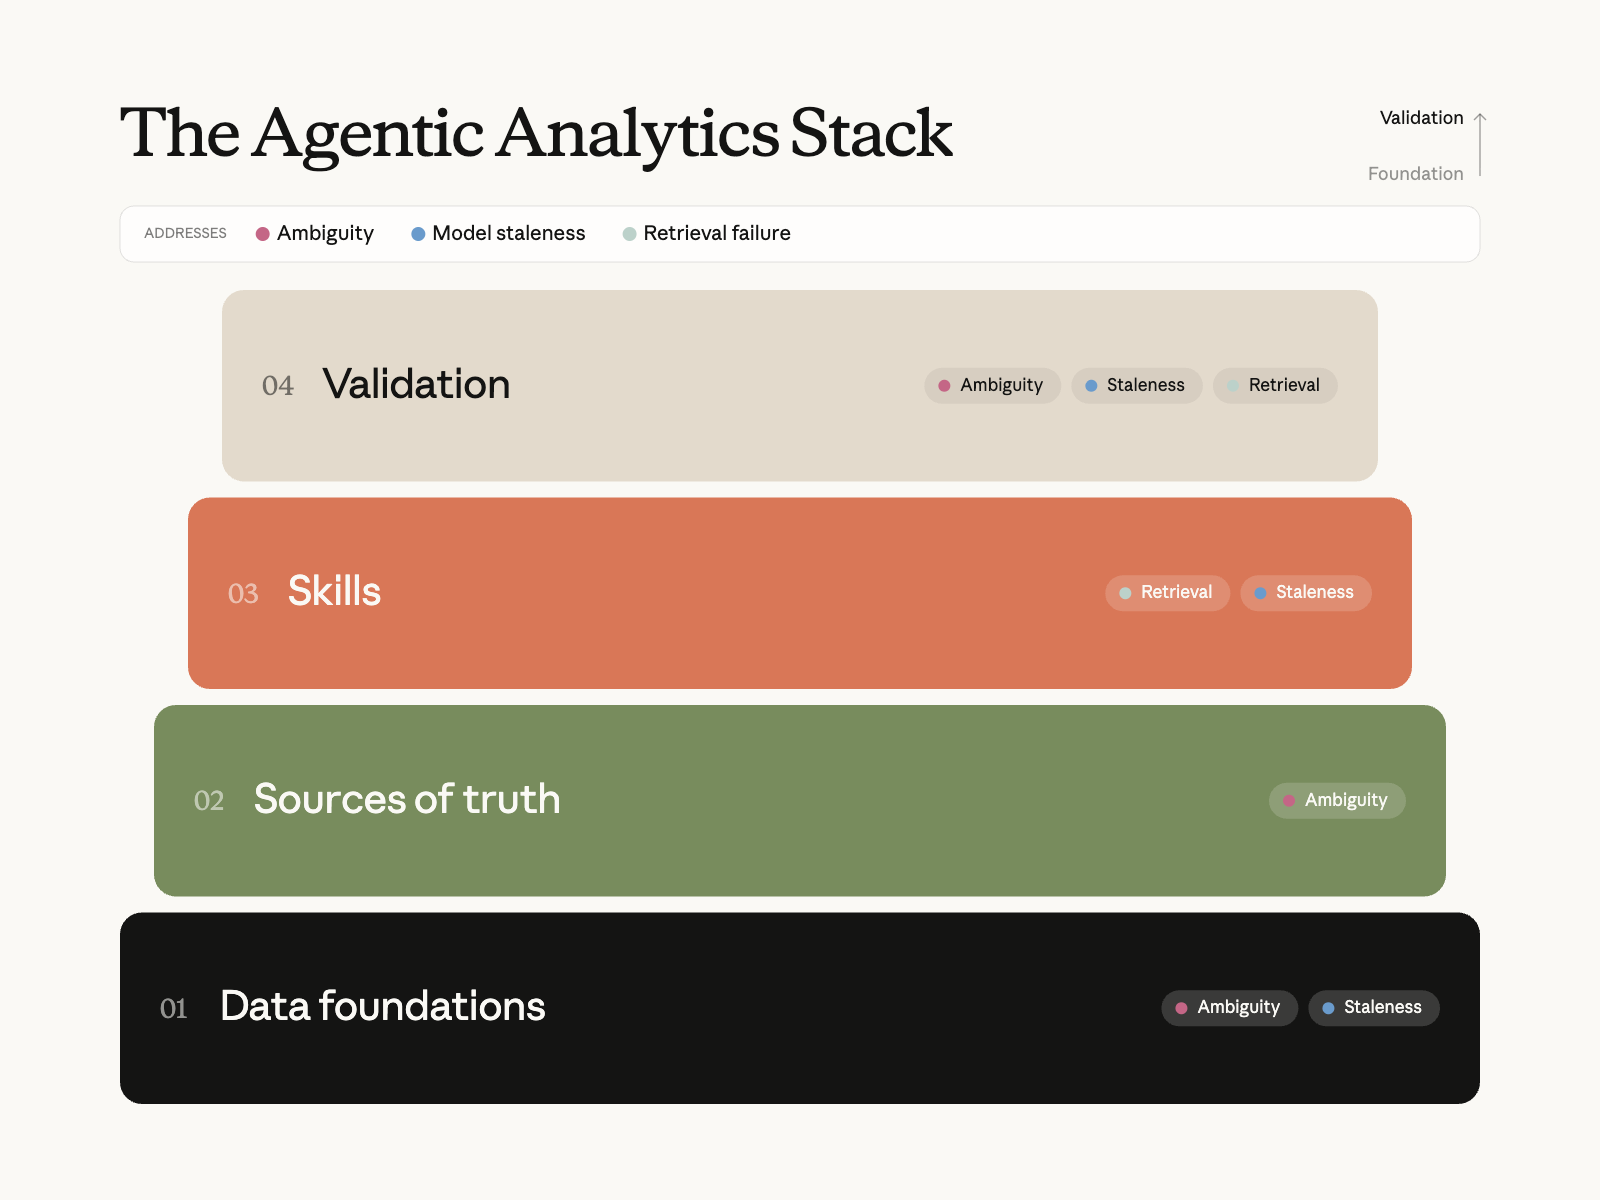
Anthropic은 이러한 세 가지 오류를 최소화하는 주된 방법은 에이전트 데이터 스택을 사용하는 것입니다. 각 계층은 주로 이러한 문제 중 하나 이상을 해결하기 위해 존재합니다.
- 개체 모호성: 데이터 기반과 진실 출처는 정당한 단일 정의 해답이 나올 때까지 그럴듯한 개체의 범위를 축소합니다.
- 부정착성: 유지보수 및 검증 프로세스는 비즈니스 변화에 따라 모든 것이 손상되지 않도록 합니다.
- 검색 실패: 스킬을 통해 에이전트는 해당 답변을 안정적으로 찾아 올바르게 사용합니다.
이 섹션에서는 각 계층을 어떻게 구축했는지 살펴보겠습니다.
“Slack에서 직접 묻는 임시 질문에 대해서는 데이터 팀이 Claude Tag를 활용한 데이터 분석 에이전트를 어떻게 배포했는지 확인하세요.”
데이터 기반
분석 에이전트의 정확성을 보장하는 가장 중요한 측면은 데이터 웨어하우스의 데이터 모델, 변환, 테스트, 테이블과 이를 설명하는 메타데이터를 포함하는 강력한 데이터 기반을 구축하는 것입니다. 차원 모델링, 좌변 테스트, 중요한 파이프라인의 새로움 검사와 같은 표준 데이터 엔지니어링 및 데이터 품질 관행은 여전히 적용됩니다(이러한 사항은 다시 적용하지 않음).
달라진 점은 데이터 모델의 최종 사용자는 더 이상 데이터 전문가(예: 데이터 사이언티스트)가 아니라, 다양한 수준의 데이터 전문 지식이나 기본 인프라에 대한 이해를 갖춘 사용자를 대신해 활동하는 에이전트라는 점입니다. 이러한 변화는 단지 최종 사용자가 모르기 때문에 결과가 근본적인 정확성을 검증하도록 요구할 필요가 없다는 점에서 어려움을 제기합니다.
데이터 파운데이션 레이어는 주로 모호성을 방지하는 것을 목표로 합니다. 예를 들어 매출이 40개 가능한 후보 항목이 아닌 하나의 데이터 집합으로 결정된다면, 에이전트가 검색하기 전에 문제는 대부분 사라집니다. 또한 데이터 노후화에 대한 첫 번째 방어선이기도 합니다. 표준 모델을 정의하는 동일한 리포지토리는 해당 모델이 항상 최신 상태를 유지하도록 관리하기에 적합하기 때문입니다.
특히 효과가 뛰어난 몇 가지 사례를 확인했습니다.
- 정규 데이터셋 생성: 가장 일반적인 실패는 에이전트가 개념("제품 X의 매출")을 올바른 하나의 표, 열, 지표 정의에 매핑할 수 없는 것입니다. 이는 보통 구현 방식이 미묘하게 다른 여러 가지 가능한 후보가 있기 때문입니다. 해결책은 더 적은 수의 논리적 모델을 수정하고, 더 심하게 관리되는 논리적 모델을 수정합니다. 명확하게 소유하고, 사용할 수 있으며, 발견 가능한 정규적이고 단일 출처인 데이터셋을 선별한 다음, 거의 중복된 데이터는 적극적으로 제거합니다. 물리적으로 집계된 데이터와 캐시는 비용과 성능 면에서 여전히 중요하지만, 표준 모델과 별개의 대안으로 존재하는 것이 아니라 표준 모델에서 기계적으로 도입해야 합니다. 목표는 에이전트가 개념을 검색할 때 거버넌스가 관리하는 정해진 단일 정답을 찾는 것입니다.
- 표준 적용: 표준 모델과 지표 정의가 툴링으로 강제되고(에이전트가 구조적으로 먼저 해당 모델에 연결되며, 자세한 내용은 아래에 설명), CI(이를 우회하는 변경 사항은 검토 불가), 위임(다운스트림 팀이 거버넌스 레이어를 기반으로 구축하거나 그렇지 않은 이유를 설명)에 따라 시행되는 경우에만 기본 기준이 유지됩니다. 시행하지 않는 거버넌스는 빠르게 여러 후보 문제로 돌아갑니다.
- 아티팩트 배치: 끊임없이 변화하는 데이터 모델과 비즈니스 로직에 대응하는 주요 방어 방법은 '코로케이션'입니다. 거의 모든 데이터 코드(예: 모델링, 시맨틱 레이어, 참조 문서, 정식 대시보드 정의)는 단일 리포지토리에 있으며, CI 검사를 통해 계층 간 무결성을 보호합니다. 모델링 변경으로 인해 다운스트림 대시보드가 손상되거나 문서화된 메트릭이 무효화되는 경우, CI는 이를 표시하고, 수정 사항은 동일한 PR에 포함됩니다. (이 원리에는 아래의 Skills 섹션에서 다시 설명하겠습니다.)
- 메타데이터를 일류 제품으로 취급: 코딩 에이전트가 뛰어난 성능을 발휘하는 이유 중 하나는 README, 타입 시그니처, 문자열 등 코드베이스를 읽을 수 있기 때문입니다. 웨어하우스도 읽기 쉬운 상태로 유지할 수 있지만, 열 및 테이블 설명, 표준 메트릭 정의, 데이터 그레인 문서화, 유효한 값 범위, 계보, 소유권, 모델 계층화가 변환 자체와 동일한 수준으로 엄격하게 유지되는 경우에만 해당됩니다. 새로운 인사이트는 아니지만, 훌륭한 거버넌스는 에이전트가 적절한 데이터 집합을 선택할 수 있도록 중요한 컨텍스트를 제공합니다.
진실의 원천
데이터 기반이 데이터 웨어하우스 자체라면, 에이전트가 탐색하기 위해 참조하는 기준 표면이 바로 진실의 원천입니다. 이 계층은 개념 <> 엔티티의 모호성을 줄이고, 이해관계자의 질문에 표시된 '주간 활성 사용자'를 데이터 모델의 특정 관리 엔티티로 전환합니다. 대략 신뢰도가 높은 순서대로 나열하면 다음과 같습니다.
- 시맨틱 계층: 컴파일된 메트릭 및 차원 정의. 질문이 정의된 메트릭에 정확하게 매핑된다면, 에이전트는 함수를 호출해 회사의 다른 모든 표면에서 동일한 숫자인 하나의 숫자를 얻습니다. 에이전트는 구조적으로 시맨틱 레이어를 먼저 활용해야 합니다(기술 지침에 따라), (부록 참조). 시도했지만 실패한 아이디어 중 하나는 바로 LLM이 원시 테이블과 쿼리 로그를 바탕으로 메트릭 정의를 자동으로 생성하도록 함으로써 의미 계층을 부트스트래핑하는 것이었습니다. 그 결과, 우리가 제거하려고 했던 모호성을 인코딩한 그럴듯한 정의를 도출했으며, 사람이 직접 검토하는 소규모 계층에 비해 평가에서 부정적인 결과를 얻었습니다. 따라서 Claude로 문서를 작성하되 정의는 사람이 직접 작성하는 것이 좋습니다.
- 계정 정보 및 변환 그래프: 시멘틱 계층이 질문에 대한 답을 찾을 수 없는 경우, 데이터 계보와 표 순위(참조 수 기준)를 통해 에이전트는 어떤 상위 모델이 특정 개념에 데이터를 제공하는지, 어떤 모델이 더 이상 사용되지 않는지, 어떤 모델이 동일한 그레인을 공유하는지 할 수 있습니다. 이렇게 하면 '메트릭을 모르겠다'는 '어떤 기준을 적용해 집계해야 할지 안다'는 의미로 바뀌게 됩니다. 이는 또한 아래의 온라인 검증 과정에서 제시하는 신선도와 출처 신호의 핵심이기도 합니다.
- 쿼리 코퍼스: 대시보드, 노트북, 이전 분석 결과 과거 SQL을 수집합니다. 직관적으로 말하자면 이는 높은 가치가 있어야 합니다. 즉, 모든 질문에 이미 정답이 정해진 기록을 포함합니다. 실제로 에이전트에게 수천 개의 이전 쿼리에 대한 원시 검색 권한을 제공하면 정확도가 1점 미만으로 높아진 것으로 나타났습니다(아래 뒷부분에서 그 방식을 살펴보겠습니다). 비정형 검색에서는 새로운 질문을 올바른 선례에 맞출 수 없었습니다. 필요한 것은 그 코퍼스를 도메인별 체계적인 참조 문서와 재사용 가능한 분석 패턴으로 정리하는 것입니다. 쿼리 기록을 에이전트가 직접 읽는 진실 자료가 아니라, 큐레이션을 위한 원료로 취급하세요.
- 비즈니스 맥락: 대부분의 팀이 건너뛰는 계층이자 가장 오래 과소평가했던 계층입니다. 귀사의 비즈니스를 이해하지 못하는 에이전트는 사용자의 질문에 답하되, 그 의미는 답하지 않습니다. '2분기 출시'가 특정 제품을 의미하는지, 두 팀이 같은 용어를 다르게 정의하는지, 목요일에 이사회 회의가 있어 질문이 제기되는 것인지 알 수 없습니다. 인덱싱된 문서, 로드맵, 의사 결정 로그, 조직 구조로 구성된 회사 지식 그래프를 반영하므로, 에이전트가 주변 참조 자료를 분석하고 명확한 질문을 더 많이 할 수 있습니다.
4개 모두에서 공통적으로 나타나는 실패 패턴은 데이터 기반 단계에서 동일합니다. 문서화가 불량하거나 오래된 것이기 때문입니다. Claude는 이러한 격차를 해소하는 데 매우 유용하지만(열 설명 초안, 쿼리 패턴을 바탕으로 메트릭 문서 제안, CI에서 문서화되지 않은 모델 표시), 큐레이션과 소유권은 사람이 관리합니다.
다음 두 섹션에서는 이러한 소유권을 저렴하게 만들어 실제로 실현할 수 있는 방법에 대해 논의합니다.
Skills
진실의 원천이 에이전트의 선언적 지식(즉, 측정값이 의미하는 바)이라면 Skill은 그 절차적 지식(즉, 어떤 출처를 어떤 순서로 참조해야 하는지, 모호한 데이터를 어떻게 탐색해야 하는지, 최종 분석 결과는 어떤 모습일지)을 포함합니다.
Claude Code에서 Skill은 에이전트가 필요에 따라 읽는 마크다운 파일 폴더입니다. Anthropic에서 개발한 Skills는 엄청난 가치를 더합니다. Skills가 없으면 Claude가 분석 질문에 정확하게 답하는 능력은 평가 결과에서 21%를 넘지 못했습니다. Skill를 추가하면 이 수치가 전체적으로 일관되게 95% 이상, 특정 영역에서는 정기적으로 99% 정도까지 유지됩니다. 대부분의 Skills를 개발하는 데 사용하는 기본 틀은 부록을 참조하세요.
일부 모범 사례:
쌍별 Skills 생성: 지식 Skill는 필요에 따라 추가 도메인 세부 정보를 로드할 수 있는 얇은 최상위 라우터 역할을 합니다. "먼저 시멘틱 계층을 시도하되, 해결되지 않는다면 이 도메인에 맞춰 관련 테이블, 컬럼, 조인, 해결 과제를 설명하는 30개 이상의 레퍼런스 파일이 제공됩니다."라고 적혀 있습니다. 이 라우터는 사실상 검색 실패에 대한 해답입니다. 에이전트가 수백만 필드에 달하는 웨어하우스를 검색하는 대신, 쿼리를 작성하기 전에 검색 범위를 수십 개의 선별된 파일로 축소합니다. runbook Skill은 수석 분석가가 따라야 하는 프로세스를 인코딩합니다. 즉, 질문을 명확히 하고, 지식 Skill을 통해 소스를 찾으며, 쿼리를 실행한 뒤, 적대적 검토 서브 에이전트에게 그 결과를 반복합니다. 또한 재사용 가능한 12가지 분석 패턴(유지 곡선, 비율 분해, 퍼널 분석)을 번들로 제공하므로, 일반적인 요청이 매번 다시 만들어지는 일이 없습니다.
적절한 참조 문서 생성: LLM이 검색할 수 있도록 작성. 레퍼런스 문서는 오래된 규정 없이 표(그레인, 범위 및 제외 항목), 주의 사항의 작동 방식(예: '알려진 무료 이메일 도메인은 제외하되 anthropic.com과 같은 맞춤형 도메인은 유지'), 명시적인 라우팅 트리거(예: '실험 증가에 관한 질문이라면… 원시 이벤트 수에 사용하지 말 것')를 설명합니다. 참조 문서를 작성하는 데 사용하는 기본형은 아래를 참조하세요.
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]
Skill 유지 관리를 최우선 과 대우: Skill 문서는 매일 변화하는 데이터 모델을 설명하므로, 적극적인 유지 보수를 하지 않으면 몇 주 안에 잘못된 결과가 나옵니다. 오프라인 정확도가 출시 당시 95%였던 것을 지켜본 뒤, 1개월 동안 65%로 떨어진 것을 지켜보고 이를 엔지니어링 문제로 취급했습니다. 즉, 변환 모델과 동일한 리포지토리에 Skill 마크다운 파일을 배치하는 것을 의미합니다. 따라서 모델을 변경하는 PR은 해당 모델을 설명하는 문서를 업데이트하는 PR과 동일합니다. 코드 리뷰 후크는 Skill 파일에 영향을 미치지 않는 보고 모델 변경 사항을 표시합니다. 데이터 모델 PR의 약 90%가 동일한 diff에 Skill 변경 사항을 포함하고 있습니다. 또한 모델이 개선되고 기존의 실패 방식을 더 이상 적용하지 않음에 따라 Skills 기본 구조를 정기적으로 정리합니다.
모든 환경에서 일관되고 원활한 경험을 만드세요. 동일한 Skill이 Slack, IDE, 대시보드 도구, 독립형 에이전트 세션의 질문에 동일한 답변을 제공해야 합니다. 이를 위해 하나의 표준 출처(데이터 리포지토리)를 확보하고, Skill 변경 사항이 자동으로 동기화되도록 했습니다. 병합 시 Skill은 플러그인 마켓플레이스(IDE 사용자의 경우), 클라우드 스토리지 블롭(단일 파일을 읽는 호스팅된 앱의 경우)으로 동기화되며, MCP를 통해 리소스로 직접 제공됩니다. 또한 하드코딩된 리포지토리 경로와 특정 네임스페이스를 사용하지 않아 처음부터 이식성을 고려해 설계되었습니다.
검증
마지막으로 검증은 세 가지 실패 사례 중 어떤 것이 여전히 유출되고 있는지 확인하는 방식입니다.
오프라인 평가
일반적인 패턴은 데이터 팀이 분석 에이전트의 정확성을 파악하는 프로세스를 갖추지 않으면서 정교한 분석 환경을 설정하는 경우가 많습니다.
이러한 격차를 해소하는 한 가지 방법은 간단한 질문/답변 쌍으로 이루어지는 오프라인 평가를 사용하는 것입니다. ML 모델의 오프라인 테스트와 유사한 오프라인 평가를 생각할 수 있습니다. 온라인 에이전트의 성능을 알려주는 것은 아니지만, 중요한 차이가 있는지 알 수 있는 좋은 방법은 제공한다는 점에서 ML 모델의 오프라인 테스트와 유사합니다.
Anthropic은 두 가지 종류의 오프라인 평가를 도입하고 있습니다. 대시보드 기반 평가는 Claude가 자동 생성하고, 가장 일반적인 이해관계자 질문을 다룹니다. 롱테일 평가에서는 Claude의 비즈니스 컨텍스트(로드맵, 테이블 문서)를 제공하고, 나머지 영역에 걸쳐 타당한 질문을 생성합니다. 또한 이해 관계자가 스레드에서 에이전트를 수정할 때마다 지속적으로 수집하며, 해당 수정 사항은 후보 평가에 포함되므로
기타 모범 사례는 다음과 같습니다.
- 실제 데이터를 기준으로 작성된 평가는 기본 수치가 변하는 순간 유효하지 않게 됩니다. 모든 평가를 정확한 날짜로 지정하거나, 안정적인 사실 표에 맞춰 작성하거나, 채점자가 에이전트의 질문 내용을 평가하도록 하거나, 채점자가 에이전트의 질문 내용을 평가하도록 하자. 제품군을 CI에 연결해 종속성에 영향을 미치는 평가를 다시 실행하도록 하세요.
- 테스트 로그가 아닌 원격 분석 방식으로 결과를 저장합니다. 모든 실행은 Skill 버전, git SHA, 모델 ID, 어설션별 합격/실패, 토큰 개수, 월시계가 포함된 웨어하우스 테이블에 저장됩니다. "그 변화가 도움이 되었나요?" 쿼리가 되며, 시계열 데이터를 통해 단일 CI를 실행해도 해결할 수 없는 느린 회귀 결과를 포착할 수 있습니다.
- 도메인별 게이트 출시 횟수: 도메인 소유자는 평가 집합의 일부 임계값(처음에는 90% 수준)을 넘어야 이해 관계자에게 에이전트를 공지할 수 있습니다. 사용자에게 오류가 표시되기 전에 reference-doc 수정을 강제로 적용합니다.
- 적절한 수의 평가 계획: 필요한 평가 횟수는 비즈니스 영역의 복잡성과 기본 데이터 모델의 복잡성에 따라 달라집니다. 오프라인 정확도가 온라인 정확도를 얼마나 정확하게 예측하는지 추적해 보정하세요. 주제당 수십 개 이상의 수익이 감소하는 경우가 있고(예: '성장'), 새로운 모델이 생성될 때마다 한도가 낮아지는 것으로 나타났습니다.
- 오프라인 평가 정확도는 100% 이내여야 하며, 모든 정답은 시맨틱 계층(있는 경우)에 맞춰 있어야 합니다. 다시 말하지만, 이 수준의 정확도만으로는 시스템이 틀린 답을 내놓지 않을 수 있는 것은 아니며, 적절한 평가 범위가 있다고 가정하더라도 명백한 차이가 없을 뿐입니다.
절제 기법
Skill에 대한 모든 구조적 결정(예: 어떤 소스를 공개할지, 하위 에이전트가 해당 지연 시간을 보장할지, 두 가지 Skill을 하나로 병합할지)은 오프라인 평가 세트를 고정해 유지하면서 이루어집니다.
정확히 하나의 컴포넌트를 변경하고, 합격률을 비교합니다. 각 실행은 단 1시간 정도 소요되며, 많은 인수가 대체됩니다. 방법론은 어떤 단일 결과보다 더 중요합니다.
- 결과가 null인 경우를 고려해 디자인하세요. 가장 유용한 절제는 부정적인 것이었습니다. 에이전트에게 전체 대시보드, 변환 기능, 분석가 노트북 SQL(수천 개의 파일)에 대한 직접 grep 액세스를 제공했습니다. 그런 다음 성적표를 통해 모든 답변 전에 실제로 성적표를 읽는지 확인했습니다. 정확도는 어느 방향으로든 1점 미만의 차이로 이동했습니다. 그 다음에는 명백한 혼란을 확인했습니다. '잘못된 질문에 대한 답변이 코퍼스에 실제로 있었는지'였습니다. 약 80%의 경우, 그렇습니다. '답변이 존재함'이 '이제 정답을 맞히는지'를 예측했나요? 아니요, 정답 비율은 일정했습니다. 정보가 존재했고, 에이전트가 확인했지만, 여전히 사용하지 않았습니다. 단 한 번의 실험에서 병목 현상은 이전 작업에 대한 접근성이 아니라 구조(즉, 질문을 적절한 엔티티에 매핑)에 있음을 알 수 있었습니다. 이러한 인사이트는 수개월의 로드맵 방향을 바꿨습니다.
- PR 세분화에 집중하세요. 의미 있는 모든 Skill 편집은 관련 평가 슬라이스에서 사전/사후 검토를 거쳐 PR 설명에 차이가 표시됩니다. "문서를 개선했습니다"라는 정직한 답변을 유지하며, 선의의 추가로 문제를 악화시키는 놀랍도록 일반적인 사례를 포착합니다.
- 제대로 작동하지 않은 부분을 짧게 기록해 두세요. 두 가지 사례를 겪었는데, 특정 시점 이후에는 문서 개선을 더 진행하는 것이었습니다(3회 연속 부정적인 결과가 반복되었기 때문에 문서가 개선되는 것이 아니라 길어졌습니다). 대기 시간을 줄이기 위해 적대적인 검토자를 더 저렴한 모델로 바꾸는 것이었습니다(실제 속도 향상은 없었고 정확도가 거의 떨어졌습니다). 부정적인 결과는 기록하는 데 비용이 저렴하며, 다음 사람이 같은 실험을 다시 진행하는 것을 방지합니다.
온라인 검증
마지막 단계는 실제 온라인 시스템 성능이 최대한 정확한지 확인하는 것입니다. 우리가 취하는 몇 가지 조치는 다음과 같습니다.
- 적대적 검토: Claude Skill을 활용해 잠재적인 최종 답변에 대한 모든 기본 가정에 적극적으로 도전하면 평가 세트에서 정확도가 6% 높아졌지만, 토큰이 32% 더 많아졌고, 지연 시간은 72% 더 길어졌습니다.
- 출처 정보 푸터:모든 응답에는 응답이 출처가 어떤 소스 계층(시맨틱 계층 › 선별된 레퍼런스 › 원시 표)에서 비롯되었는지, 기본 데이터의 최신 상태, 모델 소유자가 포함된 푸터가 표시됩니다. 이 분석으로 더 정확한 답변을 만들지는 않지만, 소비자가 해당 답변을 얼마나 신뢰할 수 있을지 판단하는 데 도움이 됩니다. '원시 테이블, 최신성 확인 불가' 푸터는 상위 단계로 전달하기 전에 확인해야 하는 신호이며, 무음 실패에 대응하기 위해 우리가 보유한 몇 안 되는 완화 방안 중 하나입니다.
- 데이터 품질 확인: 에이전트가 적절한 방식으로 올바른 필드를 사용하고 있지만, 데이터 자체가 잘못되었을 수 있습니다. 기본적인 데이터 품질 검사를 추가해 참조 필드가 최신 상태이고, 완전하며, 이상 현상이 없는지 확인하는 것이 일반적인 관리 수칙입니다.
- 수동 모니터링: 지속적으로 추적하는 두 가지 프로덕션 시그널은 시맨틱 레이어를 통해 해결되는 에이전트 쿼리 비율과 수정 언어를 사용하는 응답 비율("이건 잘못된 표입니다", "부정 행위 필터를 놓치고 있습니다")입니다. 두 가지 모두 오프라인 통과율과 함께 매주 검토하는 대시보드에 반영됩니다.
- 능동적인 수정 사항 수집: 루프를 마무리하는 부분입니다. 예약된 에이전트가 몇 시간마다 이해 관계자 채널을 스캔해 유사한 수정 언어를 찾아 확인하고, 관련 참조 문서에 대한 단일 수정 사항을 작성하고, 도메인 소유자에게 태그된 PR을 엽니다. 수정 경로는 의도적으로 지루한 방식으로 적용됩니다. 마크다운 파일 편집, 병합, 모든 곳의 자동 동기화 등의 경우가 많기 때문에 도메인 소유자가 이 작업에 너무 많은 시간을 투자하지 않아도 됩니다. 동일한 수정 사항이 오프라인 평가 세트에 반영됩니다.
이 기능에서 완전히 포착하지 않는 실패 모드는 '무음 실패입니다. 답변은 틀렸지만, 그럴듯해 보이며, 반대 없이 사용됩니다. 완화 방안은 출처 정보 푸터, 경영진 중심의 모든 항목에 대한 명시적인 사람의 승인, 각 도메인의 주요 KPI에 대한 상시 평가 등이 있습니다. 이 평가는 대시보드에 따라 매일 타당성을 검사합니다. 하지만 아직 강력한 솔루션은 마련하지 못했습니다.
셀프 서비스 분석 시작하기
처음부터 시작하는 경우, 몇 가지 표준 데이터셋, 수십 번의 오프라인 평가, 그리고 단순한 지식 Skill이 대부분의 이점을 포착할 수 있습니다. 이 게시물의 다른 모든 내용은 해당 구축 후 추가한 것입니다.
또한 많은 모범 사례를 공유했으며, 모든 모범 사례가 모든 데이터 팀에 적합한 것은 아닙니다. 접근 방식에 영향을 미칠 몇 가지 원칙에 따라 조직에 맞춰 다음과 같은 질문을 던져 주세요.
- 현재와 미래의 정답의 정확성은 얼마나 중요할까요? AI 모델은 빠른 속도로 진화하고 있습니다. 기업들이 현재 모델의 부족점을 해결하기 위해 상당한 인프라를 구축하는 것을 종종 목격합니다. 모델의 부족한 부분을 알고 있으며, 그 차이를 메우기 위해 모델을 개선할 때까지 기다리는 것이 오버헤드를 훨씬 줄이지만, 회사의 리스크 허용도에 맞지 않을 수 있습니다.
- 시간이 지남에 따라 비즈니스 복잡성이 변할 것으로 어떻게 예상하고 계신가요? 여기에서 설명한 프로세스 중 일부는 과도한 과정을 거칠 수 있습니다. 예를 들어 데이터를 많이 생성하지 않거나, 소비자만 출력하거나, 데이터 모델을 단순하게 유지할 수 있는 경우가 많습니다.
- 결과물의 대상 고객층은 어느 정도의 기술적 수준을 갖추고 있나요? 다르게 표현하면, 답변이 잘못되었을 때 이를 인식할 수 있는 데이터 사이언티스트를 위한 분석 시스템을 구축한다면, 대중이 기본 데이터 모델에 익숙하지 않은 경우에 비해 오류에 더 관대할 수 있습니다.
- 정확도를 높이기 위해 얼마를 지출할 의향이 있나요? 적대적 검증과 같은 특정 프로세스로 정확도를 크게 개선할 수 있지만, 비용과 지연 시간이 더 많이 드는 경우가 많다는 것을 발견했습니다.
- 액세스 제어 및 내부 데이터 개인 정보 보호에 대해 얼마나 편안하게 느끼시나요? 에이전트는 보유한 컨텍스트가 많을수록 성능이 훨씬 높아지는 경우가 많지만, 광범위한 데이터 액세스는 대부분의 회사의 거버넌스 체계와 충돌합니다. 이 기준은 하나의 에이전트를 구축할지 아니면 여러 범위의 에이전트를 구축할지 여부를 결정합니다.
어떤 방향을 선택하든, 3가지 실패 방식을 각각 해결하는 것에서 가장 큰 이득을 얻을 수 있습니다. 모호한 부분을 하나의 정의 해답으로 정리하고, 쉽게 찾을 수 있도록 하며, 어느 하나가 유효하지 않을 때 표시를 표시합니다.
이 글은 데이터 사이언스 및 데이터 엔지니어링 팀의 Chen Chang, Clement Peng, Justin Leder, Johanne Jiao, Josh Cherry가 작성했습니다. 저자는 기여한 Michael Segner에게 감사의 뜻을 전합니다.
부록
Skill 파일 기본 구조
다음은 주요 웨어하우스 Skill의 기본입니다. 즉, 실제 파일의 구조와 내부 세부 사항이 [괄호로 묶인 자리표시자]로 대체된 내용입니다. 그대로 복사하라는 의미가 아니라, 기록할 가치가 있다고 판단한 섹션을 소개하기 위한 것입니다.
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]