Le guide du SDLC fondé sur l’IA
Comment transformer votre cycle de vie de développement logiciel avec l'IA, étape par étape.
Le code n'est plus le point de blocage
Entreprises et organisations ont commencé à utiliser l'IA pour écrire du code à une vitesse impensable il y a un an. Pourtant, les processus qui entourent ce code n'ont pas évolué au même rythme.
De nombreuses équipes d'ingénierie conservent les mêmes étapes de validation, revues, transferts de responsabilité et règles internes, ce qui freine les gains de productivité rendus possibles par des solutions de codage agentique comme Claude Code.
Le cycle de développement logiciel (SDLC) est le processus qui conduit un logiciel de l'idée à la mise en production. La plupart des organisations suivent une variante des six mêmes étapes : planification, conception, développement, tests, déploiement et maintenance. Traditionnellement, chacune de ces étapes constitue une phase distincte confiée à un métier différent. Les chefs de produit rédigent les exigences, les architectes techniques les transforment en conceptions, les ingénieurs réalisent ces conceptions, les équipes d'assurance qualité des entreprises réglementées les vérifient, les équipes de distribution les déploient et les opérations surveillent les systèmes en fonctionnement. Le travail passe d'une phase à l'autre au moyen de documents, de tickets et de validations.
Le cycle de vie du développement logiciel traditionnel repose sur des processus lourds pour garantir la responsabilité et le contrôle à chaque étape. Il a toutefois été conçu pour maximiser l'efficacité à une époque où l'étape la plus longue et la plus coûteuse consistait à écrire et à implémenter du code, ce qui n'est plus le cas aujourd’hui. Les PRD, les rituels d'estimation et les revues de sécurité produit ont tous été instaurés pour imposer un alignement pendant travaux de développement qui pouvaient durer des semaines, des mois, voire des trimestres entiers.
Le SDLC traditionnel comporte également des contrôles fondés sur l’hypothèse que chaque étape est effectuée par des humains. Les organisations qui tirent le plus de valeur de l’IA ont repensé leurs processus autour de ce que l'IA agentique permet désormais d’accomplir, tout en maintenant l’humain dans la boucle. Dans ce guide, nous présentons plusieurs bonnes pratiques mises en œuvre par notre équipe IA appliquée pour intégrer Claude en interne à chaque étape du SDLC, afin d'accélérer le développement et de fluidifier les processus. Ces pratiques s’inspirent notamment de notre travail avec nos clients.
Lorsque le code n'est plus un obstacle et que la phase de développement avance plus vite que ne le permet le SDLC traditionnel, trois constats s’imposent :
- Le gouet d'étranglement se déplace vers les étapes situées en amont et en aval de la phase de développement. Il s'agit principalement de la planification, des revues/tests et du déploiement, qui continuent d’avancer à vitesse humaine.
- Les contrôles ne correspondent plus à la réalité et deviennent ingérables. Il était logique de vérifier chaque ligne manuellement lorsqu'elle avait été écrite par une personne, mais ce modèle ne peut plus suivre lorsque l’essentiel du diff est produit par des agents.
- Les coûts de gouvernance augmentent puisque les exceptions continuent d’être traitées dans le cadre réunions et de comités qui ne se réunissent qu’une fois par semaine ou une fois par mois.
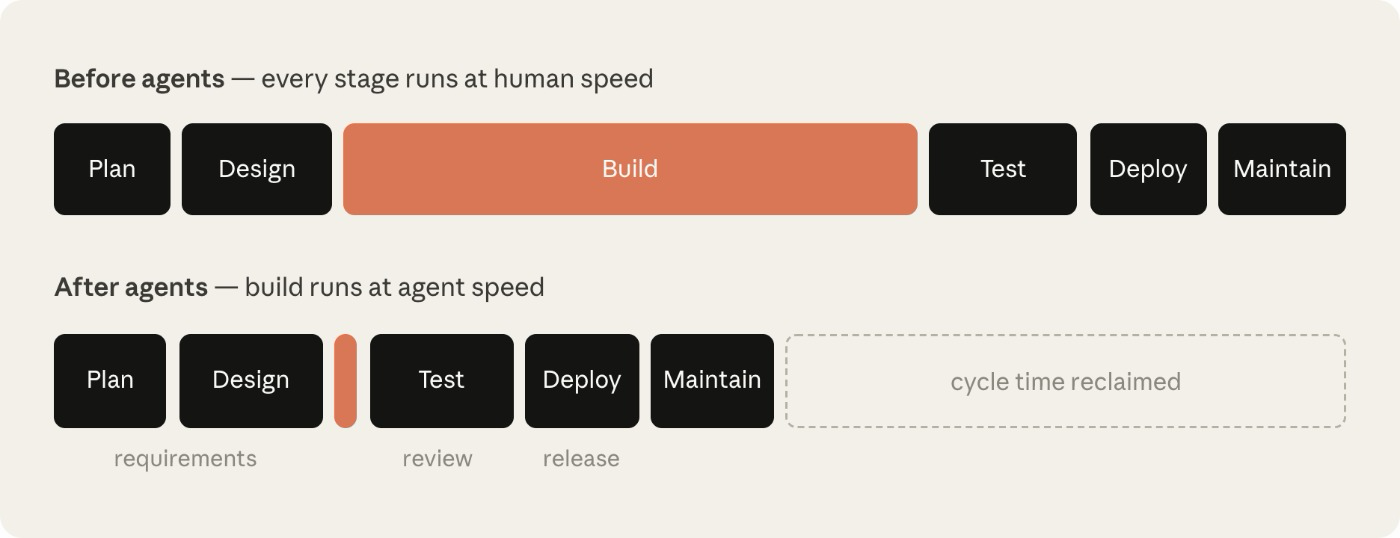
Prenons l'exemple d'un point de blocage lié à la sécurité. Les équipes de sécurité sont dimensionnées pour un volume de production humain. Lorsque les agents multiplient la quantité de code produite, deux scénarios se présentent : soit la file d'attente des revues s’allonge, soit du code est mis en production sans avoir été suffisamment examiné. Une organisation soumise à des contraintes réglementaires ne peut accepter ni l’un, ni l’autre. Ses contrôles de sécurité et de conformité doivent donc suivre le rythme des agents.
Pour tirer pleinement parti des gains de productivité permis par l’IA agentique tout en la sécurisant, le cycle de développement logiciel traditionnel doit faire l’objet d’une transformation à la même échelle que la phase de mise en œuvre elle-même.
Qu'est-ce qu'un SDLC fondé sur l'IA ?
Le SDLC fondé sur l'IA repense le processus en combinant les objectifs de contrôle traditionnels avec de nouveaux mécanismes d’application. Au lieu de suivre un parcours linéaire, le processus devient une boucle dans laquelle l’IA intervient à chaque étape. Le SDLC fondé sur l’IA favorise l’automatisation des transferts et le déclenchement des étapes suivantes, ce qui permet de remédier au caractère manuel et laborieux des passages d’une phase à l’autre dans le SDLC traditionnel.
Cette évolution est également désignée par les termes SDLC agentique, SDLC ou, plus simplement, développement logiciel agentique. Les appellations varient, mais elles décrivent toutes la même transformation.
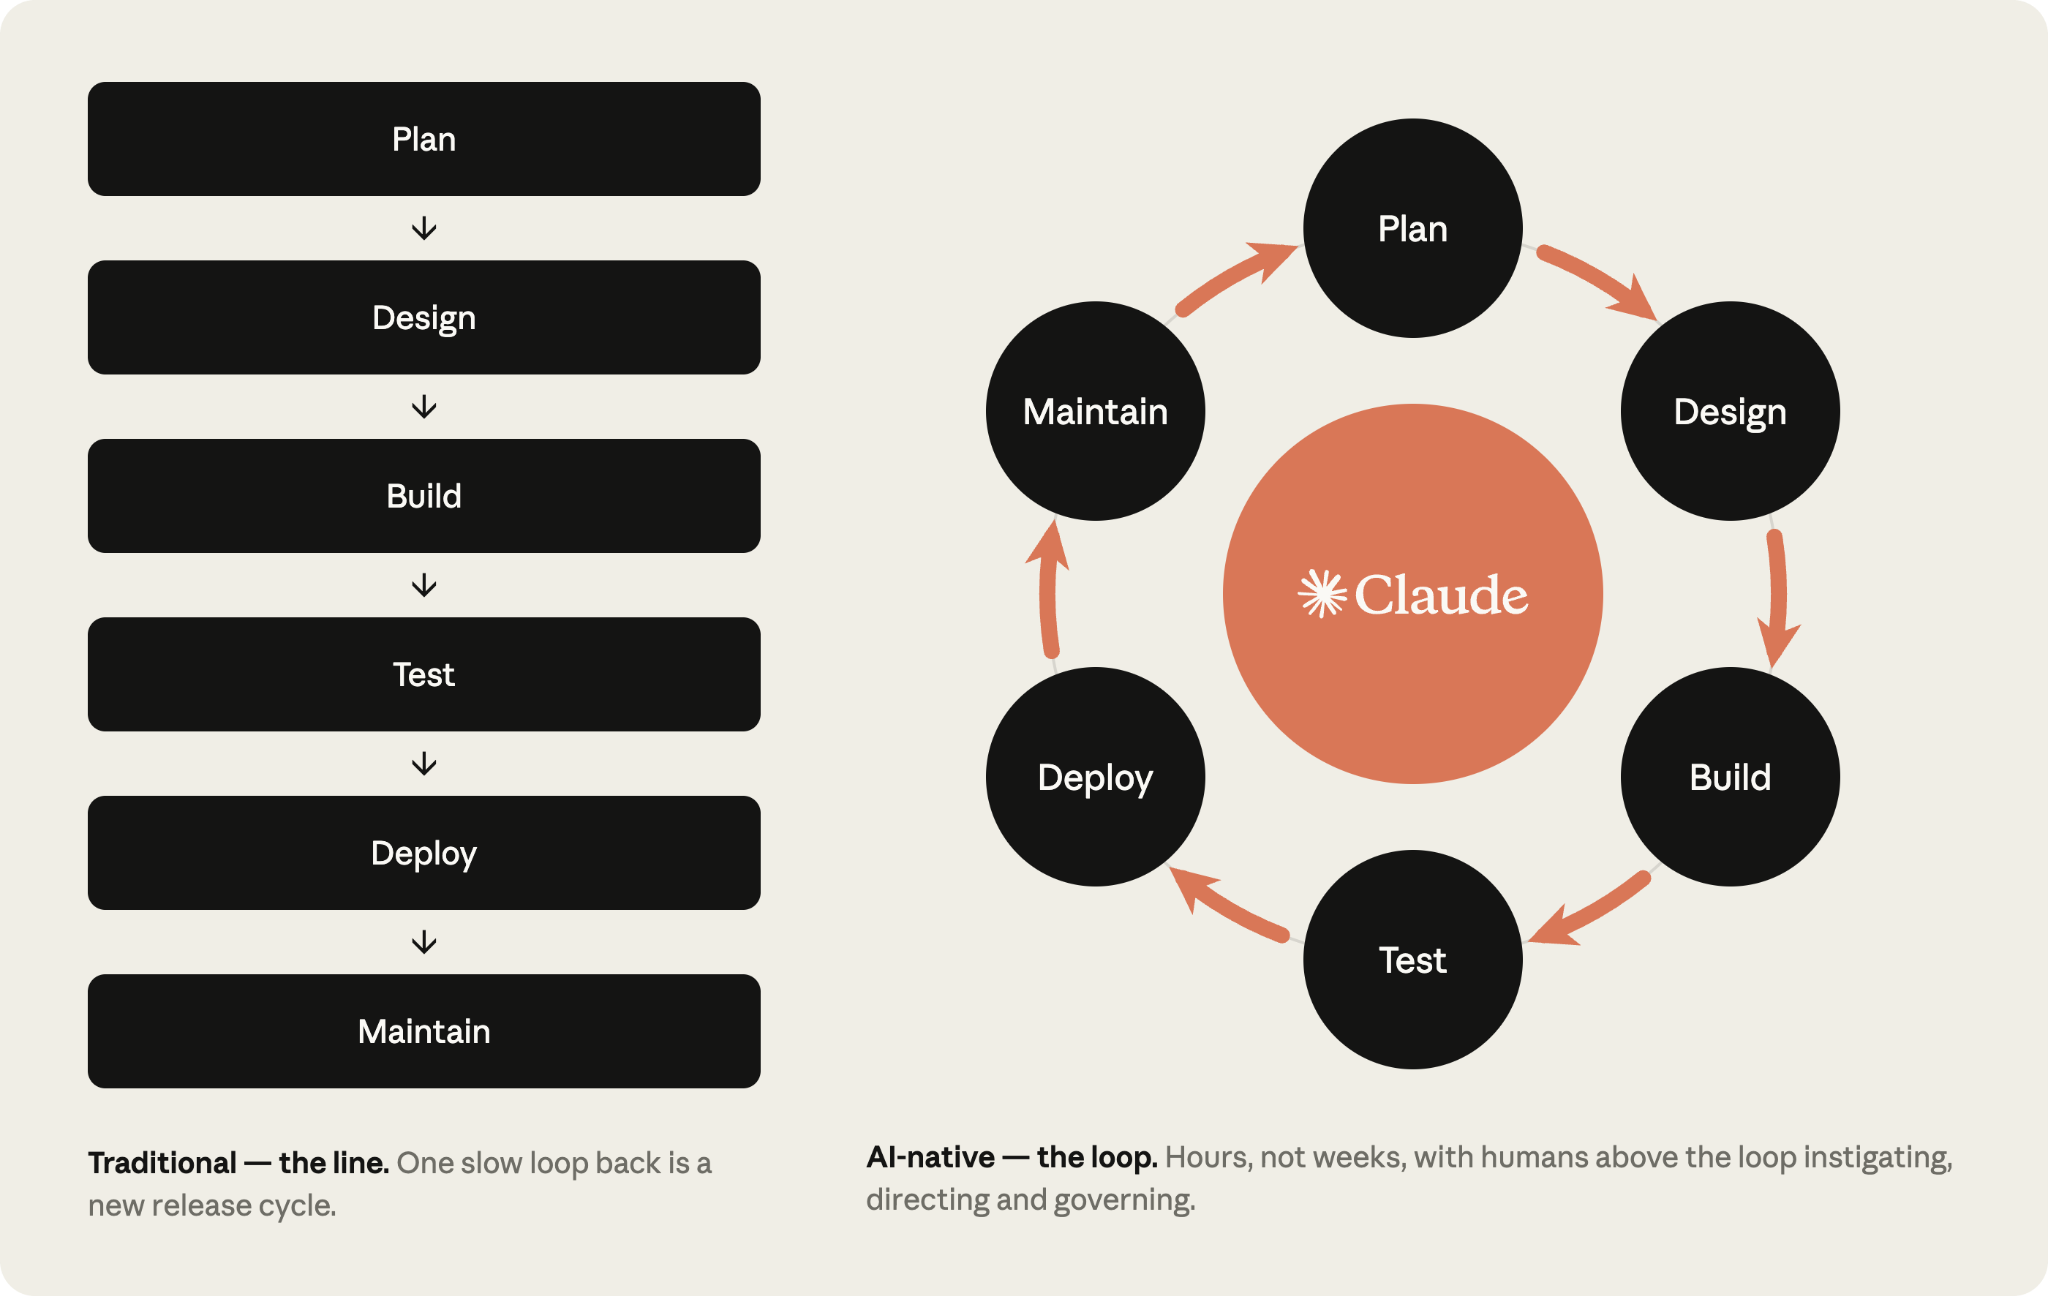
Les évolutions à travers les six étapes d'un SDLC fondé sur l’IA
Le tableau ci-dessous met en évidence les extrémités du spectre entre le SDLC traditionnel et le SDLC fondé sur l'IA, pris en charge par Claude. La plupart des organisations se situent quelque part entre les deux colonnes.
Le fil conducteur de la colonne de droite est l’artefact versionné. Chaque étape se termine par l’enregistrement d’un artefact dans le système de gestion de versions (notamment intent.md, spec.md, plan.md, le diff et ses tests, le PR avec les conclusions de la reue ainsi que le rapport d’incidents) et l'étape suivante commence par sa lecture. Dans les premières étapes, les fichiers .md constituent l'artéfact principal, car ils peuvent être lus et exploités aussi bien par un responsable produit que par un agent. À partir de la phase de développement, l’artefact devient principalement le code et les éléments qui lui sont associés. La chaîne de commits constitue également la piste d'audit : qui a demandé quoi, ce que l'agent a produit et qui l'a approuvé.
Les humains restent responsables de chaque décision nécessitant un jugement. Dans un SDLC agentique, l'attention humaine se déplace donc avec les artefacts qui doivent être examinés.
Séquences
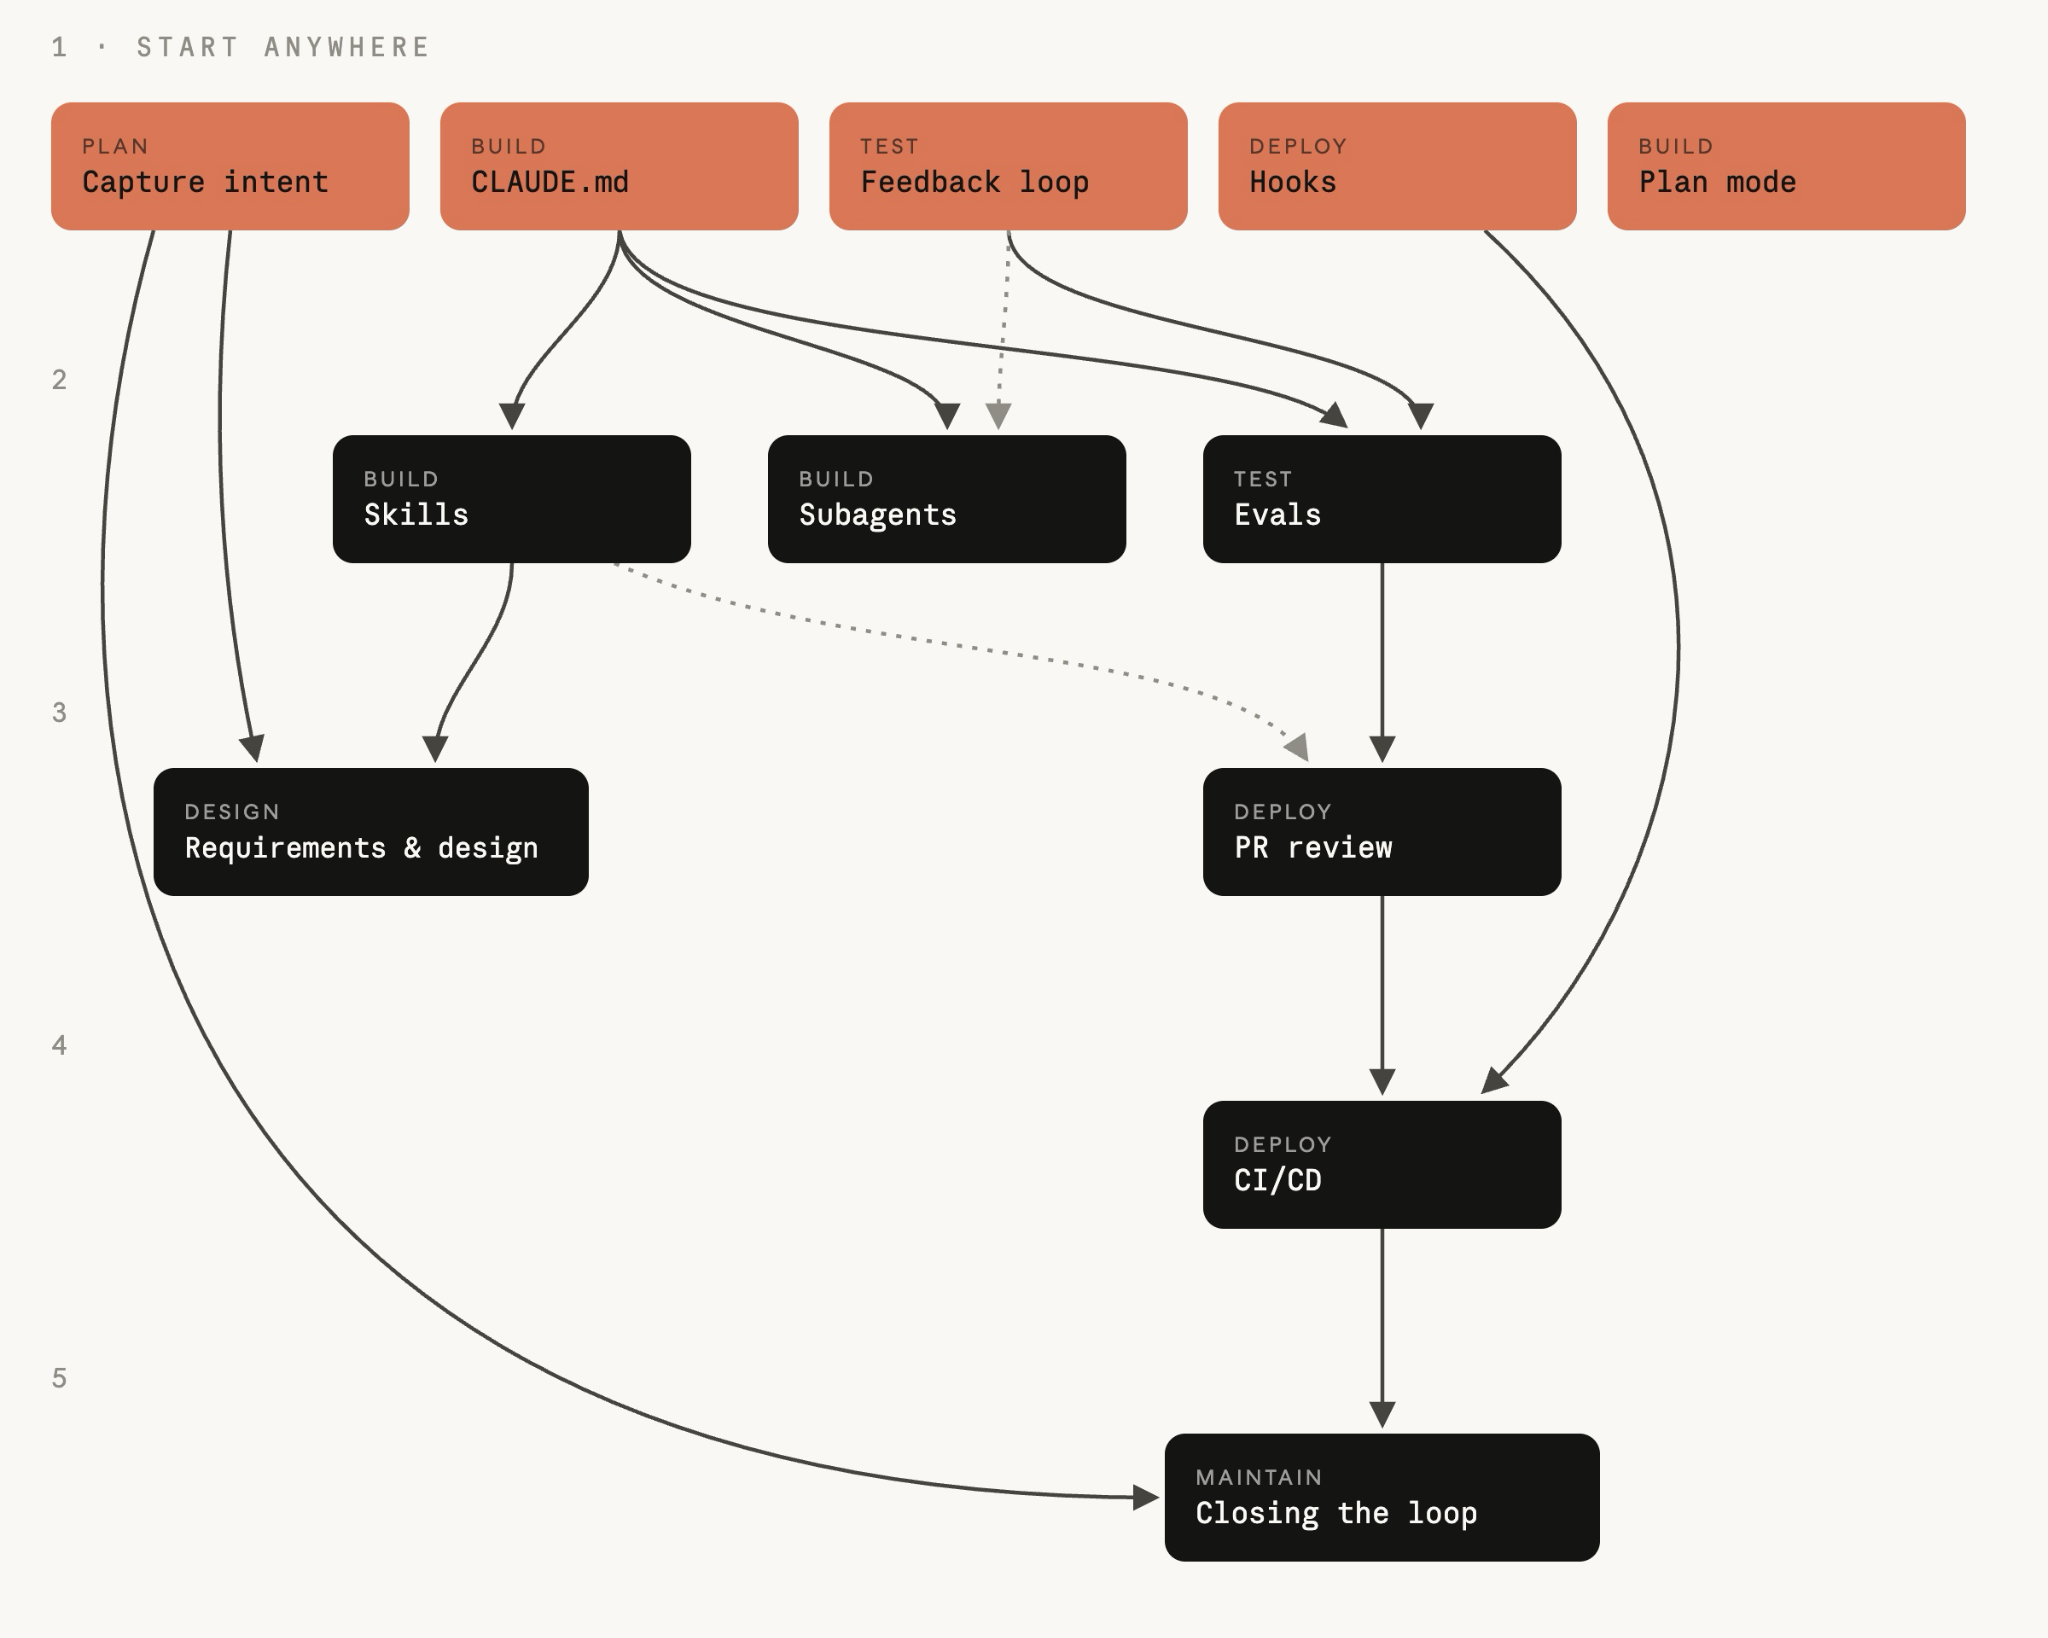
Les séquences constituent le cœur du guide et sont regroupées en six étapes non linéaires (planification, conception, développement, tests, déploiement et maintenance), qui couvrent l’intégralité du cycle de vie.
Chaque séquence présente :
- ce qui change ;
- par où commencer ;
- les étapes concrètes de mise en œuvre ;
- les considérations de gouvernance ; et
- la manière de mesurer les résultats.
Les étapes sont modulaires et les organisations peuvent transformer en priorité différentes phases à différents moments en fonction de leurs besoins propres. Chaque séquence indique ses dépendances dans la rubrique « Prérequis », également représentées dans le graphe de dépendances.
Une étape se termine par la validation d'un artéfact, et ce commit déclenche l'étape suivante. Un fichier intent.md accepté déclenche la phase consacrée aux exigences et l'approbation de la conception, un spec.md approuvé déclenche le mode plan, une PR fusionnée déclenche le pipeline et le dépassement d’un seuil de contrôle en production génère le prochain intent.md. La boucle se poursuit ainsi.
Tout d'abord, chaque étape est déclenchée manuellement. L’objectif final est d’aboutir à une boucle dans laquelle chaque artéfact accepté déclenche automatiquement le point de contrôle suivant. L'attention humaine se concentre alors sur ces points de contrôle : il s’agit d’examiner ce que l'agent a signalé, plutôt que de repartir de zéro à chaque étape.
Formaliser dans intent.md
Le fichier intent.md, qui lance le processus de développement logiciel, peut eêtre créé de plusieurs façons : une personne a une idée, un ticket est ouvert ou un incident est signalé via une alerte (voir Étape 6 : Maintenance).
Lorsqu'une personne a une idée, elle réfléchit avec Claude et produit une protospécification en markdown. Dans le SDLC traditionnel, cette même personne doit ensuite convaincre un membre de l'équipe produit de formaliser l'idée avec elle ou en son nom.
La proto-spécification générée par Claude est lisible par l'humain, versionnée et immédiatement exploitable pour l'étape suivante. Elle est enregistrée sous la forme d’un fichier intent.md.
Que l'intention provienne d'un vénement déclencheur ou d'un agent, le processus reste le même : le responsable produit relit et corrige le fichier intent.md rédigé par l'agent avant qu’il ne soit validé dans le système de gestion de versions.
La mise en place ne doit être effectuée qu’une seule fois par l’équipe plateforme ou d’ingénierie. Un membre de l'équipe technique doit créer l’espace partagé destiné au fichier d’intention et définir qui est autorisé à y écrire, puisque de nombreux contributeurs pourront venir de différents services de l’organisation.
Une fois le dépôt créé, les contributeurs ui ne maîtrisent pas Git n'ont pas besoin de’ lutiliser directement. Un connecteur vers le système de gestion de versions, par exemple GitHub, permet à Claude de valider les fichiers Markdown en leur nom depuis claude.ai ou Cowork.
Comment procéder
- La personne à l’origine de l’idée décrit le problème à Claude avec ses propres mots. Elle peut décrire ce qu'elle ne peut pas faire aujourd'hui, qui est concerné, à quoi ressemblerait une meilleure solution ou ce qui est hors périmètre. Aucun formalisme particulier n'est nécessaire.
- Échangez avec Claude jusqu’à ce que l’idée soit suffisamment concrète. Claude pose alors les questions qu'un analyste poserait : périmètre, utilisateurs, contraintes et critères de réussite.
- Demandez à Claude de rédiger le résultat dans un fichier
intent.mdà partir du modèle de l'organisation, qui peut être codé sous forme de skill configurée par un membre de l'équipe technique et validée par un responsable. Il peut notamment couvrir le problème, le résultat attendu, les utilisateurs et systèmes affectés, les contraintes et les questions en suspens. - La personne à l’origine de l’idée corrige tout ce que Claude aurait mal compris.
- Validez
intent.mddans l’espace partagé. L'auteur et l'horodatage sont ajoutés à l’historique, puis le responsable produit reprend l'idée à partir de là.
# Intent: claims status self-service
Author: J. Ortiz (claims operations). Status: draft.

## Problem
Customers phone the contact center to ask where their claim is.
Handlers spend roughly a third of call time on status-only queries.

## Proposed outcome
Customers see claim status, next step and expected date in the portal.

## Affected users and systems
Claims handlers, portal team, claims-core API.

## Constraints
No new PII in the portal session. Existing authentication only.

## Open questions
Do third-party loss adjusters need access too?
Considérations en matière de gouvernance
La preuve repose sur le fichier intent.md validé, qui répertorie l'auteur, l'horodatage et l'historique complet des révisions. Ces informations sont enregistrées dans l'historique git de l'espace partagé dédié à l’intention. Le responsable produit donne son approbation et la décision d'acceptation ou de rejet de l'intention, qui détermine son passage à l'étape 2 : conception, est enregistrée sous la forme d’une fusion ou de la clôture de la revue.
Exigences et conception
Une fois l’intention approuvée par le responsable produit, Claude reprend le fichier intent.md accepté et produit une spécification regroupant les exigences de conception. Cette étape est guidée par les skills de l'organisation en matière de marque, de sécurité, de conformité et d'UX.
Le responsable produit relit cette spécification, mais ne la rédige pas lui-même. L'objectif est de créer une spécification sur laquelle l'équipe d'ingénierie peut s’appuyer pour planifier le développement, avec les éventuels points de vigilance clairement signalés.
Le travail sur le front-end en est l'exemple le plus parlant. Une fois le fichier intent.md accepté, le responsable produit produit une maquette dans Claude Design (bêta) à partir du fichier intent.md, l’affine par itérations, puis l'exporte vers Claude Code pour passer au développement.
Comment procéder
- Le responsable produit ouvre une session dans laquelle les skills de l'organisation sont disponibles et y joint le document
intent.md. - Dans sa requête, il renvoie au fichier
intent.md, précise les contraintes et demandent que les points de vigilance soient signalés. Au départ, cette étape est exécutée manuellement, puis formalisée sous la forme d’une commande slash à l’échelle de l’organisation. Ensuite, l'acceptation de’intent.mddans l’espace partagé dédié à l’intentions devient le déclencheur : une tâche non interactive se lance lors de la fusion, exéute l’analyse avec les skills de l'organisation chargées et puis validespec.mdsous la forme d’une pull request. (La séquence CI/CD dans l'étape 5 : Déploiement décrit l’infrastructure nécessaire). À partir de là, la première intervention du responsable produit est la revue. - Le même responsable produit examine la spécification au regard de l'idée initiale. La spécification résout-elle le problème signalé et les questions en suspens dans
intent.mdont-elles été reçu une réponse ou ont-elles été reprises dans la suite du processus ? - Les points de vigilance signalés sont traités en priorité, car ils correspondent aux sujets qu’un analyste aurait fait remonter. Le responsable produit les résout un par un avec le responsable de la conformité avant que l'équipe d’ingénierie ne prenne connaissance de la spécification.
- Validez
spec.mdaux côtés deintent.md. La paire de fichiers consigne à la fois ce qui a été demandé et ce qui a été décidé. - Le responsable produit décide ensuitr si la spécification et l'intention peuvent passer à la phase de développement, en consultant un responsable technique pour tout élément classé comme présentant un risque plus élevé par l’organisation. Cette décision est toujours prise par un membre humain de l’équipe, et l’acceptation de la spécification déclenche la séquence du mode Plan de l’Étape 3 : Développement
À quoi elle ressemble (la requête)
Read the attached intent.md and produce a requirements and design spec for integrating it into our existing codebase. Apply the skills available to you so the plan conforms to our brand guidelines, security policies and UX standards. Document the spec fully as spec.md, ready to hand to the engineering team. Describe clearly any areas of concern, especially where you cannot satisfy contradicting policies.Considérations en matière de gouvernance
Au lieu d'être découverte plusieurs semaines plus tard lors d’une revue, la règle en vigueur est lue et appliquée pendant la rédaction de la spécification. Les skills de l'organisation s’appliquent alors comme des contraintes à respecter dans la spécification. La spécification, la requête qui l'a produite et les versions de skills en vigueur sont consignées dans le système de gestion des versions. Le responsable produit valide la spécification et transmet les points de vigilance signalés aux responsables de la règle désignés.
Le mode Plan de Claude Code comme point de départ par défaut
Les ingénieurs démarrent leurs sessions Claude Code en mode plan, transmettent à Claude le fichier spec.md approuvé à l'étape 2 : Conception puis le laissent les interroger afin d’affiner le plan par itérations jusqu’à ce qu’il leur convienne.
Comment procéder
- L'ingénieur démarre sa session avec Claude en mode plan.
- Il fournit à Claude les fichiers
intent.mdetspec.mdet lui demande d’élaborer un plan de mise en œuvre indiquant les fichiers à modifier, l'ordre des travaux et les tests permettant de valider les changements. - Il met ensuite le plan à l’épreuve en demandant ce que les changements pourraient perturber, quelle étape est la plus risquée et quelles autres options Claude a choisi d’écarter.
- Le plan est affiné par itérations jusqu’à ce qu’un ingénieur n’ayant pas assisté aux échanges puisse mettre en œuvre la modification en s’appuyant uniquement sur ce document.
- Le plan approuvé est validé sous la forme d’un fichier
plan.md. Il rejoint ainsi la piste d'audit, et la séquence de revues des PR (Étape 5 : Déploiement) vérifie ensuite que le diff final est conforme à ce plan. - Acceptez le plan et laissez Claude passer à l’implémentation. Avec un plan solide, l’implémentation peut souvent être réalisée en une seule passe.
- Lorsque l’implémentation s'écarte du plan, mettez à jour
plan.mddans le même commit. Vous pouvez envisager d'utiliser un hook pour imposer la synchronisation entre les deux.
À quoi ça ressemble (plan.md)
# Plan: claims status self-service (from intent.md 2026-06-02)

## Files that change
portal/src/claims/StatusPanel.tsx (new), claims-api/routes/status.py,
claims-api/tests/test_status.py

## Order of work
1. Add the status endpoint behind existing auth.
2. Panel against the endpoint.
3. Wire into the portal nav.

## Risks
The claims-core API rate-limits at 50 rps; the panel must cache.

## Proof
test_status.py covers the four claim states; screenshot matches the
approved mock.
Considérations en matière de gouvernance
La revue de conception intervient avant toute génération de code, à un stade où changer de direction consiste encore simplement à modifier un document. Le mode Plan impose lui-même cette procédure, puisque Claude ne peut modifier aucun fichier tant que l'ingénieur n'a pas accepté le plan. Le plan et ses différentes révisions sont consignés, de même que l’identité de la personne qui les a approuvés. Les modifications courantes sont validées par l'ingénieur, tandis que celles que l’organisation classe comme présentant un risque plus élevé sont confiées à un responsable technique ou à un architecte.
Claude Code en mode auto
Claude Code peut également fonctionner en mode auto : l'ingénieur approuve le plan puis, une fois celui-ci validé et affiné par itérations, Claude applique chaque modification sans exiger la rédaction d’une requête à chaque édition. À mesure que les garde-fous décrits dans les séquences suivantes à maturité (un fichierCLAUDE.md affiné, des skills qui encodent les règles, des hooks qui bloquent les actions dangereuses et une suite de tests que Claude peut exécuter), l'acceptation automatique devient le mode par défaut pour les tâches courantes : un fichier spec.md précis, un périmètre d’impact limité et du code déjà couvert par les tests.
On passe alors d’un modèle où l’utilisateur observe l’agent effectuer chaque modification et examine chacune de ses actions à un modèle où l’on vérifie les artefacts produits à l’issue de sessions autonomes plus longues. Le mode d'acceptation automatique facilite également le travail en parallèle, à l’échelle individuelle comme collective, lorsqu’il est utilisé avec des worktrees. Il joue ainsi un rôle central dans l’exécution autonome du SDLC et dans la fermeture de la boucle décrite à l’Étape 6 : Maintenance.
Le fichier CLAUDE.md
Le fichier CLAUDE.md donne à Claude le contexte dont un nouvel intervenant aurait besoin, en couvrant les conventions, les commandes, l'architecture et les erreurs les plus fréquemment rencontrées par l'équipe. Les connaissances qui se trouvaient auparavant dans la tête des collaborateurs ou dans des wikis deviennent un fichier que l’agent lit au début de chaque session, tenu à jour par l’ensemble de l’équipe et enrichi chaque fois qu’une erreur est commise.
Comment procéder
- Exécutez
/initdans le dépôt. Claude génère un premier fichierCLAUDE.mdà partir de ce qu'il trouve. - Réduisez ensuite ce fichier à ce dont un nouveau membre de l’équipe aurait besoin dès son premier jour. Conservez les commandes de build, de test et de lint, les conventions importantes et les points sur lesquels Claude se trompe régulièrement.
- Ajoutez
CLAUDE.mdau dépôt git, à la racine du projet, afin que toute l’équipe partage la même version et que ses modifications soient relues comme du code. - Une règle de travail peut être utile. Lorsque Claude commet deux foi la même erreur, ajoutez la correction à
CLAUDE.md. - Limitez le fichier à une page environ, car Claude le lit intégralement au début de chaque session. Toute information obsolète est inutile au contexte.
À quoi ça ressemble (CLAUDE.md)
# Payments service

## Commands
- Build: make build
- Test: make test (unit), make itest (integration, needs docker)
- Lint: make lint (runs in CI; fix before pushing)

## Conventions
- Java 21, Spring Boot 3. No new Lombok.
- Money is always BigDecimal, never double.
- Every endpoint needs an integration test in src/itest.

## Architecture
- api/ holds REST controllers, core/ holds domain logic,
  adapters/ talks to external systems.
- Kafka events are defined in schemas/; never edit generated classes.

## Things Claude gets wrong
- Do not bump dependency versions; the platform team owns them.
- The legacy v1/ package is frozen; changes go in v2/.
Considérations en matière de gouvernance
CLAUDE.md est versionné,ce qui permet d’examiner et d’auditer les instructions sur lesquelles l’agent s’appuie. Les conventions de’ l’équipe sont appliquées au moyen de ce fichier, chaque modification est consignée dans l’historique Git et les responsables du code approuvent ces changements lors de la revue des PR.
Les skills comme savoir d’une institution ou entreprise
Les skills permettent à une organisation de rendre son savoir institutionnel directement exploitable. Les instructions sont explicites, versionnées, appliquées à grande échelle et mises à jour de manière centralisée lorsque les règles évoluent. Règle générale : créez une skill pour tout savoir institutionnel à appliquer de manière cohérente ; n’en créez pas pour les éléments qui relèvent plutôt de CLAUDE.md ou d’une requête.
Comment procéder
- Choisissez un élément de connaissance qui n'est pas appliqué de manière cohérente aujourd'hui. Il peut s'agir d'une norme de sécurité, d'une convention de conception d'API ou d'une règle de marque.
- Formalisez-le sous la forme d’une skill : un dossier contenant un fichier
SKILL.mddont le frontmatter précise quand il doit se déclencher et dont le contenu indique quoi faire. Un ingénieur rédige la skill à partir de la source de référence du titulaire de la règle, avec l'aide de Claude. - Placez la skill dans le dépôt, sous
.claude/skills/<name>/pour qu'elle soit distribuée avec le code, ou déployez-la à l’échelle de l'organisation via un plug-in - Vérifiez que la skill se déclenche. Demandez à Claude d'effectuer la tâche concernée de différentes manières et de confirmer que la skill est chargée à chaque fois.
- Lorsque la règle évolue, mettez à jour la skill et faites valider le changement par le responsable de cette règle.
- Les ingénieurs récupèrent automatiquement la nouvelle version lors de leur session suivante.
À quoi ça ressemble (.claude/skills/secure-api-review/SKILL.md)
---
name: secure-api-review
description: Apply the API security standard. Use whenever creating or
  modifying an external-facing endpoint, reviewing API code, or
  generating an OpenAPI spec.
---
# Secure API review

When you create or change an API endpoint:
1. Authentication: every endpoint requires the gateway JWT;
   no anonymous routes outside /health.
2. Input validation: validate request bodies against the OpenAPI
   schema and reject unknown fields.
3. Audit: every state-changing endpoint emits an audit event with
   actor, action, entity and timestamp.
4. Data classification: fields tagged pii in the schema must never
   appear in logs or error messages.

Run scripts/check-endpoints.sh and include its output in your summary.
Considérations en matière de gouvernance
Une skill constitue bien un mécanisme de contrôle, mais de nature consultative. Elle augmente la probabilité que Claude applique la règle pendant l’écriture du code, sans toutefois garantir qu’une session s’y conformera. Lorsqu’une règle doit impérativement être respectée, il faut compléter la skill par un mécanisme déterministe, par exemple un hook qui bloque l’action ou une étape de revue qui vérifie à nouveau la conformité de la politique au niveau de la PR. La skill rend les violations rares ; le hook les rend quasi impossibles. Les déclenchements de skills sont enregistrés dans les traces de session, et le responsable de la règle examine les modifications de skills de la même manière que du code.
Les hooks comme garde-fous pendant le développement
Une skill constitue un contrôle consultatif, tandis qu'un hook représente la couche déterministe qui vient le renforcer. La plupart des actions de Claude consistant, pendant l’implémentation, à modifier des fichiers et à exécuter des commandes shell, c’est au cours de la phase de développement que les hooks sont susceptibles de se déclencher le plus souvent.
Les hooks utilisés pendant le développement peuvent notamment :
- Bloquer les modifications de chemins protégés comme des classes générées ou un package figé ;
- Exécuter automatiquement le formateur et le linter après chaque modification de fichier, afin d’éviter toute dérive ;
- Empêcher l’inclusion d’identifiants ou de secrets dans le diff.
Toute skill correspondant à une règle qui doit être respectée sans exception doit être adossée à un tel mécanisme. Un hook s’exécute à chaque action correspondante ; les hooks de la phase de développement doivent donc être rapides et limités au fichier modifié. Les contrôles plus lourds, comme l’exécution de l’ensemble de la suite de tests, ont davantage leur place au moment du commit ou de la PR.
Un hook qui demande l’approbation d’un humain relève plutôt des points de contrôle de l’Étape 5 : Déploiement. Une demande de validation humaine pendant le développement remettrait en effet une personne sur le chemin critique de toutes les sessions exécutées en parallèle.
Sessions parallèles et sous-agents
Un même ingénieur peut piloter plusieurs flux de travail simultanément.
Une session parallèle est une autre instance complète de Claude Code, qui travaille sur une tâche distincte dans son propre worktree git. Chaque session indépendante ignore tout des autres ; leur seul point commun est l’ingénieur qui les pilote.
Un sous-agent s'exécute au cours d'une même session comme un assistant spécialisé, avec sa propre fenêtre de contexte et des limites d'outils spécifiques. Il convient particulièrement aux tâches récurrentes dans plusieurs types de travaux, par exemple vérifier que l'application fonctionne comme prévu.
Les sessions parallèles augmentent le nombre de tâches qu'un ingénieur peut mener de front, tandis que les sous-agents permettent à chaque session de rester concentrée sur sa propre tâche. Le rôle de l'ingénieur consiste alors à les diriger et à examiner leur travail.
Comment procéder
- L'ingénieur répartit le travail en tâches portant sur des fichiers différents, en s’appuyant sur le plan issu de la séquence en mode plan (Étape 3 : Développement) pour identifier les parties indépendantes. Les tâches qui modifient les mêmes fichiers sont exécutées dans une seule session, les unes après les autres.
- Chaque tâche parallèle dispose de son propre worktree, par exemple
claude --worktree feature-authdans un terminal etclaude --worktree fix-rate-limitdans un autre. Un worktree est une copie de travail distincte, associée à sa propre branche, qui évite que plusieurs ne modifient les fichiers en même temps. - Deux ou trois sessions constituent un point de départ raisonnable. Dans la pratique, la limite dépend du nombre de flux de travail qu’une même personne peut réellement examiner correctement : n’ajoutez des sessions que tant que la revue suit le rythme.
- Transformez les tâches récurrentes en sous-agents, définis dans les fichiers markdown sous
.claude/agents/. Chaque sous-agent doit avoir un nom, une description de son utilisation et les outils auxquels il peut toucher. Il peut s’agir, par exemple, d’un agent chargé de simplifier le code en supprimant la complexité inutile après le passage de l’agent principal, d’un agent de vérification qui exécute l’application et contrôle son comportement, ou encore d’un agent de recherche qui explore la base de code et restitue ses conclusions sans surcharger le contexte principal. Ajoutez ces définitions à Git afin qu’elles soient partagées par toute l’équipe.
À quoi ça ressemble (.claude/agents/verifier.md)
---
name: verifier
description: Runs the app and checks the change works before the session
  reports done
tools: Bash, Read
---
Start the app with make run. Exercise the changed behavior and the two
nearest neighboring flows. Report what you ran, what you saw, and any
behavior that does not match plan.md. Do not fix anything; report only.
Considérations en matière de gouvernance
Plus le nombre de sessions augmente, plus le volume de production s’accroît. Les mécanismes de contrôle doivent donc être définis dans la configuration du dépôt. Les hooks et les paramètres d’autorisation qui y sont configurés s’appliquent à toutes les sessions, et les actions réalisées au cours de chacune sont consignées et attribuées à l’ingénieur qui l’a lancée.
Donnez à Claude une boucle de rétroaction
Donnez toujours à Claude un moyen de vérifier son propre travail, qu'il s'agisse de tests, d'une buils ou d'une comparaison de captures d'écran. Une session contrôle ainsi elle-même son propre travail et corrige ses propres erreurs avant qu'un ingénieur ne les examine.
Il ne faut pas confondre cette boucle de rétroaction avec un sous-agent de vérification (Étape 3 : Développement). La boucle de rétroaction s‘exécute tout au long de la tâche autant de fois que nécessaire pendant le travail. Le sous-agent de vérification, en revanche, constitue une façon d’effectuer le contrôle final : il intervient une fois que la session estime le travail terminé, dans une nouvelle fenêtre de contexte. Ainsi, le verdict n'est pas influencé par les hypothèses qui ont conduit à la production du code.
Comment procéder
- Si la vérification du travail nécessite aujourd’hui une suite de commandes et une certaine connaissance de l’environnement, regroupez-la dans une seule cible, par exemple « make test » ou « npm test » qui renvoie un code de sortie non nul en cas d'échec.
- Dans la section Commandes de
CLAUDE.md, répertoriez chaque commande et fournissez un exemple de sortie indiquant que tout fonctionne correctement. - Définissez un objectif mesurable afin que Claude puisse vérifier son travail sans avoir à vous solliciter. Par exemple : « Tous les tests de test_status.py réussissent », « la capture d'écran correspond à la maquette jointe » ou « l’endpoint renvoie un statut 200 avec le nouveau champ ».
- Pour les corrections de bugs, commencez par écrire le test qui échoue. Demandez à Claude de reproduire le bug sous forme de test, de l'exécuter et de confirmer qu'il échoue pour la raison attendue. Validez ce test. Ce n’est qu’après cela que vous demandez à Claude de faire en sorte qu’il réussisse sans modifier le test, la restriction étant imposée par le hook sur les fichiers de test décrit à la dernière étape. Un test créé avant la correction, et que l’agent n’a pas pu réécrire, constitue une preuve que le bug a bien été corrigé.
- Pour les travaux d'interface, fermez la boucle avec un contrôle visuel. Donnez à Claude accès à un navigateur ou un outil de capture d'écran, fournissez-lui laa maquette puis laissez-le itérer : implémenter, capturer, comparer, ajuster. Deux ou trois cycles sont courants et le résultat devrait s'améliorer à chaque itération.
- Intégrez la vérification à la définition de « terminé ». Cette consigne doit figurer dans
CLAUDE.md. Exécutez les tests avant de déclarer une tâche terminée et affichez leur sortie. - Enfin, la boucle elle-même doit être protégée, car un agent qui corrige du code ne doit pas pouvoir affaiblir les contrôles appliqués à ce code. Un hook qui bloque les modifications pour des fichiers de test pendant une tâche de correction remplit ce rôle. Une autre solution consiste à vérifier le diff lors de la revue et de rejeter toute modification qui touche à un test.
À quoi ça ressemble (bloc de vérification CLAUDE.md)
## Verifying your work

- Build: make build (must finish with "Build succeeded")
- Test: make test (all green; never skip or delete a failing test)
- Lint: make lint (zero warnings)

Run all three before reporting any task complete, and paste the output.
If a test fails, fix the code, not the test.Évaluations continues dans la CI
Les évaluations sont l'équivalent, dans un SDLC fondé sur l'IA, des contrôles qualité réalisés à chaque jalon. Concrètement, il s’agit d’une suite d’évaluations exécutée chaque fois que la configuration de l’agent est modifiée. Lorsqu'un nouveau modèle est déployé ou qu'une requête est réécrite, cette suite permet de vérifier que l'agent continue d’effectuer le travail selon le même niveau d’exigence.
Ces évaluations doivent être considérées comme une suite évolutive. À mesure que les modèles progressent, certains cas qui permettaient autrefois de les différencier cessent d’être discriminants ; il faut alors en ajouter de nouveaux.
Selon le cas d'usage, certaines équipes peuvent préférer exécuter ces évaluations hors ligne, selon une fréquence définie, plutôt qu'à chaque modification. Les étapes ci-dessous concernent les évaluations continues.
Comment procéder
- L'ingénieur plateforme rassemble entre 20 et 50 tâches réelles issues de travaux récents, accompagnées du résultat attendu ou validé.
- Chaque tâche est rédigée sous forme d’une évaluation, c’est-à-dire une requête assortie des contrôles qui définissent un résultat acceptable (tests réussis, lint sans erreur, comportement inchangé, respect des règles).
- La suite d’évaluations s’exécute automatiquement dans la CI, sans intervention humaine, selon une fréquence définie et à chaque modification de
CLAUDE.md, des skills ou des hooks. Cette configuration pilotant le comportement de l’agent, elle doit faire l’objet des mêmes tests de régression que le code. - Les modifications de configuration des contrôles sont conditionnées aux résultats. Toute modification d’une skill qui fait baisser le taux de réussite doit être examinée avant d’être fusionnée.
- Chaque incident en production donne lieu à une nouvelle évaluation, rédigée par l’équipe responsable de l’incident, puis conservée dans la suite comme test de non-régression.
À quoi ça ressemble (.github/workflows/agent-evals.yml)
name: Agent evals
on:
  pull_request:
    paths: ['CLAUDE.md', '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: Run eval suite
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
Considérations en matière de gouvernance
Les évaluations fournissent à l'assurance qualité un point de contrôle capable de suivre le rythme des productions des agents. Le seuil de réussite est appliqué comme condition de fusion, les exécutions sont consignées afin de comparer les résultats dans le temps, et l'équipe responsable de la modification de configuration en assure l’approbation.
L'IA dans la boucle de revue des PR
Claude intervient des deux côtés de la revue. Il examine les PR entrantes au regard des règles de l'organisation et traite les commentaires de revue portant sur ses propres PR. Les ingénieurs peuvent ainsi concentrer leur attention sur le comportement du code lors de la revue, c’est-à-dire essentiellement sur l’intention et le niveau de risque.
Comment procéder
- Le service Code Review est le moyen le plus rapide de commencer. Un administrateur l'active et sélectionne les dépôts concernés. Si vous avez besoin de garder la maîtrise du pipeline ou de faire transiter les appels API par votre propre contrat cloud, exécutez la revue dans votre CI avec claude-code-action (la séquence CI/CD décrit l’architecture nécessaire).
- Le responsable technique rédige la politique de revue dans un fichier
REVIEW.mdplacé à la racine du dépôt. Ce fichier est organisé selon les axes de contrôle importants pour l’organisation : bugs et erreurs logiques ; sécurité et vulnérabilité ; conformité avec la spécificationspec.mdissue de la séquence consacrée aux exigences), le plan d’implémentation (plan.mdde la séquence en mode plan) et les principes de conception.REVIEW.mdprécise également ce qui doit être considéré comme Important plutôt que comme un simple Nit, ainsi que les éléments à ignorer. - Le responsable technique définit le seuil nécessitant une intervention humaine. Les constats issus de la revue ne suffisent pas, à eux seuls, à approuver ou bloquer une PR, et les règles de protection de branche continuent d’exiger l’approbation d’un responsable du code. Si un ingénieur plateforme souhaite conditionner la fusion aux résultats de la revue, il peut exploiter le nombre de constats par niveau de gravité publié par le contrôle sous une forme lisible par machine.
- Lorsqu'un réviseur ou l'auteur tague
@claudedans un commentaire de revue, Claude traite ce commentaire et force la correction. Le fil de PR conserve la trace de la demande comme de la modification. Cette boucle de corrections passe par claude-code-action. Dans le service géré, le commentaire@claude reviewdemande une nouvelle revue à la place. Pour les PR ouvertes par Claude, il est possible d’aller plus loin et de le laisser suivre la PR jusqu’à la fusion. Certaines équipes encapsulent cette boucle dans une commande slash personnalisée qui parcourt les commentaires de revue non résolus et les contrôles en échec, les traite, pousse les corrections, puis recommence jusqu’à ce que la PR soit au vert et n’attende plus que l’approbation du responsable du code. - Les constats issus des revues alimentent
CLAUDE.md. Lorsqu’une même erreur est signalée pour la deuxième fois, sa correction est ajoutée àCLAUDE.mddans le cadre de cette revue. Comme la revue lit elle-mêmeCLAUDE.md. Cette erreur peut être détectée à partir des PR suivantes. La revue signale également lorsqu'une modification rendCLAUDE.mdobsolète. - Une fois par mois, le responsable technique affine le dispositif en évaluant la qualité des constats afin d’améliorer le reviewer et en limitant le volume de Nit dans
REVIEW.md. Les chemins générés et tout ce qui est déjà contrôlé par la CI sont exclus.
À quoi ça ressemble (REVIEW.md)
# Review instructions

## Passes
Run three passes and tag each finding with its pass:
- Bugs: logic errors, broken edge cases, subtle regressions
- Security: injection risks, authentication gaps, PII in logs
- Compliance: the change matches spec.md, plan.md and our design principles

## What Important means here
Reserve Important for findings that would break behavior, leak data
or breach a policy. Style and naming are nits.

## Cap the nits
Report at most five nits per review; summarize the rest as a count.

## Do not report
Generated files under src/gen/ and anything CI already enforces.
Considérations en matière de gouvernance
La séparation des responsabilités est préservée, car l'agent qui a écrit le code n'a aucun moyen de l'approuver. La règle de revue définie dans REVIEW.md s'applique à toutes les PR, et les constats, corrections, évaluations et approbations sont consignés dans l'historique de la PR, qui fait ainsi office de piste d'audit. L'approbation est donnée par un humain via les règles de protection de branche, en s’appuyant sur les constats de la revue.
Pour voir comment ces contrôles s’articulent à l'échelle de la production, consultez la sécurisation d'un SDLC fondé sur l’IA chez Anthropic.
Les hooks comme points de validation
Pendant la phase de développement, les hooks servent de garde-fous : ils autorisent ou bloquent certaines actions sans intervention humaine (Étape 3 : Développement). Un hook peut également demander une approbation et suspendre l’action jusqu’à ce qu’elle soit validée par une personne précise, ce qui correspond au fonctionnement attendu pour les points de contrôle avant mise en production.
Cette séquence figure à l'étape 5 : Déployement, car le contrôle préalable à la mise en production en est l’exemple le plus évident. Mais les hooks ne sont pas propres au déploiement : ils s’exécutent partout où Claude agit. Ils peuvent, par exemple, bloquer les modifications de migrations ou d’infrastructure en l’absence de ticket de changement pendant l’Étape 3 : Développement, ou empêcher l’agent de modifier les fichiers de test pendant une tâche de correction à l’Étape 4 : Tests.
Comment procéder
- La direction de l’ingénierie, en coordination avec les équipes de gestion du changement et de conformité, recense les points de validation humaine qui doivent être maintenus, par exemple l’approbation de la gestion des changements, l’autorisation de mise en production ou les modifications de chemins protégés.
- L’ingénieur plateforme traduit chacun de ces points de contrôle en hook, c’est-à-dire d’un script exécuté avant l’action de Claude et capable de l’autoriser, de demander une approbation ou de la bloquer.
- Les hooks propres à l’équipe sont définis dans
.claude/settings.jsonet versionnés dans git. Les hooks non négociables sont placés dans des paramètres gérés par l’équipe plateforme ou l’administrateur informatique, de façon à ce que les ingénieurs ne puissent pas les désactiver individuellement. - Un blocage doit être explicite : lorsqu’un hook interrompt une action, Claude doit indiquer dans sa sortie la raison du blocage ainsi que la procédure à suivre pour obtenir l’approbation nécessaire.
À quoi ça ressemble (.claude/settings.json)
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "Bash",
          "hooks": [
            { "type": "command",
              "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
          ]
        }
      ]
    }
}
Et le point de contrôle en tant que tel (.claude/hooks/production-gate.sh)
#!/bin/bash
# Production deploys require a named release authorization
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
   if [ -z "$RELEASE_APPROVAL" ]; then
     echo "Production deploys need a release authorization." >&2
     exit 2 # exit 2 blocks the action; the message goes to Claude
   fi
fi
exit 0
Considérations en matière de gouvernance
Les hooks servent de points de contrôle d'approbation. La condition du point de contrôle s'applique systématiquement, à tout le monde. Chaque décision d'autorisation ou de blocage est journalisée et horodatée. Le point de contrôle définit aussi ce qui vaut approbation : un ticket de changement approuvé ou la validation du responsable des mises en production, par exemple.
Intégration CI/CD et déploiement
Isolez l’exécution de Claude Code dans un environnement sécurisé afin que les agents de longue durée puissent fonctionner sans risque, exposez les opérations de déploiement via des intégrations MCP et testez les procédures de retour arrière avant même que l’agent n’ait à les utiliser.
Comment procéder
- L'ingénieur plateforme commence par des étapes d’analyse en lecture seule. Utilisez
claude -pdans une tâche du pipeline pour diagnostiquer un build en échec, résumer un test instable ou préparer le journal des modifications. - Ajoutez ensuite des étapes avec droits d’écriture derrière les points de contrôle existants, par exemple pour corriger des erreurs de lint, mettre à jour de la documentation générée ou traiter des commentaires de revue via les mentions
@claude. Tout ce que l'agent écrit passe par une PR soumise aux règles de protection de branche, et l’agent ne dispose d’aucun moyen de pousser directement vers main. - L'exécution est isolée dans un environnement sécurisé. Les tâches de l’agent s’exécutent dans des conteneurs soumis à une politique réseau, avec des jetons à durée de vie courte et à portée limitée, sans identifiants de production par défaut.
- Exposez le déploiement via MCP. Les opérations de déploiement, de consultation d’état et de retour arrière deviennent des outils, limités à chaque environnement. Les capacités de déploiement de l’agent reposent ainsi sur une liste d’actions autorisées, plutôt que sur un script shell contenant des identifiants.
- Adaptez le niveau d’autonomie en fonction de l’environnement. En développement, l'agent peut déployer librement. En production, il prépare la mise en production, mais celle-ci doit être autorisée par le responsable des releases, un hook faisant respecter ce point de contrôle. L’environnement de staging se situe entre les deux.
- Le retour arrière doit être la procédure la plus éprouvée du pipeline : une commande unique que l’agent peut exécuter et qui est régulièrement testée en staging. La séquence de fermeture de la boucle (Étape 6 : Maintenance) déclenche ce retour arrière lorsqu’un seuil de contrôle est dépassé ; son bon fonctionnement doit donc avoir été vérifié à l’avance.
À quoi ça ressemble (étape du pipeline)
- name: Triage failed build
  if: failure()
  run: >
    claude -p "Read the build log at out/build.log. Identify the most
    likely cause, say whether the failure looks flaky or real, and write a
    three-line summary for the PR thread." >> triage.md
Considérations en matière de gouvernance
Le principe directeur est le suivant : l'agent peut agir jusqu'au point de contrôle de production, mais il ne peut pas le franchir. Les contrôles ci-dessous permettent de faire respecter ce principe.
- La protection des branches fait en sorte que tout ce que l’agent écrit passe par une PR, sans possibilité de pousser directement vers main.
- Le hook de déploiement en production bloque la mise en production tant qu’un responsable des releases désigné ne l’a pas autorisée. Chaque exécution non interactive agit sous l'identité propre de l'agent, ce qui permet au journal du pipeline de distinguer les actions de l'agent et celles de l'ingénieur qui a déclenché l’exécution.
- Des niveaux d’autorisation propres à chaque environnement déterminent jusqu’où l’agent peut agir avant d’atteindre ce point de contrôle.
Maintenance et fermeture de la boucle
Jusqu'ici, nous avons vu comment ajouter Claude à chaque étape du SDLC, chacune nécessitant qu’un humain lance les premières actions. Cette étape change toutefois de logique : elle vise à faire fonctionner Claude de manière autonome afin de fermer la boucle.
Par exemple, un agent de surveillance exécuté en continu pourrait, à partir de l'ouverture dun ticket de bug, créer un fichier intent.md puis enchaîner automatiquement les phases d’exigences, de planification, de développement, de tests et de revue. L’Étape 6 : Maintenance s’exécute alors sans interface interactive, avec entre chaque phase un point de contrôle indépendant fondé sur un niveau de confiance : un contrôle déterministe ou un agent de revue contradictoire décide si le résultat de l’étape précédente peut poursuivre son chemin ou doit être transmis à un humain.
Fermer la boucle
Un script déterministe surveille la production et déclenche Claude lorsqu'un seuil de contrôle est dépassé. La détection de ce type de dépassement constitue un bon exemple du fonctionnement d’une boucle exécutée de manière autonome, tandis que la section Claude Tag (bêta publique), à la fin de cette étape, traite des tâches qui arrivent par différents canaux.
Comment procéder
- Le responsable du service ou l'ingénieur plateforme choisit une métrique disposant d’une référence glissante stable, par exemple le taux d'échec des tests CI, le taux d’erreurs 5xx après déploiement ou la durée du cycle des PR.
- Il rédige le script de détection, généralement fondé sur la moyenne et l'écart-type calculés sur une fenêtre glissante, avec des règles de contrôle (Western Electric ou équivalent) afin que les seuils détectent aussi bien les dérives progressives que les pics. Le script est versionné et couvert par des tests unitaires, et la détection reste entièrement déterministe, sans intervention d’un modèle.
- Les niveaux de réponse sont définis dans une configuration versionnée (
bands.yamlci-dessous). Au niveau 1σ, le script se contente de consigner l’événement ; au niveau 2σ, il invoque Claude en lecture seule pour établir un diagnostic et au niveau 3σ, Claude peut agir, mais uniquement en ouvrant une PR soumise au point de contrôle de revue ou en déclenchant une procédure préapprouvée. - La couche de déclenchement peut être un workflow planifié dans GitHub ou GitLab, un webhook provenant de la solution de supervision existante ou une tâche Cron exécutée au sein du réseau. Claude fonctionne sans état, soit sous la forme d’une étape non interactive sur un runner CI, soit comme service Agent SDK dans un conteneur isolé. La séquence CI/CD décrit les options de déploiement et d’accès au modèle. Comme l’exécution est sans état et non interactive, une boucle peut commencer et se terminer sans intervention humaine.
- L’agent consigne son diagnostic dans un fichier
intent.mdau de l’format Étape 1 : Planification, en décrivant l’anomalie et les éléments qui l’étayent, le résultat proposé, les systèmes concernés et les éventuelles questions en suspens. À partir de là, le constat suit le pipeline comme n’importe quel autre élément. - Le responsable du service ou l’ingénieur d’astreinte trie la file et transmet au responsable produit les constats ayant un impact sur le produit. Trois options : corriger immédiatement, planifier ou classer sans suite. Les classements sans suite servent à ajuster les seuils et à réduire le bruit.
- Lorsqu’un correctif est déployé, ajoutez une évaluation correspondant à l’incident (voir la séquence sur les évaluations continues) afin d’éviter qu’un problème similaire ne se reproduise.
À quoi ça ressemble (par exemple, un bands.yaml surveillant le taux d'échec aux tests CI)
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: { action: log }
  2sigma: { action: diagnose,
            tools: "Read,Grep,Bash(gh run view *)" }
  3sigma: { action: propose,
            routes: [pull_request, runbook:rollback-deploy] }
Considérations en matière de gouvernance
Les limites entre les différents niveaux sont définies et appliquées à partir d’une configuration versionnée, tandis que les autorisations et les paramètres gérés interdisent tout accès à la production. Les déclenchements, constats et décisions de triage sont consignés avec leur horodatage. Un responsable de service examine et approuve les constats ; les modifications qui en découlent suivent ensuite le circuit habituel de revue des PR, et les procédures que l’agent est autorisé à déclencher ont été approuvées au préalable.
Exemples
- Lorsque le taux d’échec des tests CI dépasse le seuil de 3σ, l’agent met le test instable en quarantaine ou ouvre une PR de retour arrière, puis le point de contrôle de revue tranche.
- Lorsque le taux d’erreurs 5xx après déploiement dépasse 3σ et qu’un déploiement a eu lieu dans la fenêtre considérée, l’agent déclenche le pipeline de retour arrière existant.
- Lorsque la durée du cycle des PR déclenche une règle de dérive, l’agent rédige un rapport à l’attention de la direction de l’ingénierie, montrant que ce dispositif fonctionne aussi bien pour les métriques de processus que pour les métriques de production.
Analyses récurrentes de la base de code
Une analyse de sécurité ne fournit qu’un état des lieux ponctuel d’une base de code avec un modèle donné, et ces deux dimensions deviennent rapidement obsolètes : le code évolue chaque semaine, tandis que chaque nouvelle génération de modèles détecte des vulnérabilités que la précédente avait pu manquer. Dans un SDLC fondé sur l’IA, la réponse consiste donc à exécuter ces analyses de façon planifiée, sans intervention humaine pour les déclencher, puis à faire passer les résultats par les mêmes points de contrôle que toute autre modification apportée à la base de code.
Claude Security est la version hébergée de ce type d’analyse planifiée. Il suffit de connecter un dépôt GitHub : les analyses s’exécutent sur Claude Mythos @5 dans l’infrastructure d’Anthropic, chaque constat est validé avant d’être signalé et assorti d’un niveau de confiance. Les correctifs suggérés sont examinés et appliqués dans Claude Code sur le web. L’organisation reçoit ainsi les résultats sans avoir besoin d’accéder directement au modèle.
Comment procéder
- Le responsable de la sécurité connecte les dépôts et les organise en projets par dépôt, service ou équipe, de sorte que la responsabilité des résultats soit claire dès le départ.
- Lancez une première analyse complète des dépôts les plus critiques, y compris ceux qui ont déjà été analysés par d’autres outils ou par des modèles antérieurs. Considérez cette première analyse comme le point de référence. Elle fera probablement ressortir des problèmes dans du code jusque-là considéré comme sain.
- Définissez une fréquence d’analyse par projet. Une analyse hebdomadaire constitue un bon point de départ pour les services activement développés ; pour les dépôts volumineux ou hétérogènes, limitez l’analyse à un répertoire ou à une branche.
- Triez les constats en tenant compte du niveau de confiance. Lorsqu’un constat est écarté, indiquez-en la raison afin que cette décision soit enregistrée et que le même problème ne réapparaisse pas comme nouveau lors de l’analyse suivante.
- Pour un constat bien délimité, ouvrez le correctif suggéré dans Claude Code sur le web, examinez-le, puis faites-le passer par le point de contrôle de revue des PR comme n’importe quelle autre modification. L'agent qui a proposé le correctif ne dispose d’aucun moyen pour l'approuver lui-même.
- Pour tout problème dépassant le cadre d’un correctif ponctuel, par exemple une faiblesse architecturale ou un schéma récurrent dans plusieurs services, formalisez-le dans un fichier
intent.mdau formatde l’Étape 1 et faites-le repartir depuis la phase de planification. - Lorsqu’un correctif est déployé en production, ajoutez à la suite une évaluation correspondant à la classe de vulnérabilité concernée, conformément à la séquence sur les évaluations continues. La configuration qui pilote l’agent sera ainsi testée contre cette classe de vulnérabilité à l’avenir.
- Exportez les constats au format CSV ou Markdown, ou utilisez des webhooks, afin que les outils de suivi et d’audit existants de l’organisation restent le système de référence, là où les auditeurs s’attendent déjà à trouver ces informations.
Considérations en matière de gouvernance
Les analyses s’exécutent sous le contrôle administratif de l’organisation : les dépôts connectés, les personnes autorisées à utiliser le service d’analyse et la limite de dépenses sont tous définis de manière centralisée. Chaque constat comporte un résultat de validation et un niveau de confiance, et chaque rejet est assorti d’une justification. L’historique des analyses constitue ainsi une piste d’audit indiquant ce qui a été détecté, corrigé ou accepté en connaissance de cause.
Les correctifs n’atteignent la production qu’en passant par le point de contrôle de revue des PR et les règles de protection de branche, et non directement depuis l’analyse. Claude Security vient compléter l'analyse statique et l'analyse des dépendances existantes. Les contrôles déterministes restent dans la CI, tandis que l'analyse pilotée par le modèle couvre les vulnérabilités dépendantes du contexte que ces contrôles ne sont pas conçus pour détecter.
Claude d'astreinte avec Claude Tag
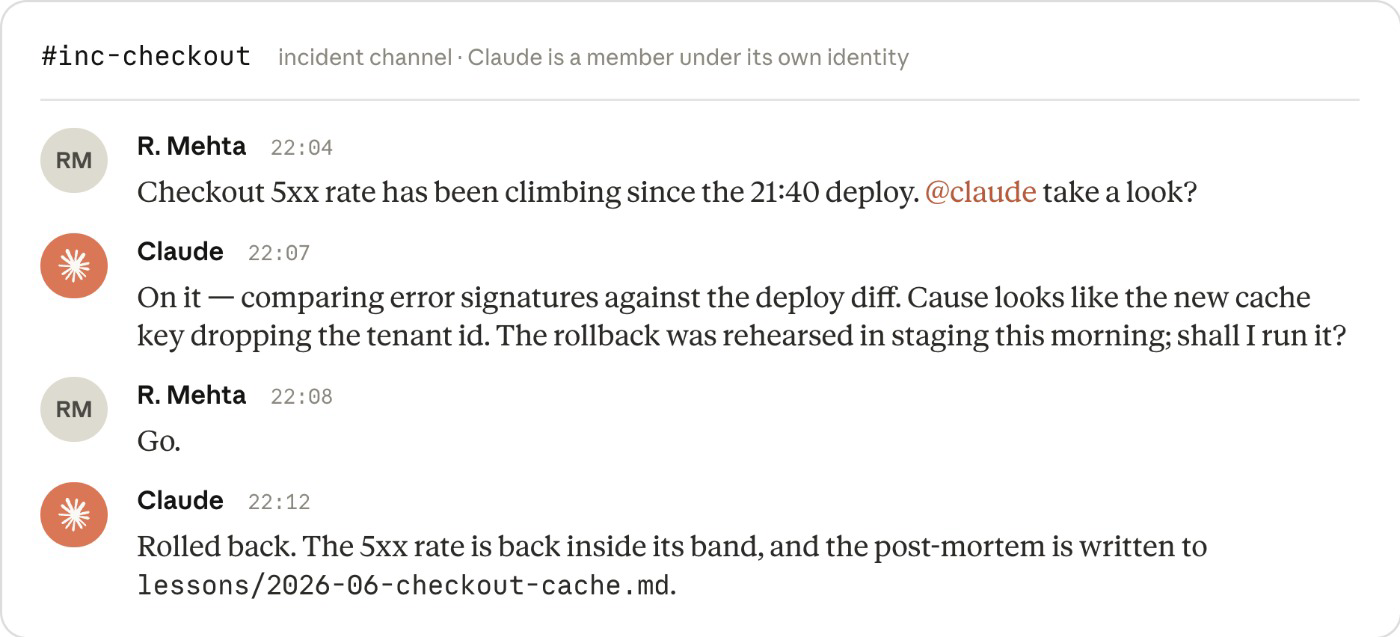
Les incidents peuvent également être signalés par d’autres canaux, notamment les outils de communication en entreprise comme Slack ou Teams. Un incident peut, par exemple, prendre la forme d’un message Slack envoyé à 22 h dans un canal dédié pour demander un correctif urgent ; il peut désormais être pris en charge immédiatement. Claude Tag (bêta publique, actuellement disponible dans Slack) permet à Claude de devenir membre de ces canaux sous sa propre identité. Chaque nouvel incident bénéficie ainsi d’un premier intervenant, et la réponse elle-même vient enrichir la boucle ainsi que la mémoire disponible pour les incidents futurs.
La conversation et les connaissances institutionnelles restent dans le canal, où chaque membre peut oirienter la réponse et agir en conséquence. Tout membre de l’équipe peut tester des hypothèses, explorer d’autres options et enquêter en temps réel, tandis que l’historique du canal renforce la traçabilité. Grâce à l’accès via MCP, Claude vérifie que la métrique est revenue à son niveau de référence et le confirme dans le fil de discussion. Il rédige ensuite le post-mortem dans un fichier de retours d’expérience versionné, qui pourra être consulté lors d’investigations ultérieures.
Les incidents ne sont pas les seuls travaux que Claude Tag peut prendre en charge. Lorsqu’il est tagué dans un ticket via MCP ou sollicité dans le canal, Claude effectue le même triage. Un correctif limité et bien circonscrit donne lieu à une PR soumise au point de contrôle de revue ; tout problème plus large est formalisé dans un fichier intent.md pour la phase 1 : Planification. La boucle commence alors à s’autoalimenter. Voir : comment Claude Tag assure l’astrinte CI/CD chez Anthropic.
Conclusion
Les modèles et les environnements qui les encadrent ont considérablement progressé, permettant aux organisations de transformer la façon dont elles produisent du code et l’ensemble du cycle de développement logiciel.
Cette transformation maintient le jugement humain au cœur du processus tout en prenant en compte les exigences de gouvernance et de conformité propres aux grandes entreprises.
Ce guide rassemble de nombreuses bonnes pratiques concrètes que notre équipe IA appliquée met en œuvre au quotidien auprès de nos clients. Nous espérons qu’il vous aura fourni des repères à la fois pratiques et directement exploitables.
Ressources et remerciements
La documentation ci-dessous présente ce dont une équipe plateforme a besoin pour mettre en place ces contrôles, dans un ordre correspondant globalement à celui dans lequel vous les déploieriez.
Merci à Jim Blackhurst, Will Steuk et Jamal Arif pour leur contribution. Ce guide s'inspire largement d’une partie de leurs travaux.