Comment Anthropic permet l'analyse des données en libre-service avec Claude
Comme de nombreuses équipes de data science et d'ingénierie des données peuvent l'attester, permettre l'analyse des données en libre-service a traditionnellement été une tâche ardue.
Rendre le modèle de données plus accessible aux coworkers moins techniques via des tables larges et dénormalisées conduit souvent à des vues qui se chevauchent avec des définitions incohérentes à mesure que l'entreprise évolue (et ne contribue guère à combler le fossé pour les employés peu désireux d'apprendre SQL). À l’inverse, multiplier les environnements cloisonnés pour les utilisateurs ne permet souvent pas de couvrir l’ensemble des questions métier, y compris les plus spécifiques, et entraîne une prolifération des indicateurs et des tableaux de bord à mesure que les équipes travaillent en silos.
L'essor des LLM offre une voie supplémentaire pour l'analyse en libre-service qui évite ces défis. Toutefois, diriger Claude dans un entrepôt et laisser les agents s'en occuper peut créer un faux sentiment de précision.
L'euphorie initiale de se libérer des demandes ad-hoc se transforme en crainte lorsqu'on se rend compte que cette configuration sépare les parties prenantes de l'infrastructure, de la documentation et de l'expertise sous-jacentes qui les orientaient auparavant vers des ensembles de données soigneusement sélectionnés.
Chez Anthropic, 95 % des requêtes d'analyse métier sont automatisées via Claude, avec une précision globale d'environ 95 %. En confiant ce travail souvent répétitif et répétitif à Claude, notre équipe de data science peut se concentrer sur des travaux plus stratégiques comme la modélisation causale, la prévision et le machine learning.
Après avoir rencontré des dizaines d'utilisateurs de Claude Code les plus expérimentés d'Anthropic et avoir observé une myriade de modèles de conception pour les agents d'analyse, nous avons mis au point certaines bonnes pratiques pour les autres équipes de données travaillant avec des LLM. Dans ce billet, nous partagerons ces conseils et approches pour optimiser la capacité de Claude à générer des informations métier en libre-service, notamment :
- Pourquoi la précision des analyses est un problème de contexte et de vérification, et non un problème de génération de code ;
- Les trois modes d'échec qui causent le plus d'erreurs ;
- La pile d'analyse agentique que nous avons créée pour corriger ces erreurs ;
- Comment nous mesurons l'efficacité ; et
- Un modèle de base pour la création de la majorité de nos compétences (voir l'annexe)
Les données ne sont pas des logiciels
Les capacités génératives des grands modèles de langage (LLM) sont à double tranchant : les mécanismes qui leur permettent d’apporter des solutions créatives à des problèmes complexes peuvent aussi les conduire à générer des informations erronées. Pour bien comprendre les défis liés aux agents d'analyse, il est utile de les comparer aux agents de codage.
Le codage est un espace de solutions ouvert qui récompense la créativité des modèles, tandis que la documentation et les tests constituent des garde-fous naturels contre les erreurs. En revanche, pour les cas d'usage de l'analytique, il n'existe souvent qu'une seule réponse correcte à partir d'une seule source correcte pour les cas d'usages analytiques, ce qui ne permet pas d'en prouver l'exactitude de manière déterministe.
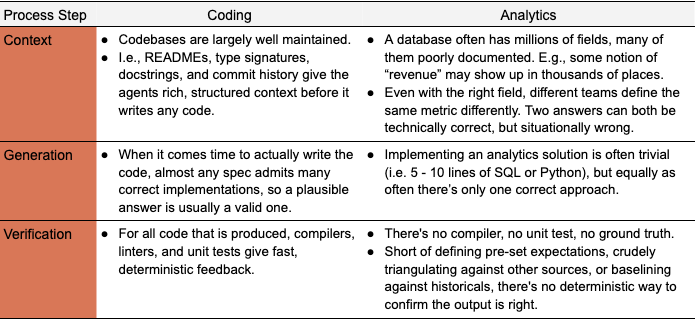
Pour l'analyse métier agentique en libre-service, la complexité réside principalement dans l'ambiguïté des données. Le principal problème réside dans notre capacité à faire correspondre la question d'un utilisateur aux entités précises et à jour de notre modèle de données et à déterminer comment les exploiter correctement. Si nous pouvons faire cela, l'exécution qui en résulte et le SQL deviennent banals.
Nous avons identifié trois caractéristiques de ce problème, qui sont à l'origine de l'écrasante majorité des réponses inexactes :
- Concept d'<> ambiguïté des entités : avec des centaines d'options viables dans un modèle de données (sur des millions de champs potentiels), l'agent n'est pas en mesure de choisir les champs corrects pour répondre le mieux à la question d'un utilisateur. Par exemple, pour mesurer le nombre d'utilisateurs actifs : quelles actions constituent une « activité » ? Incluez-vous les utilisateurs frauduleux ? Quelle période rétrospective utilisez-vous ?
- Persistance des données : les sources de données, les définitions métier et les schémas changent constamment ; les actifs et les connaissances des agents périment et commencent à renvoyer des réponses légèrement erronées.
- Échec de la récupération : les informations appropriées peuvent effectivement se trouver dans le modèle de données et être correctement annotées, mais étant donné l'étendue de l'espace de recherche, l'agent ne les trouve tout simplement pas.
Notre gamme d'analyses en libre-service agentique
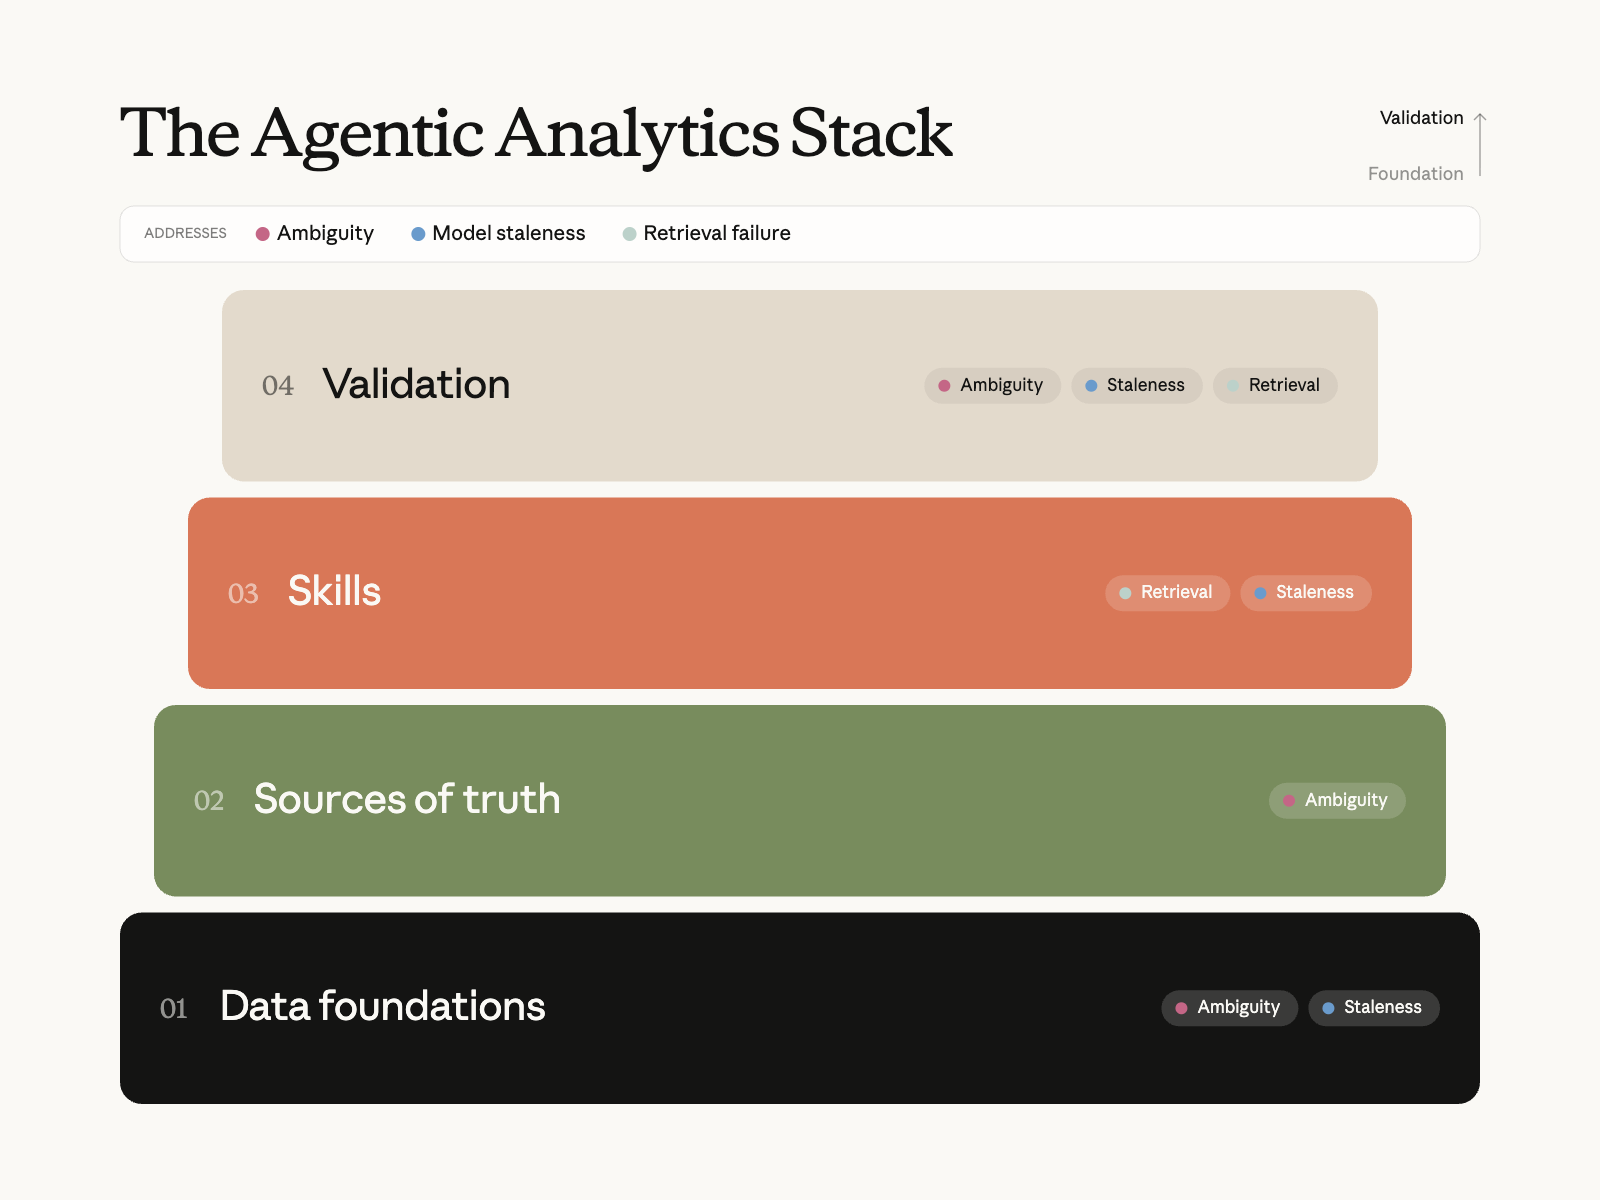
Chez Anthropic, le principal moyen de minimiser ces trois erreurs est d'utiliser notre pile de données agentiques. Chaque couche existe principalement pour s'attaquer à un ou plusieurs des problèmes suivants :
- Ambiguïté des entités : les bases de données et les sources de vérité réduisent l'espace des entités plausibles jusqu'à ce qu'il existe une réponse unique gouvernée.
- Obsolescence : les processus de maintenance et de validation permettent de maintenir les données à jour au fil de l’évolution de l’activité.
- Échec de la récupération : les compétences garantissent que l'agent trouve cette réponse de manière fiable, et l'utilise correctement.
Dans cette section, nous allons discuter de la manière dont nous avons conçu chaque couche.
“Pour les questions ad hoc posées directement dans Slack, découvrez comment notre équipe de données déploie un agent d'analyse de données avec Claude Tag.”
Fondations des données
L'aspect le plus important pour garantir la précision des agents d'analyse est d'avoir des bases de données solides, qui incluent les modèles de données, les transformations, les tests et les tables dans un entrepôt de données, ainsi que les métadonnées les décrivant. Les pratiques standard d'ingénierie des données et de qualité des données, telles que la modélisation dimensionnelle, les tests de décalage à gauche, les contrôles de fraîcheur et d'exhaustivité sur les pipelines critiques, restent d'application (et nous ne les relégifierons pas).
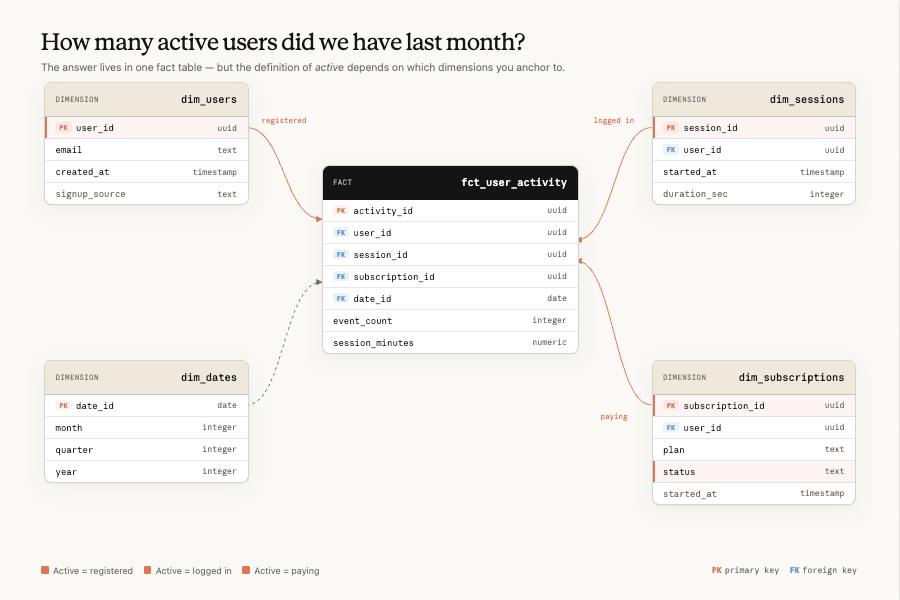
Ce qui change, c'est que l'utilisateur final de votre modèle de données n'est plus un expert en données (par exemple, un data scientist), mais plutôt des agents agissant pour le compte d'utilisateurs disposant d'une expertise des données ou d'une compréhension de l'infrastructure sous-jacente à des degrés divers. Ce changement pose un défi : les résultats ne peuvent pas reposer sur la validation de leur exactitude par l’utilisateur, puisque celui-ci ne dispose tout simplement pas des connaissances nécessaires pour le faire.
La couche de données vise principalement à éliminer l'ambiguïté : si le chiffre d'affaires, par exemple, se répartit entre un seul ensemble de données gouverné au lieu de quarante candidats plausibles, le problème disparaît largement avant même que l'agent n'ait à effectuer une recherche. C'est également là que réside la première défense contre l'obsolescence, puisque le même dépôt qui définit les modèles de référence est le lieu naturel pour veiller à ce qu'ils restent à jour.
Nous avons vu certaines pratiques fonctionner particulièrement bien :
- Créez des ensembles de données de références : de loin, le problème le plus fréquent est que l'agent ne peut pas faire correspondre un concept ( « chiffre d'affaires pour le produit X » ) à la définition correcte unique de la table, de la colonne et de la mesure, généralement parce qu'il existe plusieurs candidats plausibles avec des implémentations légèrement différentes. La solution consiste à réduire le nombre de modèles logiques et à renforcer leur gouvernance : sélectionner un petit nombre de jeux de données de référence faisant autorité, clairement attribués à des responsables, prêts à être exploités et faciles à trouver, puis supprimer progressivement et de manière systématique les jeux de données quasi identiques. Les roll-ups physiques et les caches restent importants pour les coûts et les performances, mais ils devraient découler mécaniquement des modèles de référence plutôt que de coexister avec eux comme des alternatives. L'objectif est que lorsqu'un agent recherche un concept, il trouve une réponse unique gouvernée.
- Appliquez vos normes : nous avons constaté que les fondements ne tenaient que si les modèles de référence et les définitions d'indicateurs étaient appliqués par des outils (l'agent leur est structurellement confié en premier ; plus d'informations ci-dessous), par CI (les modifications qui les contournent après les examens en cas d'échec) et par mandat (les équipes en aval s'appuient sur la couche gouvernée ou expliquent pourquoi elles ne le font pas). Sans mécanismes contraignants, la gouvernance finit rapidement par retomber dans le problème initial : la coexistence de plusieurs options possibles.
- Placez des artéfacts : notre principale défense contre les modèles de données et la logique métier en constante évolution est la cohabitation. La quasi-totalité du code de données (modélisation, couche sémantique, documents de référence, définitions de tableaux de bord de référence) réside dans un seul dépôt, avec des contrôles CI qui protègent l'intégrité entre les couches. Si une modification de la modélisation perturbe un tableau de bord en aval ou invaliderait une métrique documentée, CI le signale et le correctif est fourni dans le même PR. (Nous reviendrons sur les mécanismes de cette fonctionnalité dans la section Skills ci-dessous.)
- Traitez les métadonnées comme un produit de premier ordre : les agents de codage fonctionnent bien, notamment parce que les bases de code sont lisibles : README, signatures de type, docstrings, etc. Votre entrepôt peut être tout aussi lisible, mais uniquement si les descriptions de colonnes et de tables, les définitions de mesures de référence, la documentation granulaire, les fourchettes de valeurs valides, la lignée, la propriété et la hiérarchisation des modèles sont maintenues avec la même rigueur que les transformations elles-mêmes. Bien qu'elle ne constitue pas une nouveauté, une bonne gouvernance fournit un contexte critique qui aide l'agent à choisir le bon jeu de données.
Sources de vérité
Si les fondations des données constituent les usines de données elles-mêmes, les sources de vérité sont les surfaces de référence que l'agent consulte pour s'y orienter. Cette couche réduit l'ambiguïté des concepts <> entités et transforme les « utilisateurs actifs hebdomadaires» dans la question d'une partie prenante en une entité spécifique et gouvernée dans votre modèle de données. Approximativement par ordre décroissant de confiance :
- Couche sémantique : les définitions compilées des mesures et des dimensions. Si une question correspond clairement à une métrique définie, l'agent appelle une fonction et obtient un numéro, le même que celui produit par toutes les autres surfaces de l'entreprise. Nos agents sont structurellement tenus (par l'enseignement des compétences) de tirer parti en priorité de la couche sémantique (voir l'annexe). Une idée que nous avons essayée mais qui n'a pas fonctionné : bootstraper la couche sémantique en permettant à un LLM de générer automatiquement des définitions d'indicateurs à partir de tables brutes et de journaux de requêtes. Il a produit des définitions plausibles qui ont codé les ambiguïtés mêmes que nous essayions d'éliminer, et a obtenu des résultats nets négatifs lors de nos évaluations par rapport à une couche plus restreinte organisée par des humains. Nous recommandons donc de générer la documentation avec Claude, mais en laissant un humain s'occuper de la définition.
- Le lignage et le graphique de transformation : lorsque la couche sémantique ne couvre pas une question, le classement par lignage et par table (en fonction du nombre de références) permet à l'agent de raisonner pour déterminer quels modèles en amont alimentent un concept, lesquels sont obsolètes et lesquels partagent le même grain. Cela transforme le « je ne connais pas l'indicateur » en « je sais à partir de quel modèle gouverné procéder à l'agrégation ». C’est également le socle des indicateurs de fraîcheur des données et de traçabilité que nous mettons en évidence dans la validation en ligne ci-dessous.
- Corpus de requêtes : SQL historique provenant de tableaux de bord, de carnets de notes et d'analyses antérieures. Intuitivement, cela devrait être d'une grande utilité : il permet d'enregistrer chaque question qui a déjà correctement reçu une réponse. Dans la pratique, nous avons constaté qu'en donnant à l'agent un accès brut à des milliers de requêtes précédentes, la précision était améliorée de moins d'un point (nous détaillons cette étude par ablation dans une section ultérieure). La recherche dans les données non structurées ne parvenait pas à associer une nouvelle question au précédent pertinent. Ce qui fonctionne, c'est de regrouper ce corpus en documents de référence structurés par domaine et en modèles d'analyse réutilisables décrits dans les compétences. Traitez l'historique des requêtes comme une matière première pour la conservation, et non comme une source de vérité que l'agent lit directement.
- Contexte métier : la couche que la plupart des équipes ignorent, et celle que nous avons sous-estimée le plus longtemps. Un agent qui ne comprend pas votre activité répondra aux questions de l'utilisateur, mais pas à ce qu'il voulait dire. Il ne saura pas que le « lancement au deuxième trimestre » fait référence à un produit spécifique, que deux équipes définissent le même terme différemment ou qu'une question est posée parce qu'une réunion du conseil d'administration est prévue le jeudi. Nous fournissons un diagramme des connaissances de l'entreprise composé de documents indexés, de feuilles de route, de journaux de décision et de notre structure organisationnelle pour que l'agent puisse résoudre les références contextuelles et poser des questions de clarification plus pertinentes.
Le schéma d'échec commun aux quatre est le même que celui observé pour la couche de bases de données : une documentation insuffisante ou obsolète. Claude est exceptionnellement utile pour combler les lacunes (rédaction de descriptions de colonnes, proposition de documents métriques à partir de modèles de requêtes, signalement de modèles non documentés dans CI), mais la conservation et la propriété sont gérées par des humains.
Dans les deux sections suivantes, nous examinons comment rendre cette propriété suffisamment abordable pour qu'elle se concrétise réellement.
Skills
Si les sources de vérité sont les connaissances déclaratives de l'agent (c'est-à-dire ce qu'une métrique signifie), une Skill est alors sa connaissance procédurale : quelles sources consulter dans quel ordre, comment s'orienter dans des données ambiguës et à quoi ressemble une analyse achevée.
Dans Claude Code, une Skill est un dossier de markdown que l'agent lit à la demande. Chez Anthropic, les compétences que nous avons développées apportent une valeur ajoutée considérable. Sans compétences, Claude n'a pas obtenu de réponses précises aux questions d'analyse lors de nos évaluations à 21 %. L’ajout de compétences permet de faire systématiquement dépasser les 95 % de précision globale, avec des résultats qui atteignent régulièrement environ 99 % dans certains domaines. Voir l’annexe pour un modèle de base que nous utilisons pour créer la plupart de nos compétences.
Quelques bonnes pratiques :
Créez des compétences complémentaires : une compétence de connaissances sert de routeur général léger, permettant de charger des informations supplémentaires propres à chaque domaine à la demande. Il indique : « Consultez d’abord la couche sémantique, mais si elle ne couvre pas le besoin, voici une trentaine de fichiers de référence pour ce domaine, qui décrivent les tables, les colonnes, les jointures pertinentes et les points de vigilance. » Ce routeur est, en effet, notre réponse aux erreurs de récupération : au lieu de laisser l'agent rechercher dans un entrepôt de plusieurs millions de sites, il réduit l'espace à quelques dizaines de fichiers sélectionnés avant même d'écrire une requête. La compétence du runbook codifie le processus qu'un analyste senior suivrait : clarifier la question, trouver des sources (via la compétence connaissances), exécuter la requête, puis transmettre le résultat en boucle à des sous-agents de contrôle contradictoires. Il regroupe également une douzaine de modèles d’analyse réutilisables (courbes de rétention, décomposition des taux, analyse des entonnoirs de conversion), afin d’éviter de réinventer la roue à chaque demande courante.
Créez des documents de référence appropriés : écrits pour être récupérés par un LLM. Nos documents de référence décrivent les tableaux (granulométrie, portée et exclusions), le fonctionnement des points de vigilance (par exemple, « excluez les domaines de messagerie gratuits connus, mais conservez les domaines personnalisés comme anthropic.com » ) et les déclencheurs de routage explicites (par exemple, « SI la question concerne la levée d'expériences… NE PAS utiliser pour le nombre brut d'événements » ), sans recettes prescriptives qui deviennent obsolètes. Voir ci-dessous un squelette que nous utilisons pour créer des documents de référence.
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]
Traitez la maintenance des compétences comme un citoyen de premier ordre : les documents sur les compétences décrivent un modèle de données qui évolue quotidiennement, donc sans maintenance active, ils sont défectueux en quelques semaines. Nous avons vu notre précision hors ligne passer d'environ 95 % au lancement à environ 65 % en un mois avant de considérer ce problème comme un problème d'ingénierie. Cela a nécessité de placer les fichiers de Skill Markdown dans le même dépôt que nos modèles de transformation, de sorte que le PR qui modifie un modèle est le même PR qui met à jour le document le décrivant. Un hook de révision du code signale toute modification du modèle de reporting qui n'affecte pas un fichier de compétences. Aujourd’hui, environ 90 % de nos demandes de modification du modèle de données (PR) incluent également une modification des compétences dans le même diff. Nous élagons également régulièrement les échafaudages de compétences à mesure que les modèles s'améliorent et que les anciens modes d'échec ne s'appliquent plus.
Créez une expérience cohérente et transparente sur toutes les surfaces : une même compétence doit fournir la même réponse aux questions dans Slack, dans l'IDE, dans un outil de tableau de bord et dans les sessions autonomes avec les agents. Pour ce faire, nous avons veillé à une source de référence (le dépôt de données) et à ce que les changements de compétences soient synchronisés automatiquement. Lors de la fusion, la Skill se synchronise avec une place de marché de plug-ins (pour les utilisateurs d'IDE), avec des blobs de stockage cloud (pour les applications hébergées qui lisent un seul fichier) et est directement fournie en tant que ressources via MCP. Nous avons également conçu la portabilité dès le départ en évitant les accès aux dépôts codés en dur et les espaces de noms spécifiques à une surface.
Validation
Enfin, la validation permet de déterminer lequel des trois modes d'échec continue d'être détecté.
Évaluations hors ligne
Une tendance courante que nous constatons est que les équipes de données vont mettre en place des environnements analytiques élaborés sans disposer d'aucun processus pour comprendre la précision de leurs agents d'analyse.
Une façon de combler cet écart est d'utiliser des évaluations hors ligne, qui sont de simples paires questions/réponses. Les évaluations hors ligne peuvent être comparées aux tests hors ligne pour un modèle d'apprentissage automatique : elles ne vous indiquent pas les performances de vos agents en ligne, mais elles vous donnent une bonne idée de l'existence de lacunes critiques.
Nous déployons deux types d'évaluations hors ligne chez Anthropic. Les évaluations basées sur des tableaux de bord sont générées automatiquement par Claude (puis validées par des humains), couvrant les questions les plus courantes des parties prenantes. Les évaluations à longue attente permettent d'alimenter le contexte métier de Claude (feuilles de route, tableaux) et de lui permettre de générer des questions plausibles dans le reste du domaine. Nous collectons également en continu chaque fois qu'une partie prenante corrige l'agent dans un fil, car cette correction est une évaluation des candidats.
Parmi les autres bonnes pratiques, citons :
- Ancrez une vérité fondamentale pour éviter toute dérivation : une évaluation établie sur la base de données en temps réel devient obsolète dès le moment où le chiffre sous-jacent change. Associez chaque évaluation à une date de référence, analysez la par rapport à une table factuelle stable ou laissez le notateur juger la requête de l'agent plutôt que son nombre. Connectez la suite à CI pour qu'un PR touchant une dépendance réexécute les évaluations concernées.
- Stockez les résultats sous forme de télémétrie, plutôt que de journaux de tests : chaque exécution est enregistrée dans une table d'entrepôt avec la version de la compétence, git SHA, l'ID du modèle, le taux de réussite/d'échec par assertion, le nombre de jetons et l'horloge murale. « Est-ce que cela a changé l'aide ? » devient une requête et vous obtenez les séries chronologiques pour détecter les régressions lentes qu'une seule exécution d'IC ne permettra pas de détecter.
- Lancements de Gate par domaine : un propriétaire de domaine ne peut pas annoncer l'agent à ses parties prenantes tant que sa part de l'ensemble d'évaluations n'a pas atteint un certain seuil (nous avions initialement utilisé environ 90 % ). Il impose les corrections dans les documents de référence avant que les utilisateurs n'en voient les erreurs.
- Créez le nombre d'évaluations approprié : le nombre d'évaluations que vous devez obtenir dépend de la complexité du secteur d'activité et de la complexité du modèle de données sous-jacent. Calibrez en mesurant dans quelle mesure la précision hors ligne permet de prédire la précision en ligne : nous avons constaté des retours décroissants au-delà de quelques dizaines par thème (par exemple, « croissance » ), et que ce plafond diminue à chaque nouvelle génération de modèles.
- La précision de l'évaluation hors ligne doit être d'environ 100 % ; chaque réponse correcte doit également être acceptée dans votre couche sémantique (si vous en avez une). Encore une fois, ce niveau de précision ne signifie pas que votre système ne donnera pas une mauvaise réponse, mais simplement qu'il n'y a pas d'écarts évidents, en supposant que vous disposiez d'une couverture d'évaluation appropriée.
Techniques d'ablation
Chaque décision structurelle concernant la compétence (par exemple, quelles sources exposer, si un sous-agent gagne sa latence, s'il convient de fusionner deux compétences en une seule) est prise en tenant compte de notre ensemble d'évaluations hors ligne.
Nous ne faisons varier qu’un seul composant à la fois et comparons les taux de réussite. Chaque exécution ne prend qu’une heure et permet de trancher de nombreux débats. La méthodologie est plus importante qu'un résultat isolé :
- Conçu pour des résultats négatifs. Notre étude d'ablation la plus utile était une ablation négative. Nous avons donné à l'agent un accès direct grep à l'ensemble de notre tableau de bord, de notre transformation et de notre analyst-notebook SQL (des milliers de fichiers). Nous avons ensuite vérifié dans les transcriptions qu’il les avait effectivement consultés avant chaque réponse. Précision améliorée de moins d'un point dans les deux sens. Nous avons ensuite vérifié les facteurs de confusion évidents : la réponse était-elle réellement dans le corpus concernant les questions où il s'était trompé ? Environ 80 % du temps, oui. Est-ce que « answer present » a prédit « now gets it right » ? Non, le taux de renouvellement était stable. Les informations étaient là, l'agent les a vues et il ne les a toujours pas utilisées. Cette expérience unique nous a montré que notre goulot d'étranglement n'était pas l'accès aux travaux antérieurs, mais la structure (c'est-à-dire le fait d'attribuer une question à l'entité appropriée). Cette information a permis de redéfinir des mois de feuille de route.
- Effectuez les ablations à l’échelle des pull requests (PR). Chaque modification significative d'une compétence fait l'objet d'un avant/après sur la tranche d'évaluation pertinente, le delta étant indiqué dans la description PR. Il permet d'assurer une honnêteté dans le « J'ai amélioré la documentation » et de détecter le cas étonnamment courant où une addition bien intentionnée aggrave les choses.
- Gardez une liste succincte de ce qui n'a pas fonctionné. Deux des nôtres : l'ajout de cycles supplémentaires d'amélioration des documents après un certain point (nous avons atteint trois itérations consécutives négatives netes : les documents allongaient de plus en plus, pas en mieux), et le remplacement du réviseur contradictoire par un modèle moins cher pour réduire la latence (il a perdu l'essentiel de ses gains en précision, sans réelle accélération). Les résultats négatifs sont peu coûteux à enregistrer et ils empêchent la personne suivante de répéter la même expérience.
Validation en ligne
La dernière étape consiste à garantir que les performances réelles du système en ligne sont aussi précises que possible. Certaines des mesures que nous prenons incluent :
- Contrôle adversaire : nous avons constaté que le recours à une compétence Claude pour remettre en question de manière agressive toutes les hypothèses sous-jacentes à une réponse finale potentielle augmentait la précision de 6 % dans notre ensemble d'évaluations, mais au prix de 32 % de jetons en plus et d'une latence supérieure de 72 %.
- Pied de page de provenance : chaque réponse est accompagnée d'un pied de page qui indique de quel niveau de source elle provient (couche sémantique › référence organisée › table brute), quelle est l'actualité des données sous-jacentes et qui est propriétaire du modèle. Cela n'améliore pas la réponse mais aide le consommateur à juger dans quelle mesure il peut faire confiance à la réponse. Un pied de page « tableau brut, fraîcheur inconnue » est un signal à vérifier avant d'envoyer en amont, et c'est l'une des rares mesures d'atténuation dont nous disposons pour les défaillances silencieuses.
- Contrôles de la qualité des données : il est possible que votre agent utilise le bon champ de la manière appropriée, mais que les données elles-mêmes soient incorrectes. L'ajout de contrôles de base de la qualité des données pour s'assurer que le champ référencé est à jour, complet et exempt d'anomalies est généralement une bonne mesure d'hygiène.
- Surveillance passive : deux signaux de production que nous suivons en permanence sont la part de requêtes des agents qui se résolvent par le biais de la couche sémantique et la part de réponses qui utilisent le langage de correction ( « c'est la mauvaise table », « le filtre anti-fraude vous manque » ). Les deux alimentent un tableau de bord révisé chaque semaine parallèlement au taux de réussite hors ligne.
- Active correction harvesting : la partie qui boucle la boucle. Un agent planifié parcourt les canaux de communication des parties prenantes toutes les quelques heures à la recherche de formulations similaires signalant des corrections, rédige une proposition de modification en une ligne dans le document de référence concerné, puis ouvre une pull request (PR) en l’attribuant au responsable du domaine. La méthode de correction est délibérément ennuyeuse — modifier un fichier markdown, fusionner, synchroniser automatiquement partout — pour que le propriétaire d'un domaine ne passe pas trop de temps sur la tâche. Les mêmes corrections sont retransmises dans l'ensemble d'évaluations hors ligne.
Le mode d'échec qu'aucune de ces solutions n'aborde entièrement est le mode d'échec silencieux. La réponse est fausse, mais elle semble plausible et est utilisée sans objection. Nos mesures d'atténuation sont le pied de page, une approbation humaine explicite pour tout ce qui est lié à la direction et une évaluation permanente des principaux KPI de chaque domaine, dont le bon sens est vérifié quotidiennement par rapport au tableau de bord agréé, même si nous ne disposons pas encore d'une solution robuste.
Premiers pas avec l'analyse en libre-service
Si vous partez de zéro, une poignée de jeux de données de référence, quelques dizaines d'évaluations hors ligne et une expertise peu approfondie permettront de tirer le meilleur parti de cet avantage ; tout le reste de ce billet est ce que nous avons ajouté une fois ces jeux terminés.
Nous avons également partagé de nombreuses bonnes pratiques, qui ne seront pas toutes appropriées pour toutes les équipes de données. Alignez-vous avec votre organisation sur quelques principes qui influeront sur votre approche en demandant :
- Quelle importance accordez-vous à l’exactitude de la réponse aujourd’hui par rapport à celle qu’elle aura à l’avenir ? Les modèles d'IA progressent à un rythme rapide. Nous voyons souvent des entreprises construire une infrastructure importante pour pallier les lacunes actuelles de leurs modèles, qui deviennent discutables une fois ces modèles améliorés. Connaître les limites des modèles et attendre que leurs améliorations comblent les lacunes demande nettement moins d’efforts, mais cette approche peut ne pas être compatible avec le niveau de risque que votre entreprise est prête à accepter.
- Comment anticipez-vous l'évolution de la complexité de votre entreprise au fil du temps ? Certains des processus que nous avons évoqués peuvent être excessifs si, par exemple, vous produisez peu de données, si les résultats ne sont utilisés que par quelques personnes ou si votre modèle de données est appelé à rester simple.
- Quel est le niveau technique du public visé par le produit ? Autrement dit, si vous développez ce système d’analyse pour des data scientists capables de repérer les réponses incorrectes, vous pourrez peut-être tolérer davantage d’erreurs que si vous vous adressez à un public qui ne connaît pas le modèle de données sous-jacent.
- Combien êtes-vous prêt à dépenser pour une meilleure précision ? Nous avons constaté que certains processus, comme la validation contradictoire, peuvent améliorer considérablement la précision, mais souvent à un coût et à une latence plus élevés.
- Dans quelle mesure êtes-vous à l'aise avec les contrôles d'accès et la confidentialité des données internes ? Les agents sont souvent nettement plus performants lorsque le contexte est important ; toutefois, un large accès aux données entrave la posture de gouvernance de la plupart des entreprises. Cela détermine si vous devez développer un agent unique ou plusieurs agents spécialisés dans des périmètres précis.
Quelle que soit l’approche retenue, nos progrès les plus importants sont venus du traitement de chacun des trois types de défaillances : lever toute ambiguïté pour aboutir à une réponse unique et encadrée par des règles de gouvernance, faciliter l’accès à cette réponse et signaler toute obsolescence de l’un ou de l’autre.
Cet article a été rédigé par Chen Chang, Clement Peng, Justin Leder, Johanne Jiao et Josh Cherry, membres de l'équipe Data Science et Data Engineering. Les auteurs tiennent à remercier Michael Segner pour ses contributions.
Annexe
Skill File Skeleton
Voici le squelette de notre principale skill d'entrepôt : la structure réelle du fichier, les spécificités internes étant remplacées par [des espaces entre parenthèses]. Il n'est pas destiné à être reproduit mot pour mot ; il est destiné à montrer les types de sections que nous avons jugées dignes d'être notées.
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]