Modèles de flux de travail courants pour les agents IA, et quand les utiliser
Conseils pratiques sur la manière de structurer les tâches d'agents à l'aide de trois modèles de flux de travail courants, avec les avantages et inconvénients de chacun.
Les agents IA prennent des décisions de manière autonome, et ce sont les flux de travail qui permettent de structurer cette autonomie. Ils établissent des modèles d'exécution qui canalisent les capacités des agents vers des problèmes complexes nécessitant des étapes coordonnées, des résultats prévisibles et une synchronisation orchestrée.
Lorsque vous avez besoin que plusieurs agents travaillent ensemble, la vraie question est de savoir quel modèle correspond à votre problème.
Nous avons travaillé avec des dizaines d'équipes pour créer des agents IA. En production, trois modèles couvrent la grande majorité des cas d'usage : séquentiel, parallèle et évaluateur-optimiseur.
Chacun résout des problèmes différents, et choisir le mauvais vous coûte en latence, en jetons ou en fiabilité. Cet article détaille les trois, en indiquant quand chacun convient et comment les combiner.
Comment les flux de travail et les agents fonctionnent ensemble
Si vous avez dirigé une équipe, vous comprenez déjà les flux de travail.
Pensez à une chaîne d'assemblage de fabrication : chaque poste dispose d'un travailleur qualifié qui prend des décisions sur ses tâches spécifiques, mais le flux global est conçu à l'avance, même lorsque les étapes individuelles impliquent des décisions dynamiques comme le routage ou les nouvelles tentatives.
Les flux de travail des agents fonctionnent de la même manière.
Comprendre les flux de travail par rapport aux agents autonomes
Les flux de travail ne remplacent pas l'autonomie des agents ; ils déterminent où et comment ceux-ci l'exercent.
Un agent entièrement autonome décide de tout : quels outils utiliser, dans quel ordre exécuter les tâches et quand s'arrêter.
Un flux de travail fournit une structure : il établit le flux global, définit les points de contrôle et fixe les limites du fonctionnement des agents à chaque étape, tout en permettant un comportement dynamique dans ces limites.
Chaque étape d'un flux de travail peut toujours s'appuyer sur le raisonnement et l'utilisation d'outils par un agent, mais l'orchestration globale suit un chemin défini. Un modèle de flux de travail vous fournit l'intelligence d'un agent à chaque étape, et un processus prévisible qui s'étend sur l'ensemble de la tâche.
Modèles de flux de travail agentiques
En production, nous voyons trois modèles de flux de travail revenir le plus souvent. Considérez-les comme des éléments de base que comme des modèles rigides – vous les combinerez souvent ou les imbriquerez à mesure que vos besoins évoluent :
- Flux de travail séquentiels : pour exécuter des tâches dans un ordre fixe
- Flux de travail parallèles : pour exécuter simultanément des tâches indépendantes sur plusieurs agents
- Flux de travail évaluateur-optimiseur : pour les résultats nécessitant un affinement itératif
Chaque type de flux de travail résout des problèmes spécifiques et implique des compromis évidents en matière de complexité, de coût et de performances.
| Problème qu'il résout | Quand utiliser | Compromis | Avantage | |
|---|---|---|---|---|
| Séquentiel | Les tâches ont des dépendances : l'étape B nécessite le résultat de l'étape A | Processus en plusieurs étapes, pipelines de données, cycles de rédaction-révision-peaufinage | Ajoute une latence (chaque étape attend la précédente) | Peut améliorer la précision en laissant chaque agent se concentrer sur une seule tâche |
| Parallèle | Les tâches sont indépendantes, mais leur exécution une à la fois est lente | Évaluations dans plusieurs dimensions, revue de code, analyse de documents | Coûte plus cher (plusieurs appels API simultanés) et nécessite une stratégie d'agrégation | Peut accélérer l'achèvement et la séparation des responsabilités entre les équipes d'ingénierie |
| Évaluateur-optimiseur | La qualité de la première ébauche n'est pas assez bonne | Documentation technique, communications clients, génération de code par rapport à des normes spécifiques | Multiplie l'utilisation des jetons et augmente le temps d'itération | Peut générer de meilleurs résultats grâce à des boucles de rétroaction structurées |
Commencez par le modèle le plus simple qui résout votre problème. Utilisez le séquentiel par défaut. Passez au parallèle lorsque la latence est un goulot d'étranglement et que les tâches sont indépendantes, et n'ajoutez des boucles évaluateur-optimiseur que si vous pouvez mesurer l'amélioration de la qualité.
Flux de travail séquentiels
Les flux de travail séquentiels exécutent des tâches dans un ordre prédéterminé.
Les agents à chaque étape traitent les entrées, prennent des décisions, font des appels d'outils selon les besoins, puis passent les résultats à l'étape suivante. Le résultat est une chaîne d'opérations claire où les sorties circulent de manière linéaire dans le système.
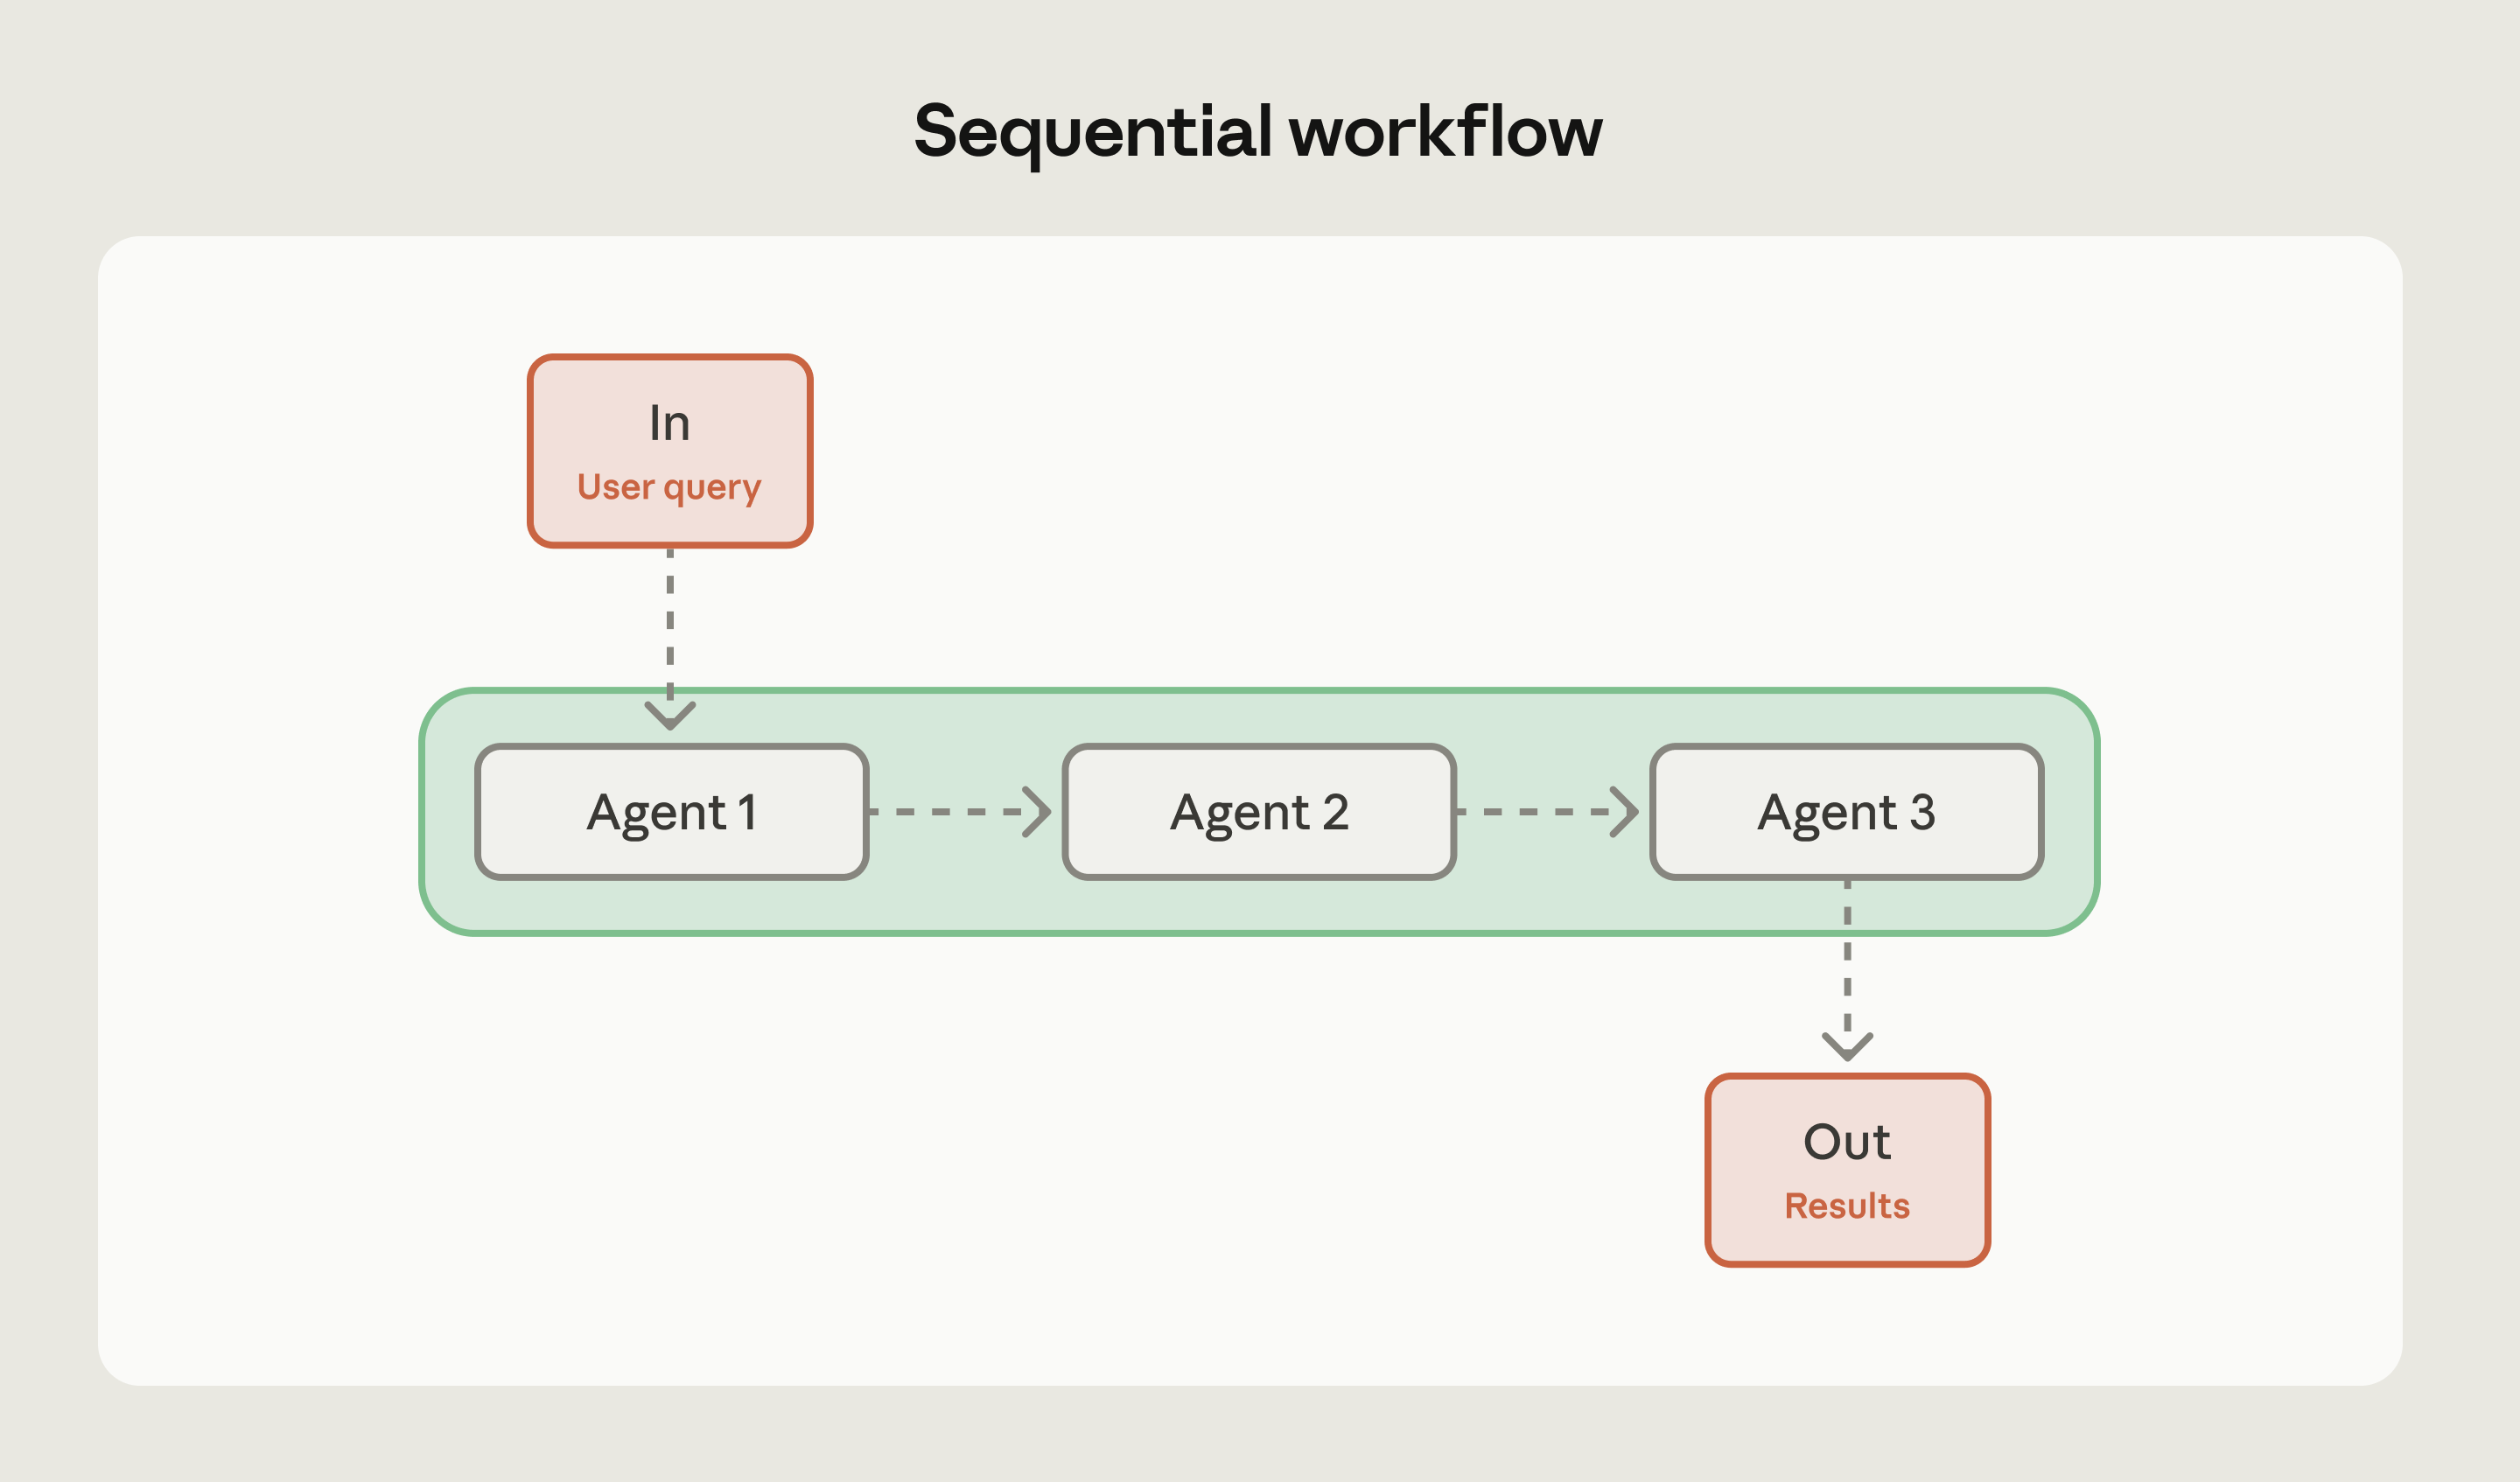
Quand les utiliser : les flux de travail séquentiels excellent lorsque les tâches se décomposent naturellement en étapes distinctes avec des dépendances claires. Vous acceptez une certaine latence supplémentaire en échange d'une plus grande précision en concentrant chaque agent sur une sous-tâche spécifique au lieu d'essayer de tout gérer en même temps.
Utilisez des flux de travail séquentiels lorsqu'il existe :
- Processus en plusieurs étapes où chaque étape dépend du résultat précédent
- Pipelines de transformation des données où chaque étape ajoute une valeur spécifique
- Tâches qui ne peuvent pas être parallélisées en raison de dépendances inhérentes
- Cycles d'amélioration itératifs comme les cycles de rédaction-révision-peaufinage
Quand les éviter : évitez les flux de travail séquentiels lorsqu'un seul agent peut efficacement gérer l'ensemble de la tâche, ou lorsque les agents doivent collaborer plutôt que de se transmettre le travail séquentiellement. Si vous imposez une structure séquentielle à une tâche alors qu'elle ne s'y prête pas naturellement, vous ajoutez une complexité inutile.
Exemple : les flux de travail séquentiels fonctionnent bien lorsque chaque étape implique un travail vraiment différent :
- Générer des textes marketing, puis les traduire en plusieurs langues, ou extraire des données de documents, les valider par rapport à un schéma et les charger dans une base de données
- Les pipelines de modération de contenu fonctionnent également bien de manière séquentielle : extraire le contenu, le classer, appliquer des règles de modération, puis l'acheminer vers la destination appropriée
Conseil de pro : commencez par tester votre pipeline comme un agent unique, dans lequel les étapes ne représentent qu'une partie de la requête. Si cela est suffisant, vous avez résolu le problème sans ajouter de complexité. Ne divisez le flux de travail en plusieurs étapes que lorsqu'un seul agent ne peut pas le gérer de manière fiable.
Flux de travail parallèles
Les flux de travail parallèles distribuent des tâches indépendantes entre plusieurs agents qui les exécutent simultanément. Au lieu d'attendre qu'un agent ait terminé avant de lancer le suivant, vous exécutez simultanément plusieurs agents et fusionnez leurs résultats.
Ce modèle peut améliorer la vitesse lorsque les tâches ne dépendent pas les unes des autres.
L'approche ressemble au modèle fan-out/fan-in des systèmes distribués. Vous envoyez le même travail ou un travail connexe à plusieurs agents, chacun traitant indépendamment, puis vous agrégez ou synthétisez leurs résultats.
Les agents ne se transmettent pas le travail les uns aux autres, ils opèrent de manière autonome et produisent des résultats qui contribuent à la tâche globale.
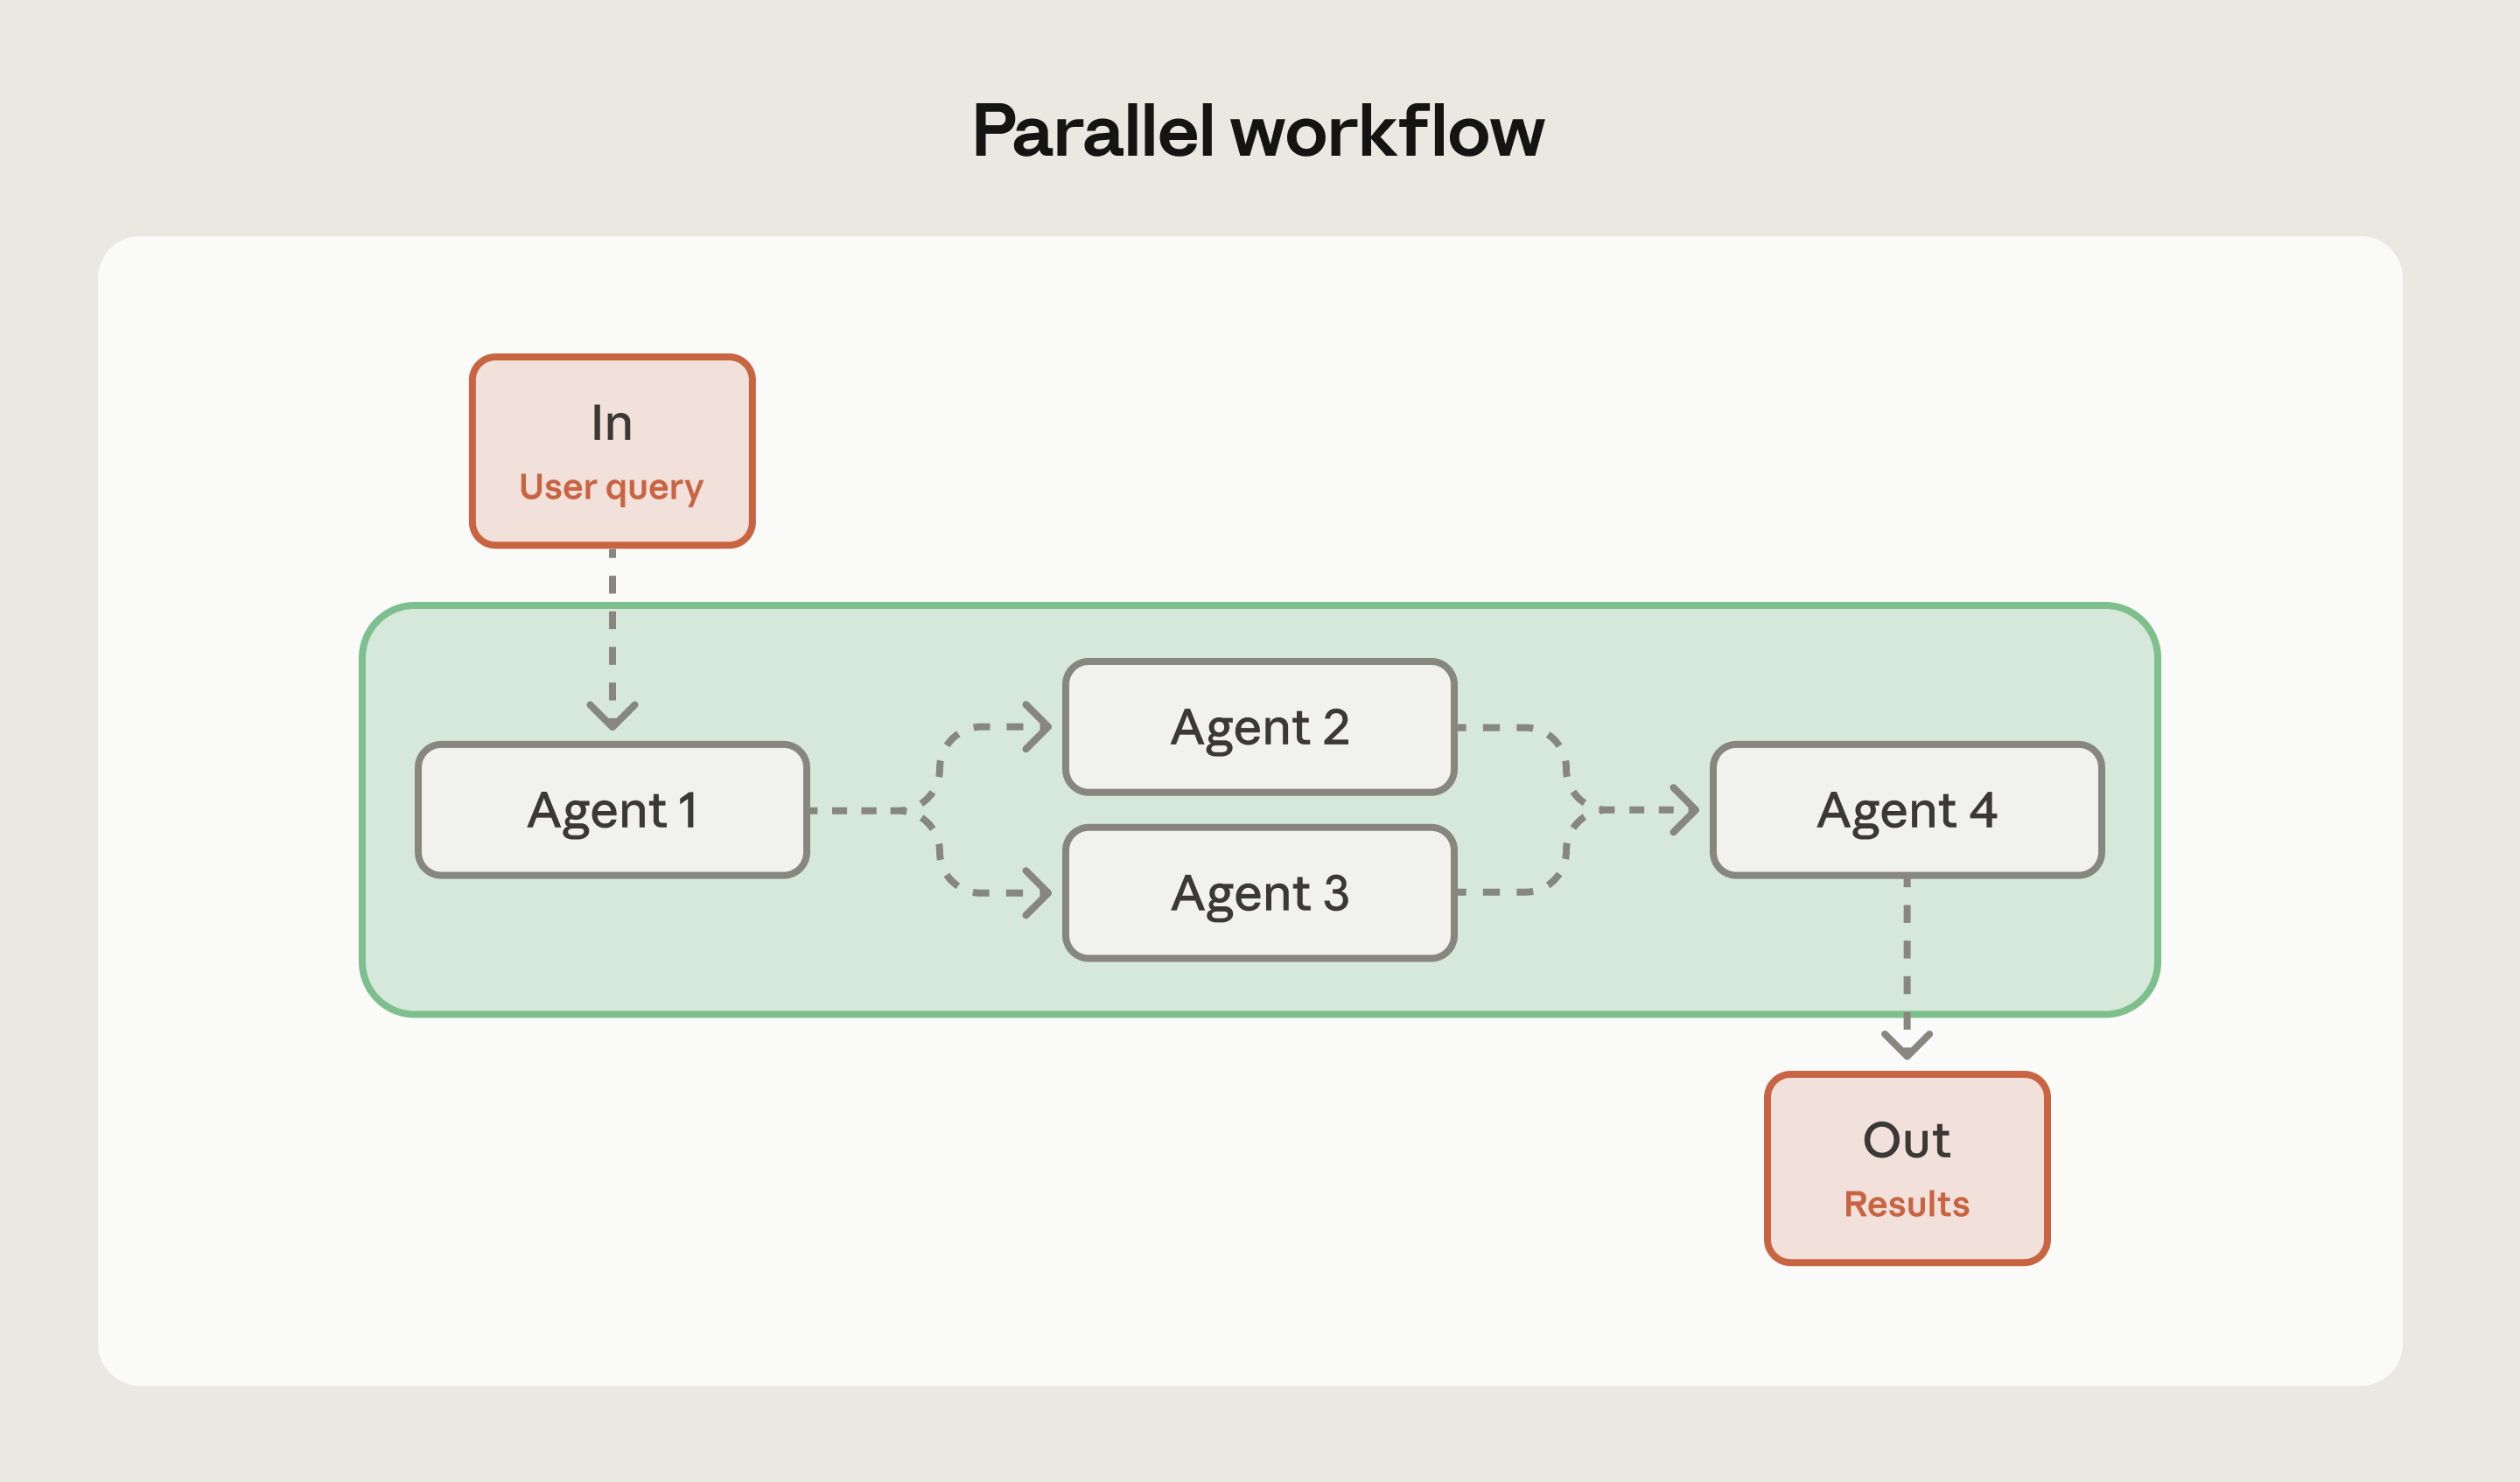
Quand l’utiliser : la parallélisation est logique lorsque vous pouvez diviser le travail en sous-tâches indépendantes qui bénéficient d'un traitement simultané, ou lorsque vous avez besoin de plusieurs perspectives sur un même problème. Elle permet également de séparer les responsabilités : différents ingénieurs peuvent gérer et optimiser des agents individuels de manière indépendante, sans que leurs travaux n'interfèrent les uns avec les autres. Pour les tâches complexes, il est souvent plus efficace de traiter chaque aspect avec un appel IA distinct que d'essayer de tout gérer en un seul appel.
Envisagez des flux de travail parallèles pour :
- Approches par compartimentage dans lesquelles différents agents traitent différents aspects (par exemple, l'un traite les requêtes tandis qu'un autre vérifie les problèmes de sécurité)
- Scénarios d'évaluation dans lesquels chaque agent évalue différentes dimensions de la qualité
- Modèles de vote où plusieurs agents analysent le même contenu et où vous agrégez leurs évaluations
Quand les éviter : n'utilisez pas de flux de travail parallèles lorsque les agents ont besoin d'un contexte cumulatif ou doivent s'appuyer sur le travail des autres. Évitez ce modèle lorsque les contraintes de ressources, comme les quotas d'API, rendent le traitement concurrent inefficace, ou lorsque vous manquez de stratégies claires pour gérer les résultats contradictoires de différents agents. Si l'agrégation des résultats devient trop complexe ou dégrade la qualité du résultat final, la parallélisation n'en vaut pas la peine.
Exemple : les flux de travail parallèles fonctionnent bien pour :
- Automatisation des évaluations (chaque agent vérifie différents indicateurs de qualité) ou de la revue de code (plusieurs agents examinent différentes catégories de vulnérabilités)
- L'analyse de documents est un autre excellent cas d'utilisation : effectuez en parallèle l'extraction de thèmes clés, l'analyse des sentiments et la vérification factuelle, puis combinez les enseignements
Conseil de pro : concevez votre stratégie d'agrégation avant d'implémenter des agents parallèles. Opterez-vous pour le vote majoritaire ? Faire la moyenne des scores de confiance ? S'en remettre à l'agent le plus spécialisé ? Avoir un plan clair pour la synthèse des résultats vous empêche de collecter des résultats contradictoires sans aucun moyen de les résoudre.
Flux de travail évaluateur-optimiseur
Les flux de travail évaluateur-optimiseur associent deux agents dans un cycle itératif : l'un génère du contenu, un autre l'évalue en fonction de critères spécifiques, et le générateur affine selon ces commentaires. Cela se poursuit jusqu'à ce que le résultat atteigne votre seuil de qualité ou qu'il atteigne un nombre maximal d'itérations.
L'idée clé, c'est que la génération et l'évaluation sont des tâches cognitives différentes. Les séparer permet à chaque agent de se spécialiser : le générateur se concentre sur la production de contenu, l'évaluateur sur l'application de critères de qualité cohérents.
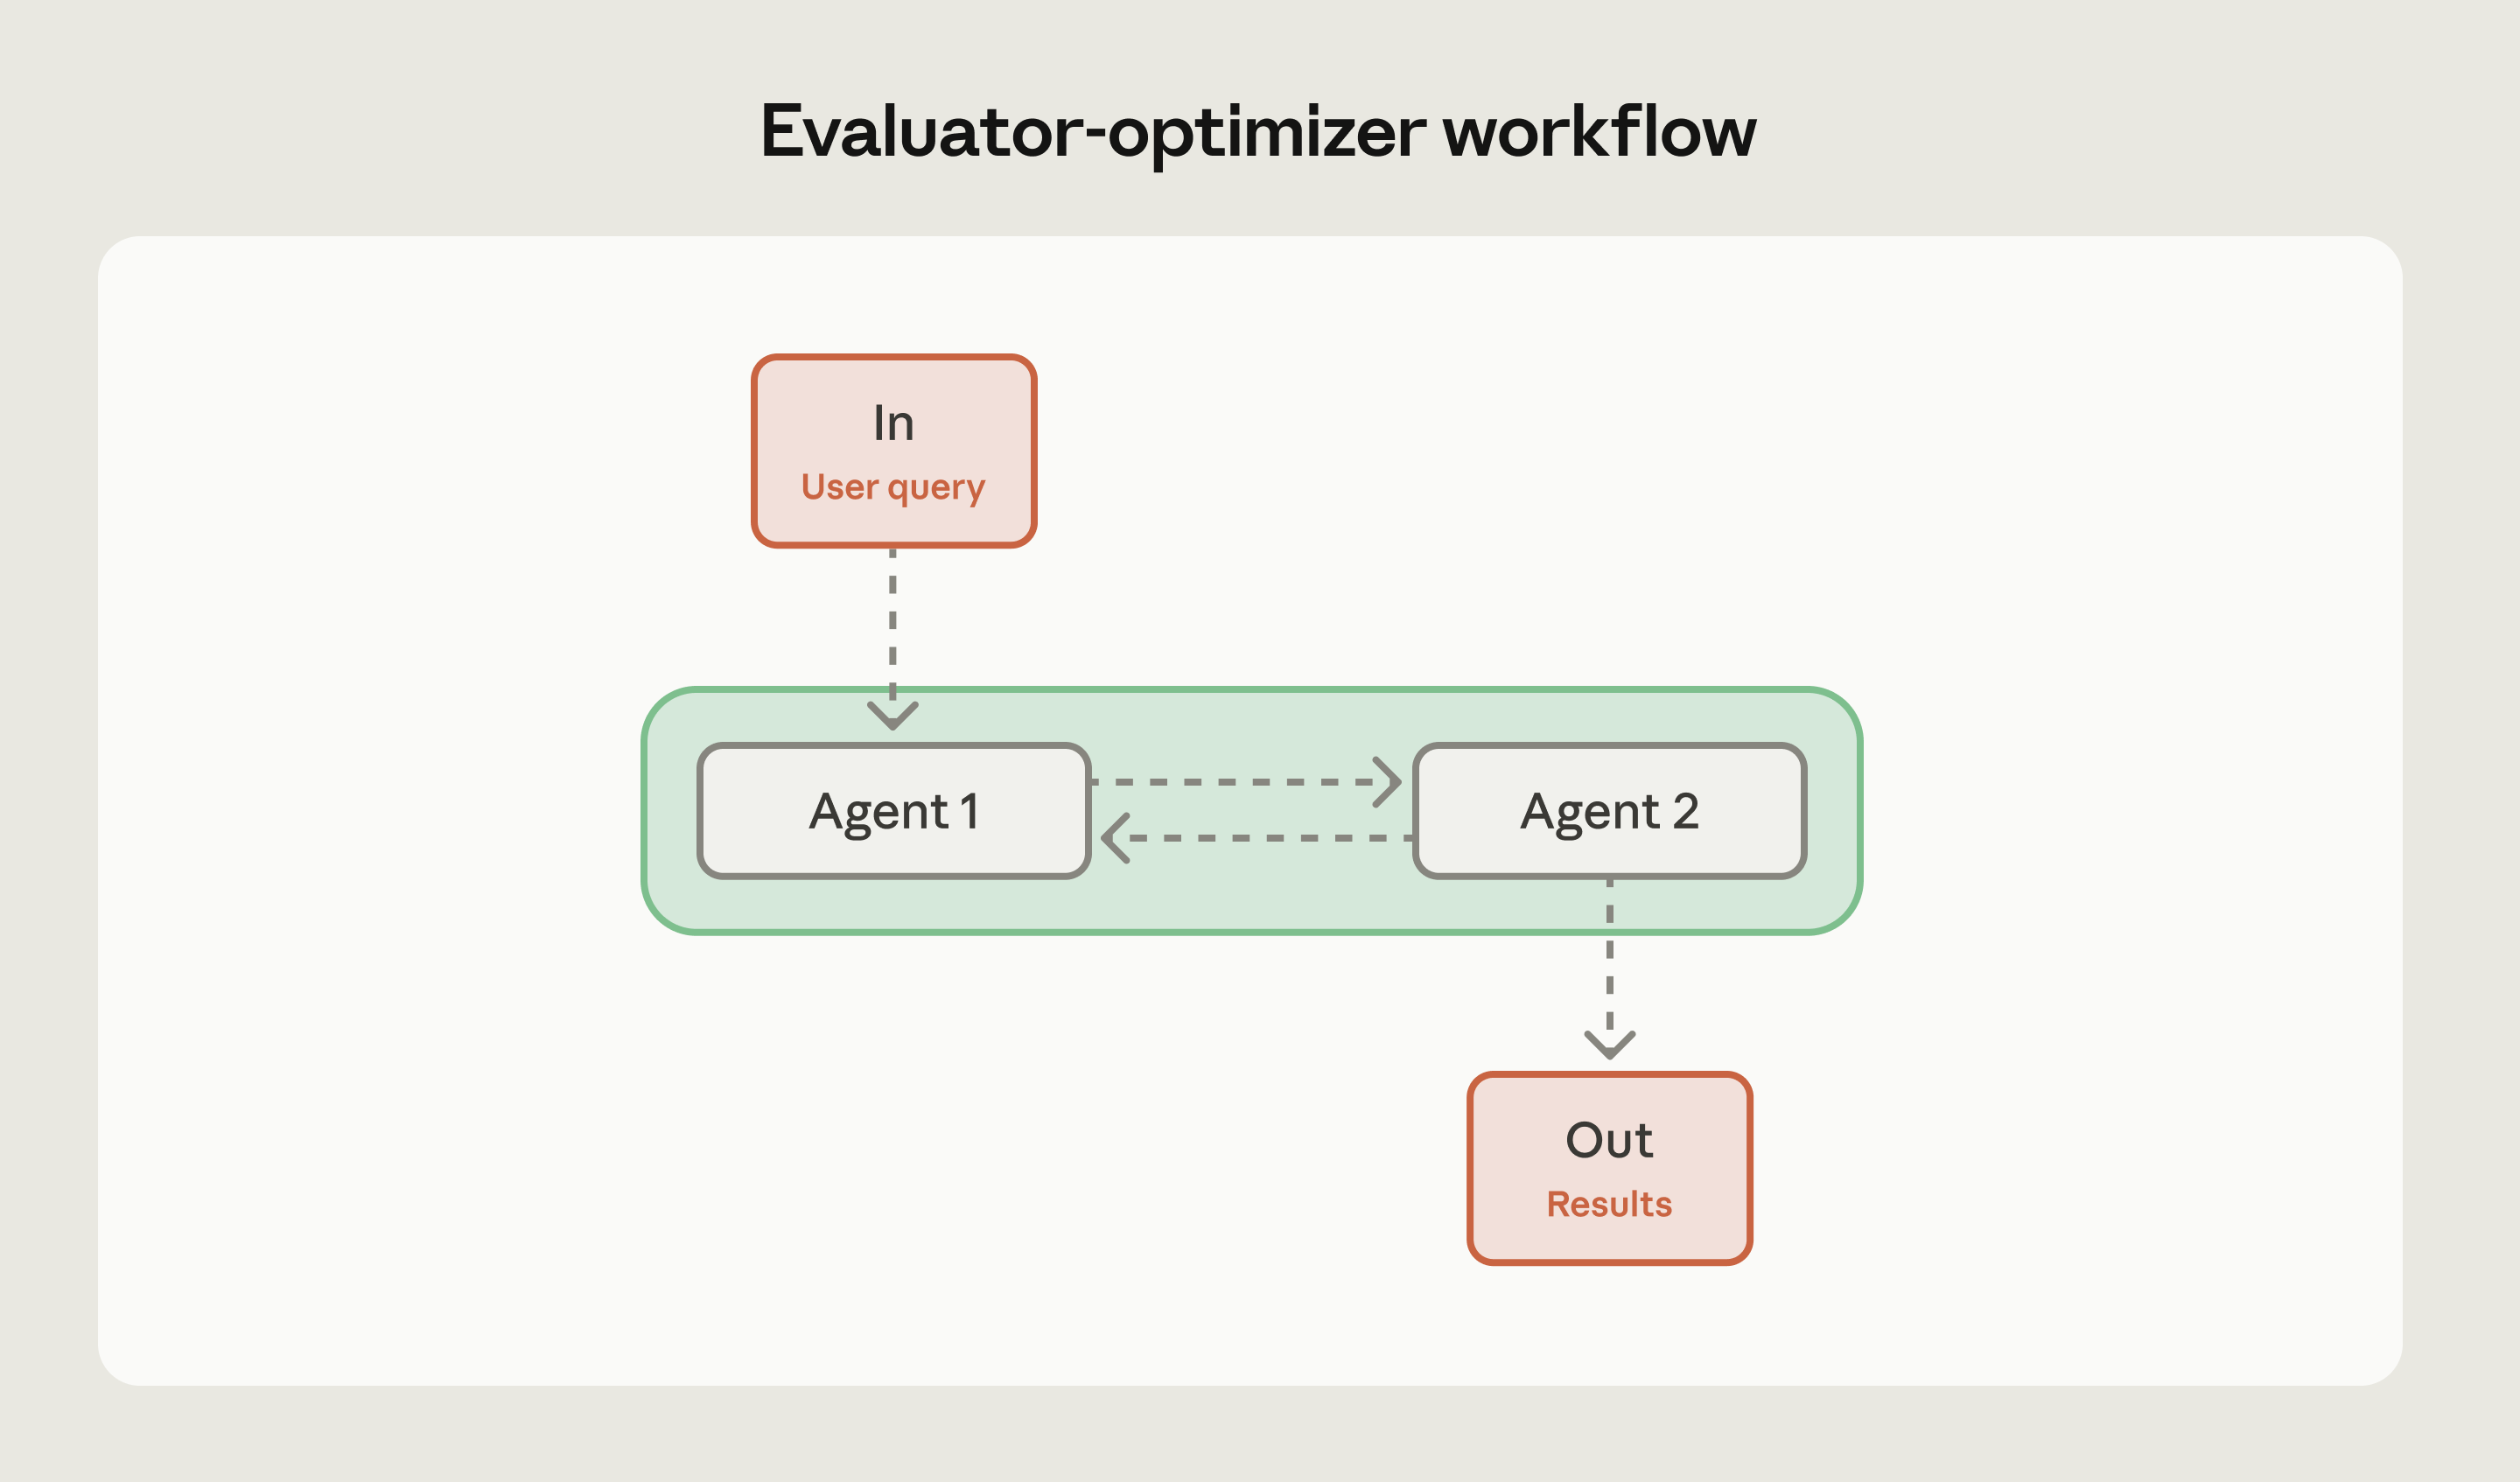
Quand utiliser : ce modèle fonctionne lorsque vous avez des critères de qualité clairs et mesurables qu'un évaluateur IA peut appliquer de manière cohérente, et lorsque l'écart entre la qualité du premier essai et la qualité finale est suffisamment significatif pour justifier les jetons et la latence supplémentaires.
Envisagez les flux de travail évaluateur-optimiseur pour :
- Génération de code avec des exigences spécifiques (normes de sécurité, bancs d'essai de performances, directives de style)
- Communications professionnelles où le ton et la précision sont importants
- Tout scénario dans lequel la qualité de la première ébauche est systématiquement inférieure aux exigences
Quand les éviter : évitez les flux de travail évaluateur-optimiseur lorsque la qualité du premier essai répond déjà à vos besoins : vous gaspillez des jetons en itérations inutiles. N'utilisez pas ce modèle pour les applications en temps réel nécessitant des réponses immédiates, les tâches simples de routine comme une classification de base, ou lorsque les critères d'évaluation sont trop subjectifs pour qu'un évaluateur IA les applique de manière cohérente. S'il existe des outils déterministes (comme les analyseurs syntaxiques pour le style de code), utilisez-les à la place. Évitez également ce modèle lorsque les contraintes de ressources l'emportent sur les améliorations de qualité.
Exemple : les flux de travail évaluateur-optimiseur fonctionnent bien pour :
- Générer de la documentation de l'API (le générateur rédige la documentation, l'évaluateur vérifie l'exhaustivité, la clarté et la précision par rapport à la base de code)
- Créer des communications clients (un générateur rédige un e-mail, un évaluateur vérifie le ton et la conformité aux politiques)
- Produire des requêtes SQL (le générateur écrit la requête, l'évaluateur vérifie les problèmes d'efficacité et de sécurité)
Conseil de pro : définissez des critères d'arrêt clairs avant de commencer à itérer. Définissez le nombre maximal d'itérations et des seuils de qualité spécifiques. Sans ces garde-fous, vous risquez de vous retrouver dans des boucles coûteuses où l'évaluateur continue de trouver des problèmes mineurs et où le générateur continue d'apporter des ajustements, mais la qualité plafonne bien avant que vous ne mettiez fin à l'itération. Sachez quand assez bien est assez bien.
Choisir le modèle de flux de travail approprié
Le modèle de flux de travail approprié dépend de la structure de votre tâche, de vos exigences de qualité et de vos contraintes en ressources.
Avant de choisir un modèle, essayez d'abord la tâche en un seul appel d'agent. Si cela répond à votre critère de qualité, vous avez terminé. Sinon, identifiez ses lacunes : cela vous indiquera quel modèle rechercher.
Voici quelques questions pour vous aider à décider :
- Un seul agent peut-il gérer cette tâche efficacement ? Si oui, n'utilisez pas du tout les flux de travail.
- La tâche a-t-elle des dépendances séquentielles claires ? Utilisez les flux de travail séquentiels.
- Les sous-tâches peuvent-elles être traitées indépendamment et simultanément, et un traitement plus rapide serait-il plus utile ? Envisagez les flux de travail parallèles.
- Le raffinement itératif permet-il d'améliorer sensiblement la qualité ? Envisagez les modèles évaluateur-optimiseur.
Une fois que vous avez sélectionné un modèle, considérez les éléments suivants :
- Gestion des échecs : définissez un comportement de secours et une logique de nouvelle tentative pour chaque étape.
- Contraintes de latence et de coûts : elles déterminent le nombre d'agents que vous pouvez exécuter et le nombre d'itérations que vous pouvez vous permettre.
- Mesurer l'amélioration : définissez une base de référence avec un seul agent pour pouvoir déterminer si le flux de travail est réellement utile.
Combinaison de modèles : ces modèles ne s'excluent pas mutuellement. Vous pouvez les imbriquer lorsque la complexité l'exige.
- Un flux de travail évaluateur-optimiseur peut utiliser l'évaluation parallèle où plusieurs évaluateurs évaluent simultanément différentes dimensions de qualité.
- Un flux de travail séquentiel peut inclure un traitement parallèle à certaines étapes où plusieurs opérations indépendantes se produisent avant de passer à l'étape suivante.
La clé est de faire correspondre la complexité des modèles aux exigences réelles. N'ajoutez pas le traitement parallèle simplement parce que vous le pouvez : ajoutez-le lorsque l'exécution simultanée présente des avantages clairs. N'implémentez pas de boucles évaluateur-optimiseur à moins qu'elles n'améliorent la qualité des résultats d'une manière mesurable.
Faites évoluer vos flux de travail de manière réfléchie
Notre meilleur conseil : commencez par le modèle le plus simple qui fonctionne. Si un flux de travail séquentiel gère votre cas d'utilisation, n'ajoutez pas de parallélisation. Si la qualité obtenue dès le premier essai est suffisante, ignorez la boucle évaluateur-optimiseur.
Ces trois modèles vous fournissent des chemins de mise à niveau clairs à mesure que les besoins changent. Un flux de travail séquentiel peut intégrer un traitement parallèle aux étapes qui constituent des goulots d'étranglement. Une approche agentique peut ajouter une évaluation lorsque les normes de qualité se renforcent, et ces modèles étant modulaires, vous n'avez pas besoin de réécrire complètement.
Pour obtenir des conseils de mise en œuvre, des exemples détaillés et des modèles avancés, y compris les approches hybrides, consultez notre livre blanc complet :Créer des agents IA efficaces : modèles d'architecture et cadres de mise en œuvre.
Développez sur Claude Developer Platform dès aujourd'hui.