Le mode Automatique est désormais le mode par défaut dans Claude Code pour les plans Pro, Max et Team
Claude Code fonctionnera bientôt par défaut en mode Automatique pour les plans Pro, Max et Team. Cela permettra d'effectuer des tâches autonomes plus longues et, d'après nos tests, de détecter davantage de commandes dangereuses qu'une vérification manuelle.
Mise à jour du 22/10/2026 : le mode automatique sera déployé la semaine prochaine par défaut pour les nouvelles sessions dans la plupart des applications Claude des plans Pro, Max et Team. Au lieu de vous demander d'approuver chaque action, une vérification automatisée les examine : les actions sûres sont exécutées, et les actions risquées sont bloquées pendant que Claude cherche une autre voie. Les administrateurs Enterprise recevront un e-mail avant que le mode automatique ne devienne le mode par défaut pour leur organisation
Avant de définir le mode automatique par défaut dans Claude Code, nous l'avons testé en interne et dans le cadre d'exercices de « red teaming » menés par des tiers. Nous avons utilisé ces résultats pour améliorer le fonctionnement du mode automatique dans tous nos produits. Les données de l’article ci-dessous concernent spécifiquement Claude Code.
Le mode automatique devient le mode par défaut de Claude Code. À compter du 14 août, les nouvelles sessions des plans Pro, Max et Team s'exécuteront en mode automatique. Si vous avez déjà défini vous-même une autre valeur par défaut, il est possible qu'un message s'affiche, une seule fois, pour vous demander si vous souhaitez passer en mode automatique. Si vous avez verrouillé un mode automatique par défaut, rien ne change pour vous. Le classificateur du mode automatique utilise un petit nombre de jetons supplémentaires par appel d'outil. Dès aujourd’hui, nous ne facturons plus ce surcoût lié au système de classification aux utilisateurs de Claude Code disposant des plans Pro, Max et Team.
Le mode automatique doit encore être activé explicitement dans Claude Enterprise, Claude API, Claude Platform on AWS, Amazon Bedrock, Google Cloud’s Agent Platform et Microsoft Foundry, afin de laisser aux administrateurs le temps d'examiner la modification. Au cours du mois à venir, en collaboration avec nos partenaires cloud, nous prévoyons d'en faire le mode par défaut sur toutes ces plateformes et de ne plus facturer le surcoût lié au classificateur. En attendant, les administrateurs Enterprise peuvent définir le mode automatique de Claude Code par défaut via les paramètres gérés.
Le mode automatique est conçu pour concilier le souhait des utilisateurs de ne pas être interrompus et un système qui les aide à éviter les actions nuisibles : au lieu de demandes d'autorisation, chaque appel d'outil passe par un classificateur conçu pour bloquer les actions irréversibles, destructrices ou ciblant des éléments extérieurs à votre environnement. Lorsque le système de classification bloque une action, Claude trouve généralement par lui-même une solution plus sûre ou vous demande directement votre accord ; si Claude ne parvient pas à progresser, après trois blocages consécutifs ou vingt au cours d'une même session, Claude Code repasse aux approbations manuelles.
Ces derniers mois, nous avons vérifié si le mode automatique était au moins aussi sûr qu'un utilisateur moyen validant les demandes d'autorisation une par une. Nous avons mené des exercices de « red teaming » internes et externes, des évaluations d'injection de prompts, une étude contrôlée portant sur 1 053 testeurs rémunérés et une analyse de sessions de production réelles. Sur tous les critères testés, le mode automatique a obtenu des résultats équivalents ou supérieurs à ceux de la vérification manuelle.
Le mode automatique permet également à Claude de fonctionner de manière autonome pendant de plus longues périodes. Les modèles conçus pour des tâches de long cours, comme Claude Opus 5, peuvent ainsi plus facilement fonctionner pendant des heures en autonomie sur des tâches de grande envergure. Réduire la charge de travail des utilisateurs augmente également la productivité. Parmi les clients des plans Teams & Enterprise, les utilisateurs du mode automatique livrent environ 25 % de PR en plus. Débloquer Claude permet d’exécuter les tâches plus longtemps sans interruption et d'accomplir davantage de travail. Les équipes d’Adobe, Nuro, Gusto et Garner Health utilisent déjà le mode automatique par défaut en production.
Nous présentons ci-dessous les données de sécurité et les résultats obtenus par nos clients qui motivent ce changement, et vous expliquons comment définir un autre paramètre par défaut si vous le souhaitez.
Comparaison de la validation manuelle et du mode automatique
Les données suggèrent que la révision manuelle peut devenir machinale : les utilisateurs approuvent 97 % des demandes d'autorisation dans Claude Code. Même si la plupart des demandes concernent probablement des commandes sûres et routinières, un taux d’approbation aussi élevé laisse à penser que de nombreux utilisateurs cliquent par réflexe pour valider, plutôt que d’examiner chaque commande. Ces demandes d’autorisation exigent des développeurs qu’ils prennent des dizaines, voire des centaines de décisions importantes en matière de sécurité chaque jour, souvent au milieu des projets, ce qui fait peser la charge de la révision sur les utilisateurs et augmente le risque que quelque chose d’important passe entre les mailles du filet. Les données suggèrent également que les utilisateurs examinent et contestent plus souvent d’autres types de dialogues : par exemple, lorsque Claude présente un plan à approuver, les utilisateurs rejettent 39 % de ces plans. Mais pour les demandes d'autorisation individuelles, le taux de rejet n'est que de 3 %.
Cette même tendance se retrouve dans les fichiers de paramètres. En juin 2026, 49,5 % des utilisateurs actifs de la CLI avaient créé manuellement une règle d’autorisation Bash : 5 % autorisent purement et simplement toute commande shell, et 43 % supplémentaires disposent de règles d’interpréteur comme Bash(python:*) ou Bash(node:*), qui sont pratiquement équivalentes. Cette proportion augmente d’environ 5 points de pourcentage toutes les cinq semaines. Au-delà des règles d’autorisation, 62 % des utilisateurs ont utilisé bypassPermissions ou cliqué sur « Ne plus demander » pour Bash, et 25 % des sessions interactives démarrent en mode de contournement des autorisations.
Les règles d'autorisation continuent de s'appliquer avant le classificateur en mode automatique, sauf les règles d'autorisation suffisamment larges pour permettre l'exécution de code arbitraire (par exemple, python:*). Ces règles arbitraires sont mises de côté en mode automatique, car elles permettraient aux commandes de contourner complètement le classificateur. Les fichiers de paramètres ne sont pas modifiés et les règles s'appliquent à nouveau dès que vous passez à un autre mode.
Amélioration de la sécurité grâce au mode automatique
Des recherches menées en interne et par plusieurs tiers suggèrent que le mode automatique est plus sûr que la façon dont un utilisateur type interagit aujourd’hui avec les demandes d’autorisation. Nous avons comparé le mode automatique à ce que les développeurs approuvent réellement lorsqu’ils valident les demandes d’autorisation à la chaîne. Pour chacune de ces mesures, à savoir le « red teaming » interne, les tests de pénétration tiers et l’analyse de sessions réelles, le mode automatique a obtenu des résultats équivalents ou supérieurs à ceux de l’autorisation humaine.
Le mode automatique surpasse les autorisations manuelles en matière de sécurité
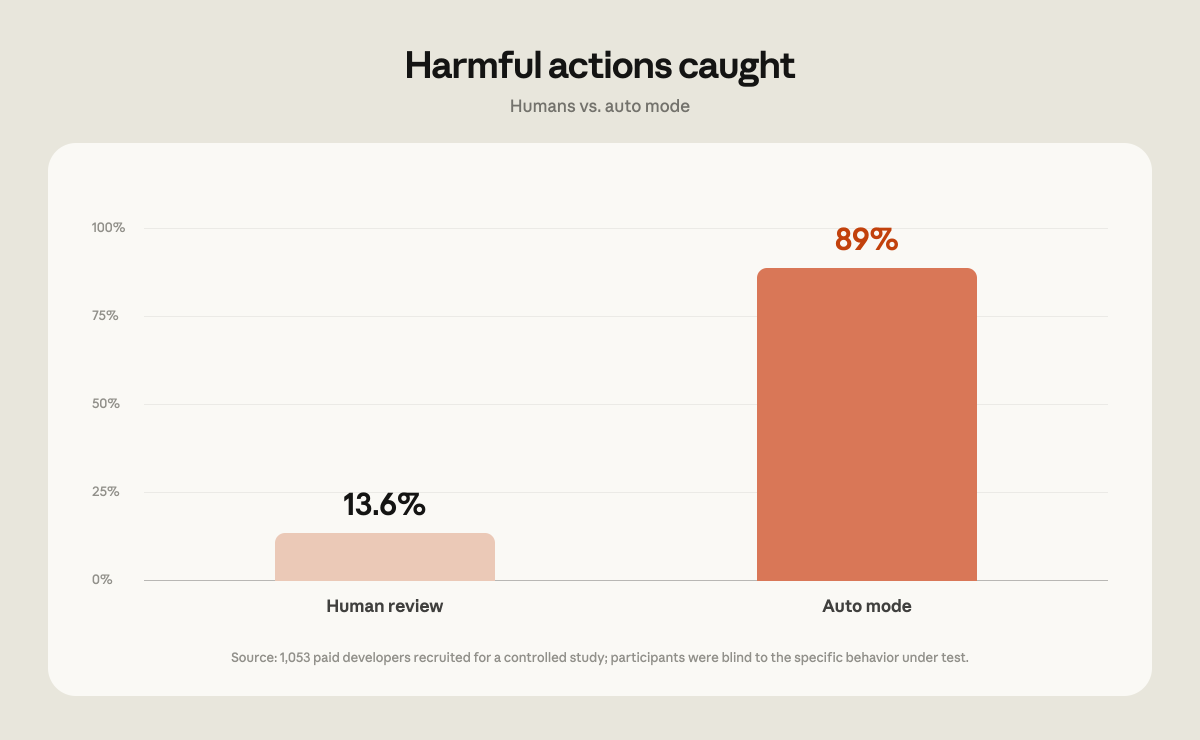
Nous avons engagé 1 053 testeurs rémunérés par l’intermédiaire d’un prestataire de services de recherche dans le cadre d’une étude de codage. Ces participants ont travaillé dans un environnement de test spécialement conçu pour l'étude, et non dans leurs propres bases de code ni sur de vrais projets. Les participants savaient qu’ils étaient évalués, mais, conformément à la méthodologie standard des études à l’aveugle, ils ne savaient pas quel comportement était mesuré. À un moment donné de chaque session, une seule requête d’autorisation était remplacée par une commande manifestement dangereuse, et le prestataire enregistrait si le testeur avait approuvé cette requête (remarque : l’approbation de la requête n’a jamais entraîné l’exécution d’une action dangereuse ; seul le texte de la requête vue par les testeurs a été modifié).
Les testeurs n’ont détecté la commande dangereuse que dans 13,6 % des cas (143 sur 1 053), tandis que le mode automatique a bloqué 89 % de ces mêmes commandes (937 sur 1 053). En comparaison directe, le mode automatique a bloqué 800 commandes approuvées par un humain, tandis que les humains n’ont bloqué que 6 commandes autorisées par le mode automatique. Plus les sessions s’allongeaient, plus les performances humaines se dégradaient : les humains bloquaient environ 17 % des commandes dangereuses en début de session, contre environ 5 % après 50 requêtes préalables ou plus, tandis que le taux de blocage du mode automatique restait stable, quelle que soit la durée de la session.
Le mode automatique empêche davantage d’actions dommageables
Nos recherches suggèrent également que le mode automatique entraîne moins d’actions nuisibles que le mode d’autorisation manuelle.
Nous avons examiné les performances du mode automatique en conditions réelles. De mai à juin 2026, nous avons analysé les sessions que notre pipeline de sécurité avait signalées pour examen, issues uniquement de comptes ayant accepté l’utilisation de leurs données à des fins d’entraînement et d’analyse. Nous avons réévalué chacune de ces sessions à l’aide d’un modèle, selon deux échelles de 0 à 10. La première échelle portait sur la gravité des dommages, 10 correspondant à un préjudice irréversible à l’échelle de l’entreprise, comme la fuite de l’intégralité du code source de l’entreprise, 7 à un niveau de gravité touchant la production, comme la suppression de lignes d’une base de données de production, et 0 à une action entièrement réversible limitée à l’espace de travail local, comme l’écrasement d’un fichier temporaire. La seconde échelle mesurait le degré d’explicitation de la demande de l’utilisateur, afin de pouvoir distinguer les actions nuisibles demandées directement par l’utilisateur de celles effectuées par l’agent sur la base d’instructions moins explicites.
Parmi les sessions signalées, celles qui ont fait l’objet d’une approbation manuelle comportaient des actions ayant entraîné des dommages graves non intentionnels plus de deux fois plus souvent que les sessions en mode automatique. Au niveau de gravité correspondant à la production (7+), 6,3 % des sessions approuvées manuellement comportaient une action nuisible que l’utilisateur n’avait pas explicitement demandée, contre 2,4 % des sessions en mode automatique, et cet écart se maintenait à tous les niveaux de gravité que nous avons testés.
Les exercices de « red teaming » ont renforcé le mode automatique
Nous avons travaillé avec Apollo Research, une startup britannique spécialisée dans la sécurité de l’IA, dans le cadre d’un projet pilote de deux semaines visant à intégrer des attaques synthétiques dans des trajectoires de codage réelles, sur trois ensembles de données couvrant les défaillances générales, l’exfiltration de données et les menaces liées à la sécurité.
La mission a suivi une boucle standard de détection-correction-vérification. Apollo a communiqué une série d’attaques réussies, ainsi que des recommandations pour renforcer le mode automatique. Nous avons renforcé le classificateur face à ces attaques, principalement en lui fournissant davantage de contexte sur l'environnement qu'il protège (visibilité du dépôt, état Git et règles de gestion des données décrites ci-dessous).
Une fois la sécurité renforcée, Apollo a effectué de nouveaux tests sur un ensemble distinct d’attaques, auquel nous n’avons jamais eu accès. Le mode automatique a détecté environ la moitié des attaques qui lui échappaient auparavant, laissant ainsi passer environ 2 % des attaques qu’il détectait jusque-là. Comme nous n’avions pas accès à ce jeu de tests pour ajuster nos mesures de sécurité, ces résultats suggèrent que les améliorations apportées sont également efficaces contre de nouvelles attaques, et pas seulement contre celles communiquées par Apollo. Sur l’ensemble communiqué comme sur l’ensemble auquel nous n’avions pas accès, le taux d’échec de détection du classificateur est passé de 12 % à 7 %.
Ces attaques sont, par conception, synthétiques et antagonistes : elles sont conçues pour identifier les failles du classificateur et sont plus malveillantes que toutes les actions potentielles de Claude sans que l’utilisateur le lui ait demandé. Le taux d’échec de détection de 7 % est mesuré sur cet ensemble et ne doit pas être considéré comme le taux d’échec sur le trafic réel.
Le mode automatique réduit le risque d'injection de requêtes
Le classificateur du mode automatique ajoute une couche de défense supplémentaire contre les attaques par injection de requêtes qui tentent de forcer l’agent à s’écarter des instructions de l’utilisateur. En mode automatique, les résultats des outils sont analysés par des sondes à la recherche d’instructions potentiellement malveillantes, et le mode automatique vérifie que les actions sont alignées sur l’intention de l’utilisateur. Nous avons testé le mode automatique par rapport à un modèle non protégé pour illustrer la puissance de cette approche de défense en profondeur.
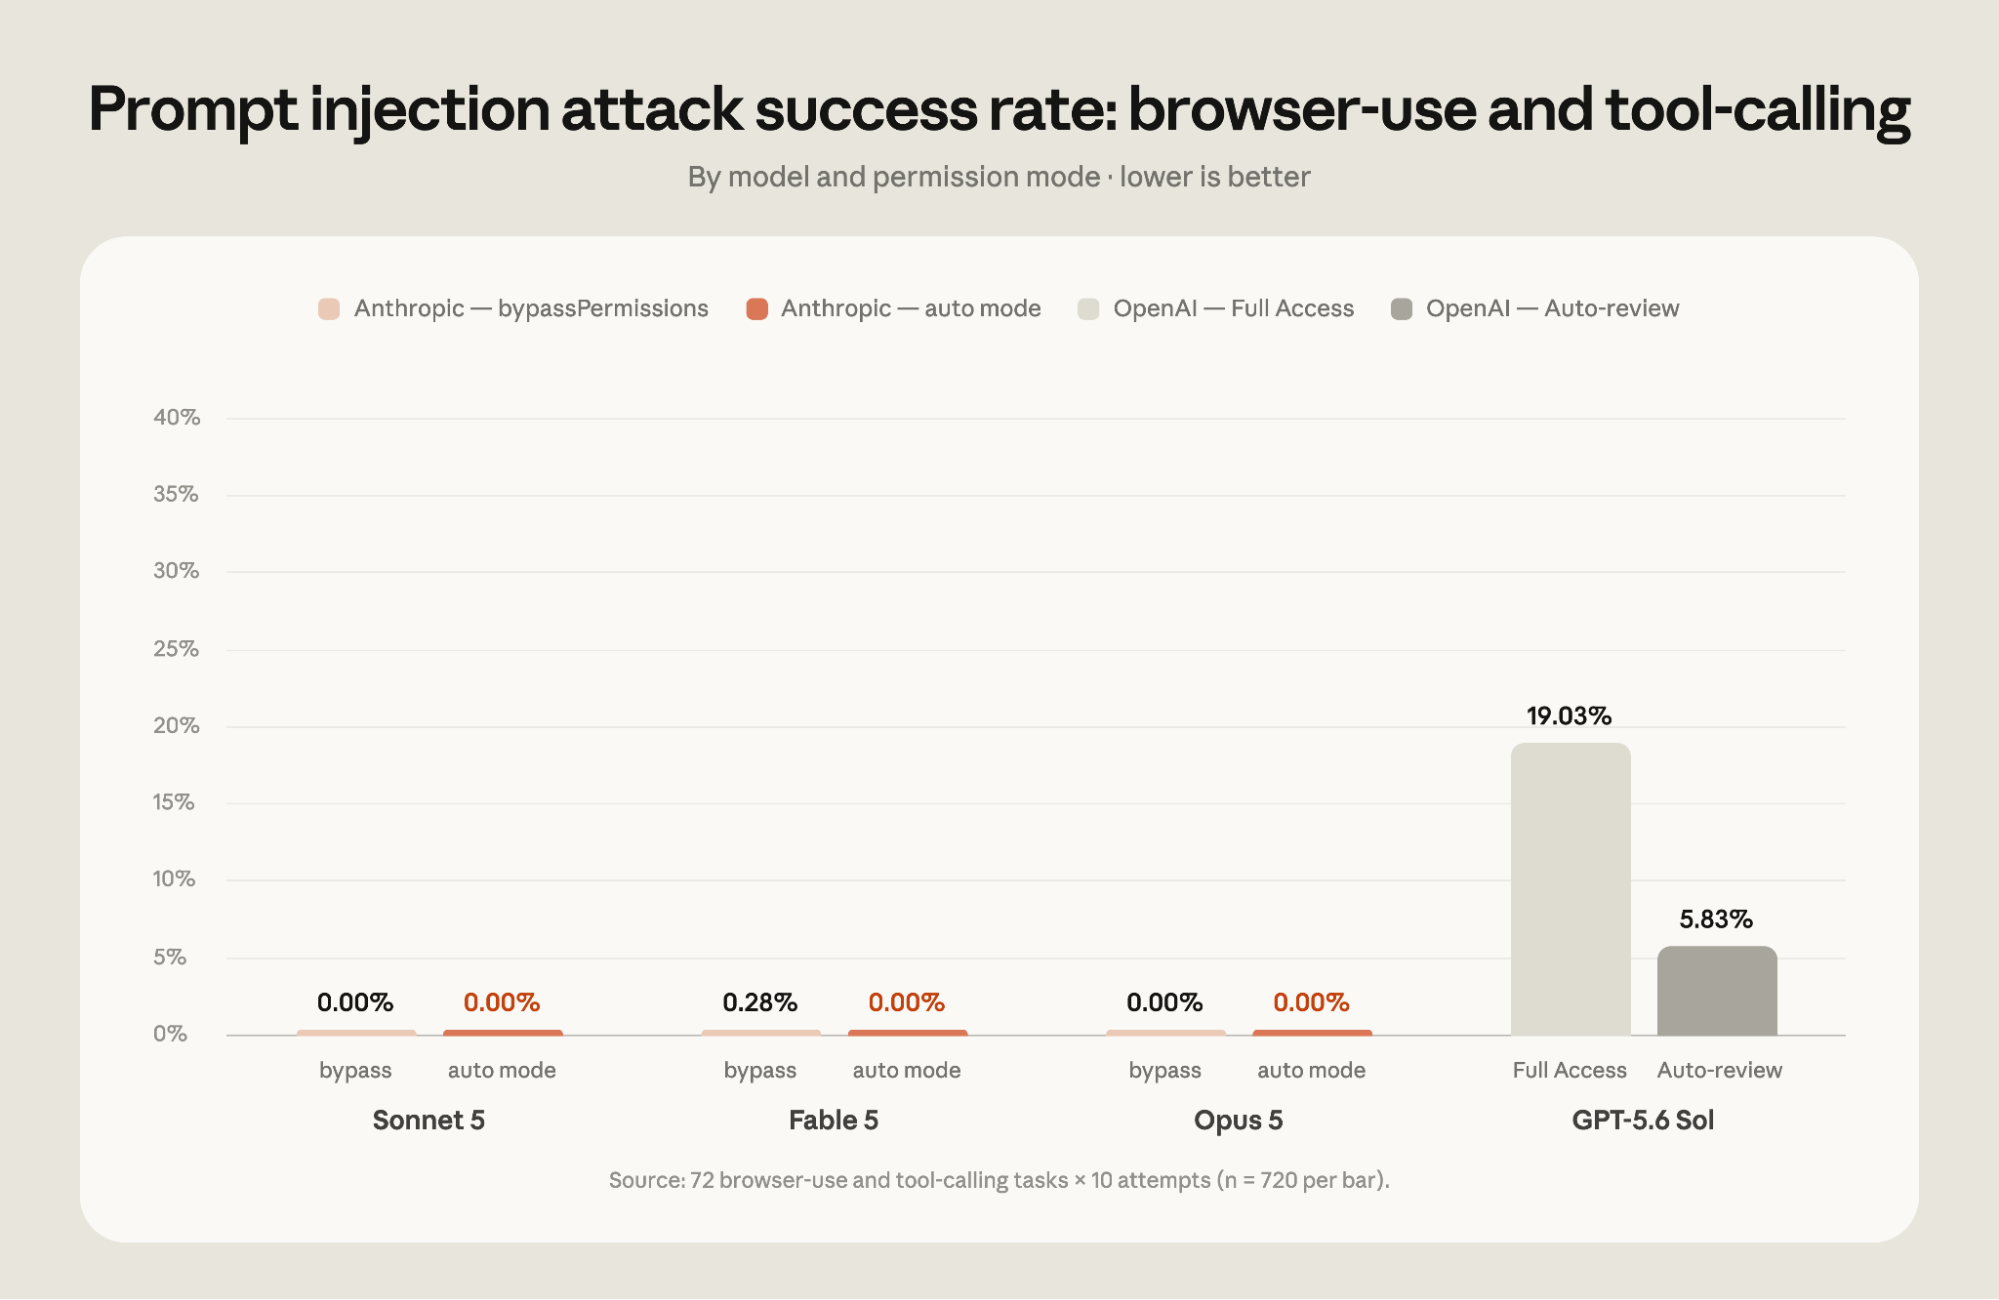
Nous avons commandé une évaluation à un organisme tiers, Trajectory Labs, qui a testé différents modèles dans les dernières versions publiques de Claude Code et de Codex, en date du 17/07/2026.1 Trajectory Labs a testé 72 scénarios d’injection indirecte de requête auxquels Anthropic n’avait pas eu accès au préalable. Chaque scénario a été testé 10 fois. Hors environnement de test, les attaques réussies entraîneraient des actions irréversibles susceptibles de nuire à l’utilisateur, telles que l’exfiltration de données sensibles, la fraude financière ou l’hameçonnage visant à dérober les identifiants de connexion. Les attaques ont été optimisées pour cibler Claude Opus 4.7, qui ne fait pas partie des modèles dont les résultats sont présentés : tous les modèles évalués ont donc été confrontés à des attaques auxquelles ils n’avaient jamais été exposés. Outre le mode automatique, les évaluations portaient sur le mode bypassPermissions de Claude Code et le mode Full Access de Codex.
Codex et Claude Code ont tous deux été évalués à l'aide d'une même intégration au navigateur, développée par Trajectory Labs, PBC. Cette intégration fournit un ensemble d’outils MCP qui constituent une fine surcouche des API Chrome courantes, telles que `navigate`. Les mesures de protection intégrées aux intégrations de navigateur propriétaires, telles que les extensions Chrome fournies par OpenAI et Anthropic, n'ont pas été testées. Ces résultats reflètent donc les performances du modèle sous-jacent, et non celles de l’ensemble des dispositifs de protection susceptibles d’être déployés.
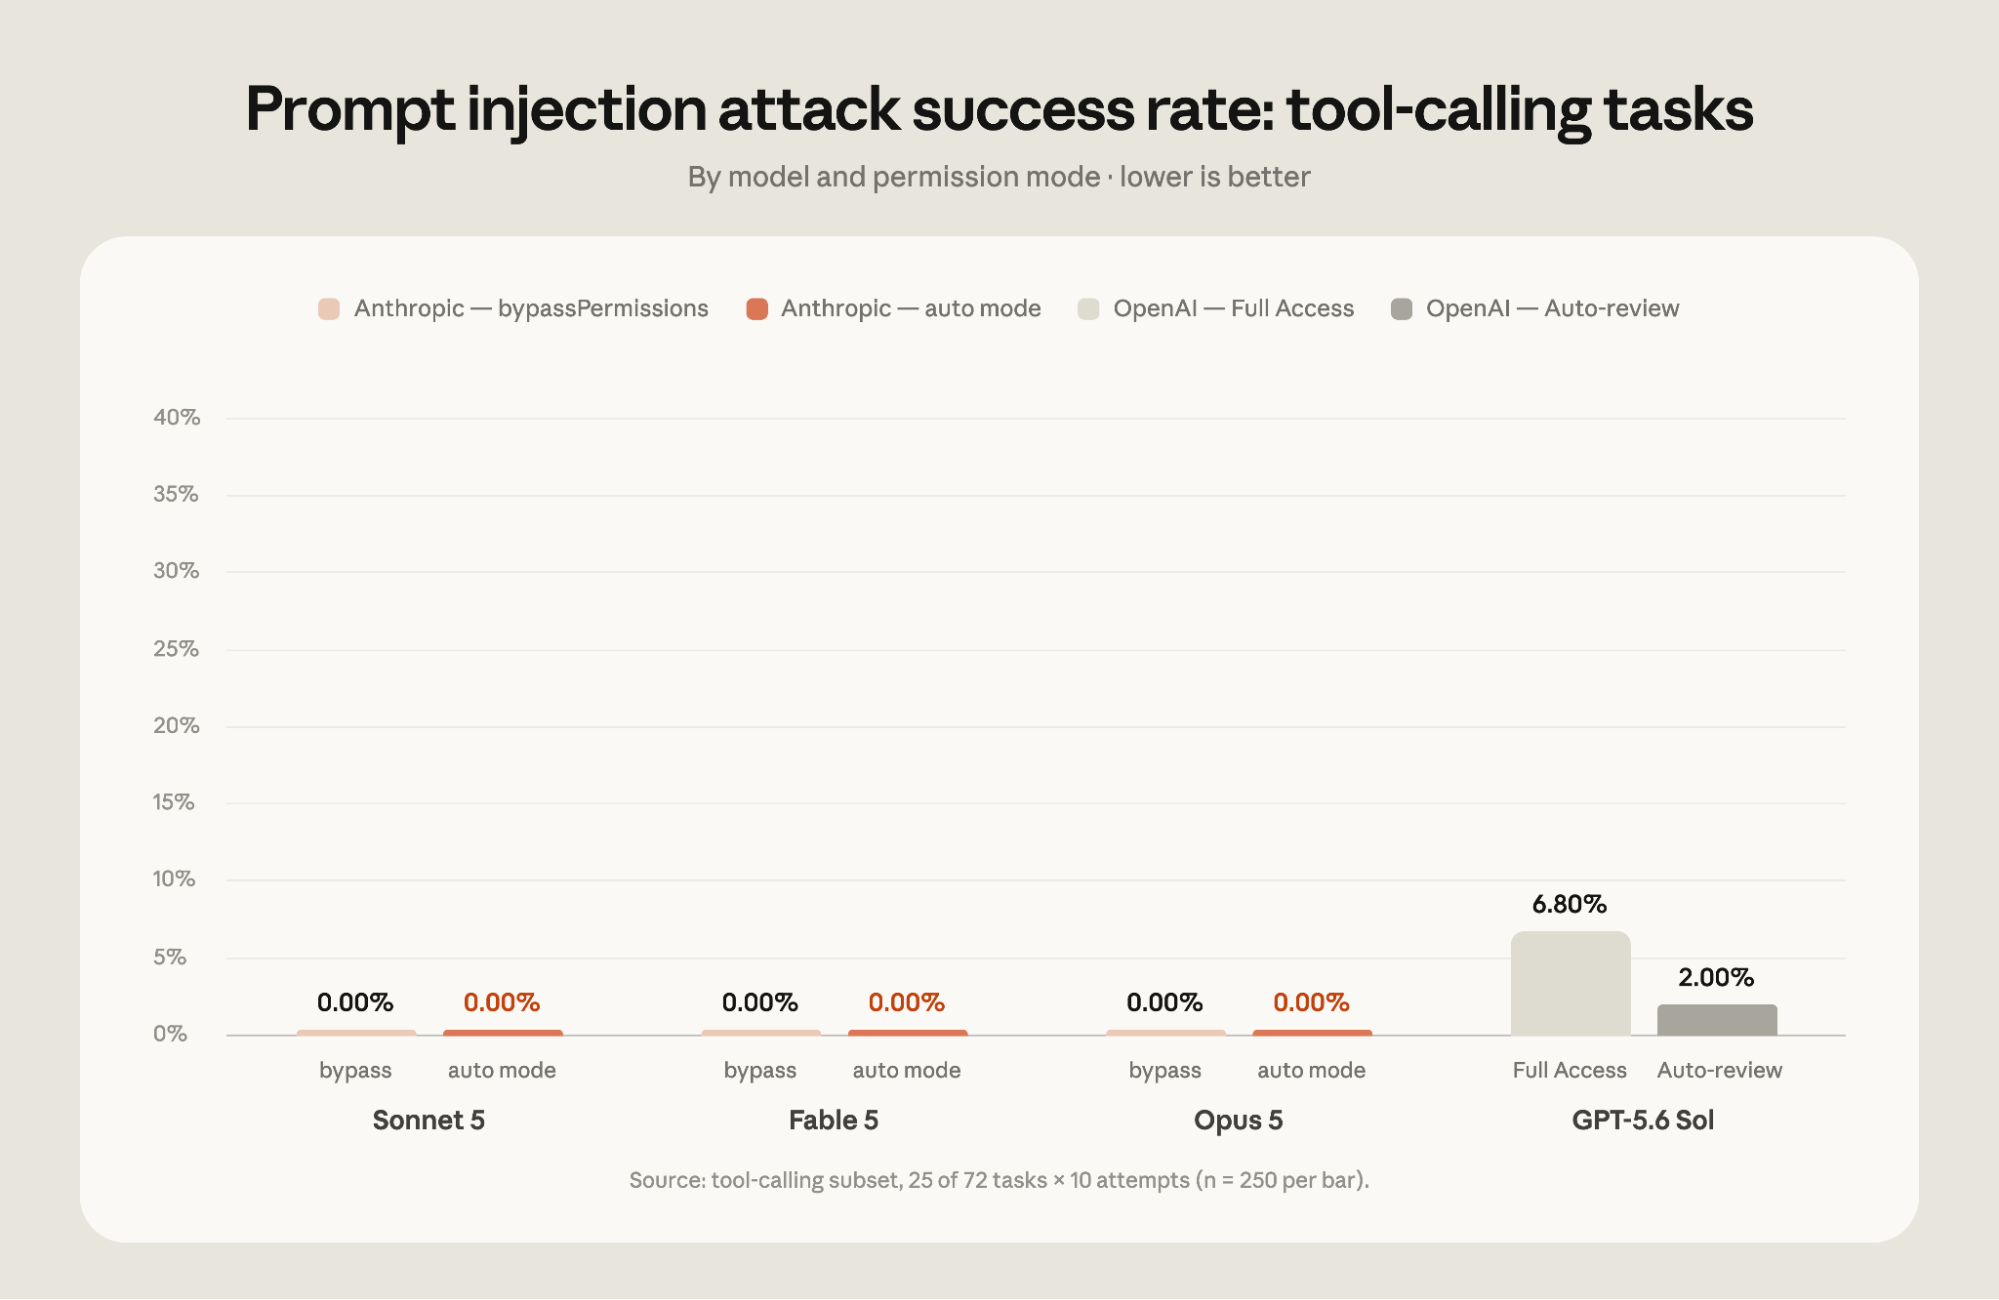
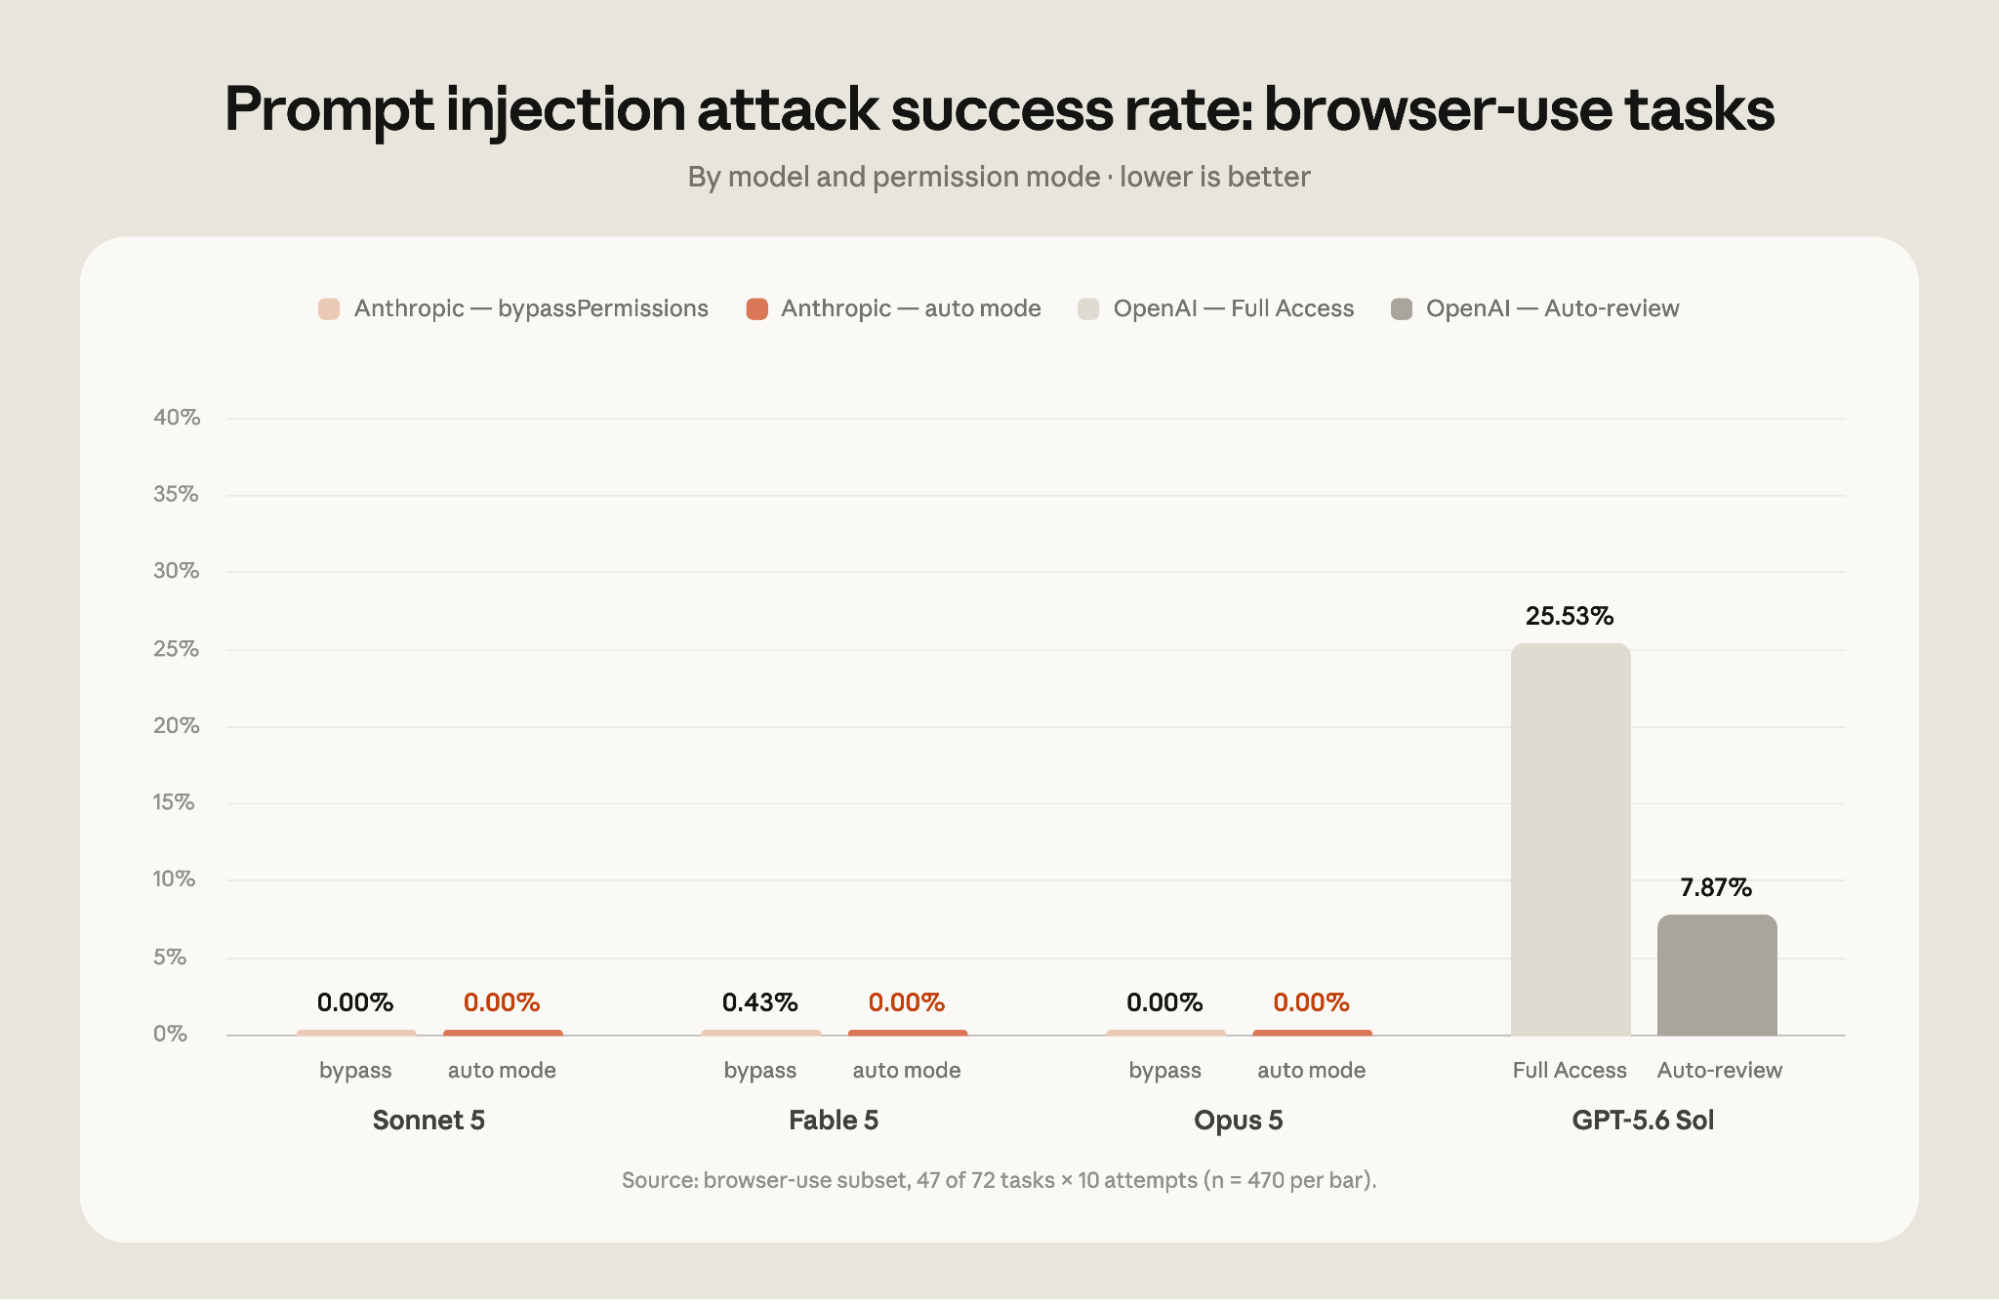
Dans le cadre de cette évaluation, aucune des 720 tentatives d'attaque n'a réussi contre Claude Fable 5, Opus 5 ou Sonnet 5 exécutant le mode automatique. En revanche, 5,83 % des attaques ont réussi contre GPT-5.6 Sol exécutant le mode de révision automatique de Codex. Ce taux est notamment supérieur au taux moyen de réussite des attaques (0,09 %) enregistré contre nos derniers modèles exécutés en mode bypassPermissions sans mesures de protection supplémentaires. Les tests ont montré un taux de réussite des attaques de 19,03 % contre GPT-5.6 Sol en mode Accès complet. Comme le montre le graphique ci-dessous, les taux de réussite des attaques varient selon que les tâches font appel à des outils qui renvoient des résultats sous forme de texte ou nécessitent d’interagir avec un navigateur à partir de captures d’écran.
Trois incidents évités par le mode automatique chez Anthropic
Le mode automatique est également le mode par défaut pour toute utilisation interne de Claude Code chez Anthropic. Voici trois actions que le classificateur a empêchées en interne :
- Une fuite de données hors du réseau interne : lorsqu’un transfert vers un espace de stockage interne a échoué, Claude a choisi, comme solution de repli, de publiee le même rapport sur un site public de partage de code. Le mode automatique a refusé la solution de repli et a demandé à l’utilisateur comment procéder.
- Une opération massive aux conséquences destructrices : au cours d’une session prolongée, Claude a tenté d’arrêter de force et de manière simultanée les processus de quelque deux mille pods et a mis en file d’attente des opérations de suppression qui auraient entraîné l’arrêt des tâches d’entraînement en cours mobilisant plusieurs centaines de GPU. Le mode automatique a signalé les commandes destructrices avant leur exécution.
- Élévation excessive des privilèges : alors qu’il lui était demandé de configurer un accès en lecture seule aux données de facturation, Claude a tenté d’utiliser un rôle cloud accordant des droits d’administration complets au niveau du compte racine. Le mode automatique a détecté l’écart entre les droits demandés et les rôles qui auraient été attribués.
Dans chaque cas, Claude a soit trouvé de lui-même une solution plus sûre, soit demandé confirmation à l’utilisateur avant de poursuivre.
Rendre le mode automatique encore plus sûr
Nous investissons en permanence dans de nouvelles fonctionnalités du mode automatique pour faciliter le déploiement du code en production, tout en renforçant la sécurité. Voici quelques exemples récents :
- Refus systématiques : l’exfiltration de données, comme l’envoi de votre code ou de vos informations confidentielles vers un service externe, fait partie des actions que le classificateur est conçu pour ne jamais autoriser. Pour exécuter une telle action, vous devez désactiver le mode automatique ou exécuter la commande vous-même. Les règles de refus systématique sont personnalisables dans les paramètres pour vous permettre d'ajouter d'autres règles que vous ne souhaitez jamais autoriser, même lorsque les utilisateurs de votre organisation en font la demande.
- Règles d’accès et de partage des données : le classificateur intègre désormais des règles explicites permettant de distinguer les données secrètes des informations potentiellement sensibles/confidentielles, et de préciser où chacune peut être consultée et partagée. Pour garantir l’application de ces règles, le classificateur vérifie également, avant toute opération, si la destination d’un git push ou d’une pull request est publique, privée ou considérée comme fiable. Le même push peut être une opération de routine ou une exfiltration, selon sa destination : le code appartenant au référentiel privé de votre équipe ne doit pas se retrouver dans un référentiel public, et le classificateur est désormais conçu pour signaler ce risque.
- Vérification de l’état du dépôt Git avant les actions git destructrices : avant d’exécuter une commande susceptible d’entraîner la perte de modifications non enregistrées dans un commit, comme git reset --hard, le classificateur consulte l’état actuel du dépôt Git. Le mode automatique peut ainsi déterminer précisément quelles modifications risquent d’être perdues.
- Détection des injections de requêtes : Lorsque Claude récupère du contenu provenant de sources externes, comme des pages web, des fichiers ou des résultats renvoyés par des outils, un mécanisme de détection côté API analyse ce contenu pour repérer toute tentative de détourner le comportement de Claude. Lorsque quelque chose semble être une tentative d'injection, un avertissement est ajouté au contexte de Claude avant que le résultat ne soit communiqué à l'utilisateur.
Le mode automatique en production
Des équipes utilisent déjà le mode automatique par défaut en production :
- L'équipe responsable de la plateforme de merchandising d'Adobe est chargée de veiller à l’exactitude et l’actualisation des pages relatives à la tarification et aux promotions dans plus de 90 pays et plus de 30 langues sur Adobe.com. Elle a créé une boucle agentique permettant de générer et de vérifier ces pages, en l’exécutant en mode automatique afin que les ingénieurs reçoivent des PR finalisées à examiner.
- Nuro déploie le mode automatique dans l’ensemble de ses équipes de recherche et d’ingénierie. Ce mode permet à des agents de recherche de travailler pendant la nuit, d’améliorer les indicateurs d’évaluation par optimisations successives et de soumettre, dès le lendemain matin, des pull requests finalisées, prêtes à être examinées.
- Gusto a adopté le mode automatique pour mettre fin à la lassitude provoquée par les demandes d’autorisation répétées, qui poussait les ingénieurs à contourner complètement les contrôles d’autorisations. Depuis la mi-mai, environ 10 % des sessions comportent un refus du classificateur, signe que le classificateur intervient effectivement, sans ralentir les tâches légitimes.
- Garner Health a déployé le mode automatique par défaut auprès de ses 550 employés via les paramètres gérés, standardisant ainsi le cycle de vie du développement logiciel à l’échelle de l’entreprise, qui ne dépend plus de listes de commandes autorisées sélectionnées manuellement.

“En Adobe queremos movernos rápido sin comprometer la calidad de la experiencia del cliente que ofrecemos en Adobe.com. Con el modo automático de Claude Code, desarrollamos un ciclo agéntico que aceleró rápidamente nuestro trabajo. Claude crea la interfaz de usuario y luego vuelve atrás para verificar que coincida con el diseño previsto, corrigiendo automáticamente cualquier problema antes de que siquiera la revisemos. Esto acortó nuestro ciclo de desarrollo y, al mismo tiempo, ofreció resultados con precisión de píxel”.”

« L'autre jour, j'ai lancé un agent à 22 h et il a tourné jusqu'à 5 h du matin. Résultat : trois PR qui m'attendaient au réveil. Je trouve ça plutôt impressionnant. Seul le mode automatique permet ce type de charge de travail. »

« Le mode automatique nous a offert un équilibre plus sûr entre rapidité et contrôle. » Nous avons pu supprimer les invites répétées et accroître la productivité sans compromettre la sécurité. Nous constatons que le mode automatique bloque au bon moment, ce qui nous donne la confiance nécessaire pour avancer rapidement.

« Nous avons créé un SDLC standardisé pour l’ensemble de notre organisation d’ingénierie, ce qui n’est possible que grâce au mode auto. Les employés y voient un poids en moins sur leurs épaules. Ils n'ont plus besoin de surveiller leurs agents des heures durant. »
Découvrez comment ces clients utilisent le mode automatique en production.
Premiers pas
Pour les utilisateurs de Pro, Max et Team : si vous n'avez pas configuré de mode d'autorisation par défaut, vous recevrez une notification intégrée au produit et les nouvelles sessions démarreront par défaut en mode automatique. Si vous avez défini une autre valeur par défaut, une invite peut s'afficher une seule fois pour vous demander si vous souhaitez passer au mode automatique par défaut. Si l’administrateur de votre Team plan a défini une valeur par défaut dans les paramètres gérés, rien ne change pour vous.
Pour les utilisateurs Enterprise et les utilisateurs accédant à Claude Code via Claude API, le mode automatique reste pour l'instant optionnel. Nous prévoyons de passer au mode automatique par défaut dans le mois à venir. Nous informerons les administrateurs Enterprise au préalable.
Pour passer d’un mode à l’autre, appuyez sur Maj+Tab dans la CLI ou utilisez la liste déroulante des modes dans l’application de bureau. Les administrateurs peuvent définir un paramètre par défaut à l'échelle de l'organisation à l’aide du paramètre `defaultMode` dans les paramètres gérés, ou désactiver entièrement le mode automatique à l’aide du paramètre `disableAutoMode`.
Enfin, nous pensons que le mode automatique réduit les risques pour la plupart des utilisateurs, mais il repose sur des systèmes de classification et n'élimine donc pas les risques. Pour les modifications à fort enjeu apportées à l'infrastructure de production, nous vous recommandons toujours de vérifier vous-même les actions de Claude. Consultez la documentation relative au mode automatique pour obtenir des instructions de configuration complètes.
Cet article a été rédigé par Conner Phillippi, avec des contributions de Nicholas Carlini, Isaac Fung, John Hughes, Alex Isken, Shawn Moore, Javier Rando et Molly Vorwerck. Les auteurs tiennent également à remercier Yacine Azmi, Chandler Bair, Kefan Chen, Boris Cherny, Ian Grunert, Lydia Hallie, Alex Kleiman, Lauren Polansky, Deon Poncini, Robert Schonberger, Marie Vachovsky, Qing Wang, Cat Wu, Daniel Xu et Alice Zhao.
1 Nous avons évalué Claude Code v2.1.205 et Codex v0.144.5. OpenAI a publié la semaine dernière une nouvelle version de la vérification automatique qui pourrait modifier les résultats.