Das KI-native SDLC-Playbook
So transformieren Sie Ihren Softwareentwicklungszyklus mit KI – Schritt für Schritt.
Code ist nicht mehr der Engpass
Unternehmen schreiben heute Code mit KI in einer Geschwindigkeit, die vor einem Jahr noch undenkbar war. Doch die Prozesse rund um den Code haben sich nicht im gleichen Tempo verändert.
Viele Engineering-Teams haben immer noch die gleichen Genehmigungsgates, Überprüfungen, Übergaben und Richtlinien. Dadurch werden Produktivitätssteigerungen behindert, die durch den Einsatz von agentischen Coding-Lösungen wie Claude Code erzielt wurden.
Der Software Development Lifecycle (SDLC) ist der Prozess, den Software von der Idee bis zur Produktion durchläuft. Die meisten Unternehmen durchlaufen eine Version derselben sechs Phasen: Planung, Design, Erstellung, Testen, Bereitstellung und Wartung von Software. Traditionell ist jede Phase eigenständig einer anderen Rolle zugewiesen. Produktmanager schreiben Anforderungen, KI-Architekten machen daraus ein Design, das von Entwicklern entwickelt, von QS-Teams regulierter Unternehmen überprüft und von Release-Teams ausgeliefert wird. Operations überwacht den Prozess. Die Arbeit fließt durch Dokumente, Tickets und Genehmigungen von einer Phase zur nächsten.
Der herkömmliche Software-Lebenszyklus (SDLC) ist prozessintensiv, um die Verantwortlichkeit und Kontrolle bei jedem Schritt zu gewährleisten. Der traditionelle SDLC wurde jedoch zur Effizienzmaximierung zu einer Zeit entwickelt, in der die zeitaufwändigste und teuerste Phase das Schreiben und Implementieren von Code war, was heute nicht mehr der Fall ist. PRDs, Schätzungsrituale und Produktsicherheitsprüfungen waren dazu da, die Angleichung während der Wochen, Monate oder Quartale der Entwicklungsarbeit zu erzwingen.
Die herkömmliche SDLC enthält auch Kontrollen, die davon ausgehen, dass jeder Schritt von Menschen ausgeführt wird. Die Unternehmen, die den größten Mehrwert erzielen, haben ihre Prozesse auf die neuen Möglichkeiten der agentischen KI ausgerichtet und dabei sichergestellt, dass der Mensch weiterhin in den Prozess eingebunden bleibt. In diesem Leitfaden geben wir einige Erfahrungen hinsichtlich der Best Practices unseres Teams für angewandte KI für die interne Integration von Claude in jeder Phase des SDLC zur Beschleunigung der Entwicklung und der Prozesse weiter, die wir in Zusammenarbeit mit unseren Kunden gemacht haben.
Wenn der Code nicht mehr der Engpass ist und die Erstellungsstufe schneller abläuft als im herkömmlichen SDLC vorgesehen, bewahrheiten sich drei Dinge:
- Der Engpass verlagert sich auf die Schritte links und rechts der Erstellungsphase. Dies betrifft hauptsächlich Planung, Überprüfung/Tests und Bereitstellung, die immer noch mit menschlichem Tempo ablaufen.
- Die Kontrollen entsprechen nicht mehr der Realität und werden unlösbar. Die manuelle Überprüfung jeder einzelnen Zeile war sinnvoll, als diese von Menschen geschrieben wurden, wird aber unhaltbar, wenn Agenten den Großteil der Diffs schreiben.
- Governancekosten steigen, da Ausnahmen immer noch über wöchentliche oder monatliche Meetings und Ausschüsse abgewickelt werden.
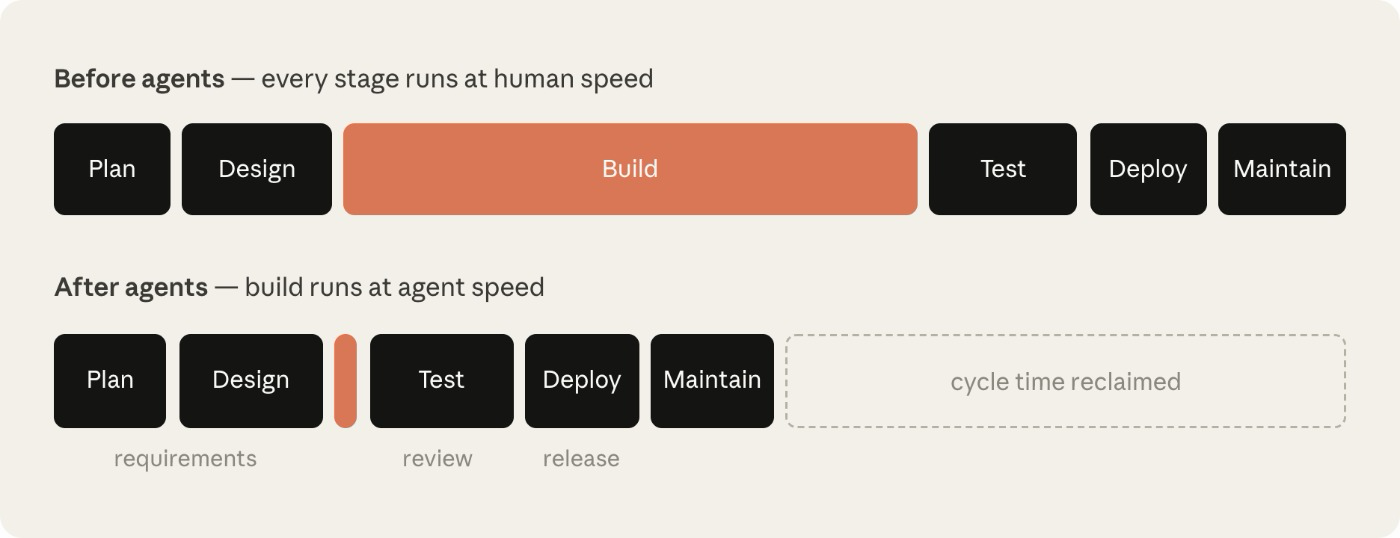
Nehmen wir als Beispiel einen Sicherheitsengpass. Sicherheitsteams sind auf menschlichen Output ausgelegt. Wenn Agenten also die Code-Ausgabe vervielfachen, wächst entweder die Überprüfungswarteschlange oder der Code wird unzureichend geprüft. Eine regulierte Organisation kann keines der beiden Ergebnisse akzeptieren, sodass ihre Sicherheits- und Richtlinienprüfungen mit den Agenten Schritt halten müssen.
Um die Produktivitätsgewinne durch agentische KI besser zu nutzen und zu schützen, erfordert der traditionelle SDLC denselben Grad an Transformation, den die Implementierungsphase durchlaufen hat.
Was ist ein KI-nativer SDLC?
Der KI-native SDLC ist ein neu gestalteter Prozess, der die alten Kontrollziele mit neuen Durchsetzungsmethoden kombiniert. Statt eines linearen Ablaufs wird der Prozess zu einer Schleife, und KI ist an jedem Punkt eingebettet. Der KI-native SDLC fördert die automatisierte Übergabe und die Auslösung nachfolgender Plays, wodurch die manuelle und umständliche Übergabe zwischen den Phasen des herkömmlichen SDLC umgangen wird.
Diese Verschiebung wird oft auch als agentische SDLC, KI-SDLC oder einfach als agentische Softwareentwicklung bezeichnet – unterschiedliche Bezeichnungen für ein und dasselbe Konzept.
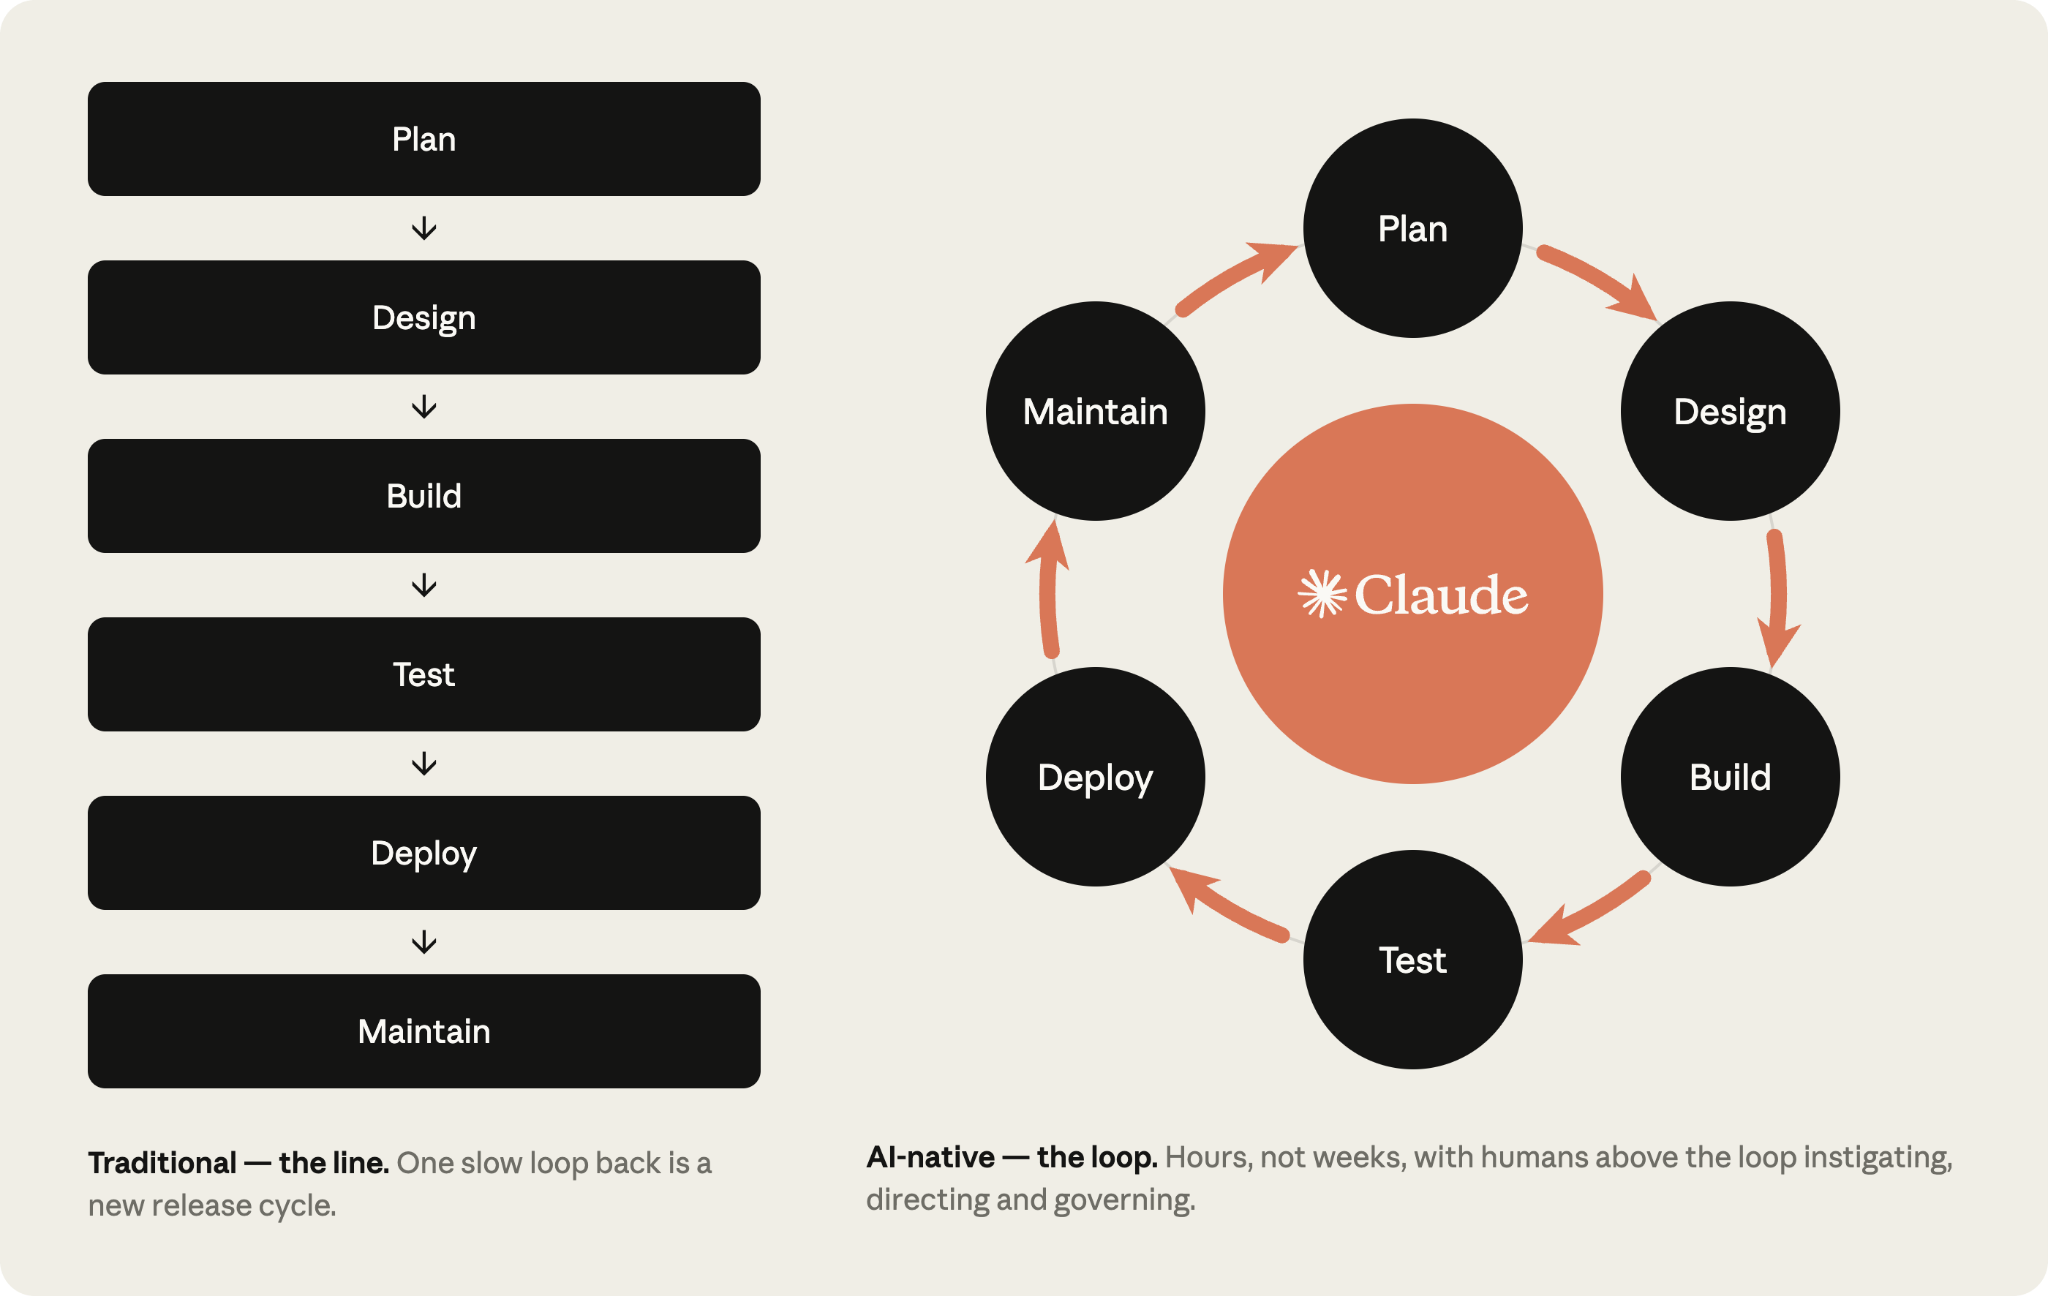
Die Veränderungen in den sechs Phasen eines KI-nativen SDLC
Die folgende Tabelle hebt die Endpunkte des Spektrums zwischen traditionellem SDLC und KI-nativem SDLC hervor, unterstützt von Claude. Die meisten Unternehmen liegen irgendwo dazwischen.
Die Linie, die sich durch die rechte Spalte zieht, ist das eingecheckte Artefakt. Jede Phase endet mit dem Schreiben in die Versionsverwaltung (einschließlich intent.md, spec.md, plan.md, des Diffs und seiner Tests, des PRs mit seinen Überprüfungsergebnissen und des Vorfallsprotokolls), und die nächste beginnt mit dem Einlesen. In den Anfangsphasen sind .md-Dateien das vorherrschende Artefakt, da ein Product Owner und ein Agent dieselbe Datei lesen und bearbeiten können. Ab Build ist das Artefakt der Code und seine Datensätze. Die Kette der Commits ist auch der Audit-Trail: Wer hat was gefragt, was hat der Agent produziert und wer hat es genehmigt.
Menschen sind weiterhin für jede Entscheidung verantwortlich, die Urteilsvermögen erfordert. In der Welt der agentenbasierten SDLC verlagert sich die menschliche Aufmerksamkeit entsprechend den zu prüfenden Artefakten.
Plays
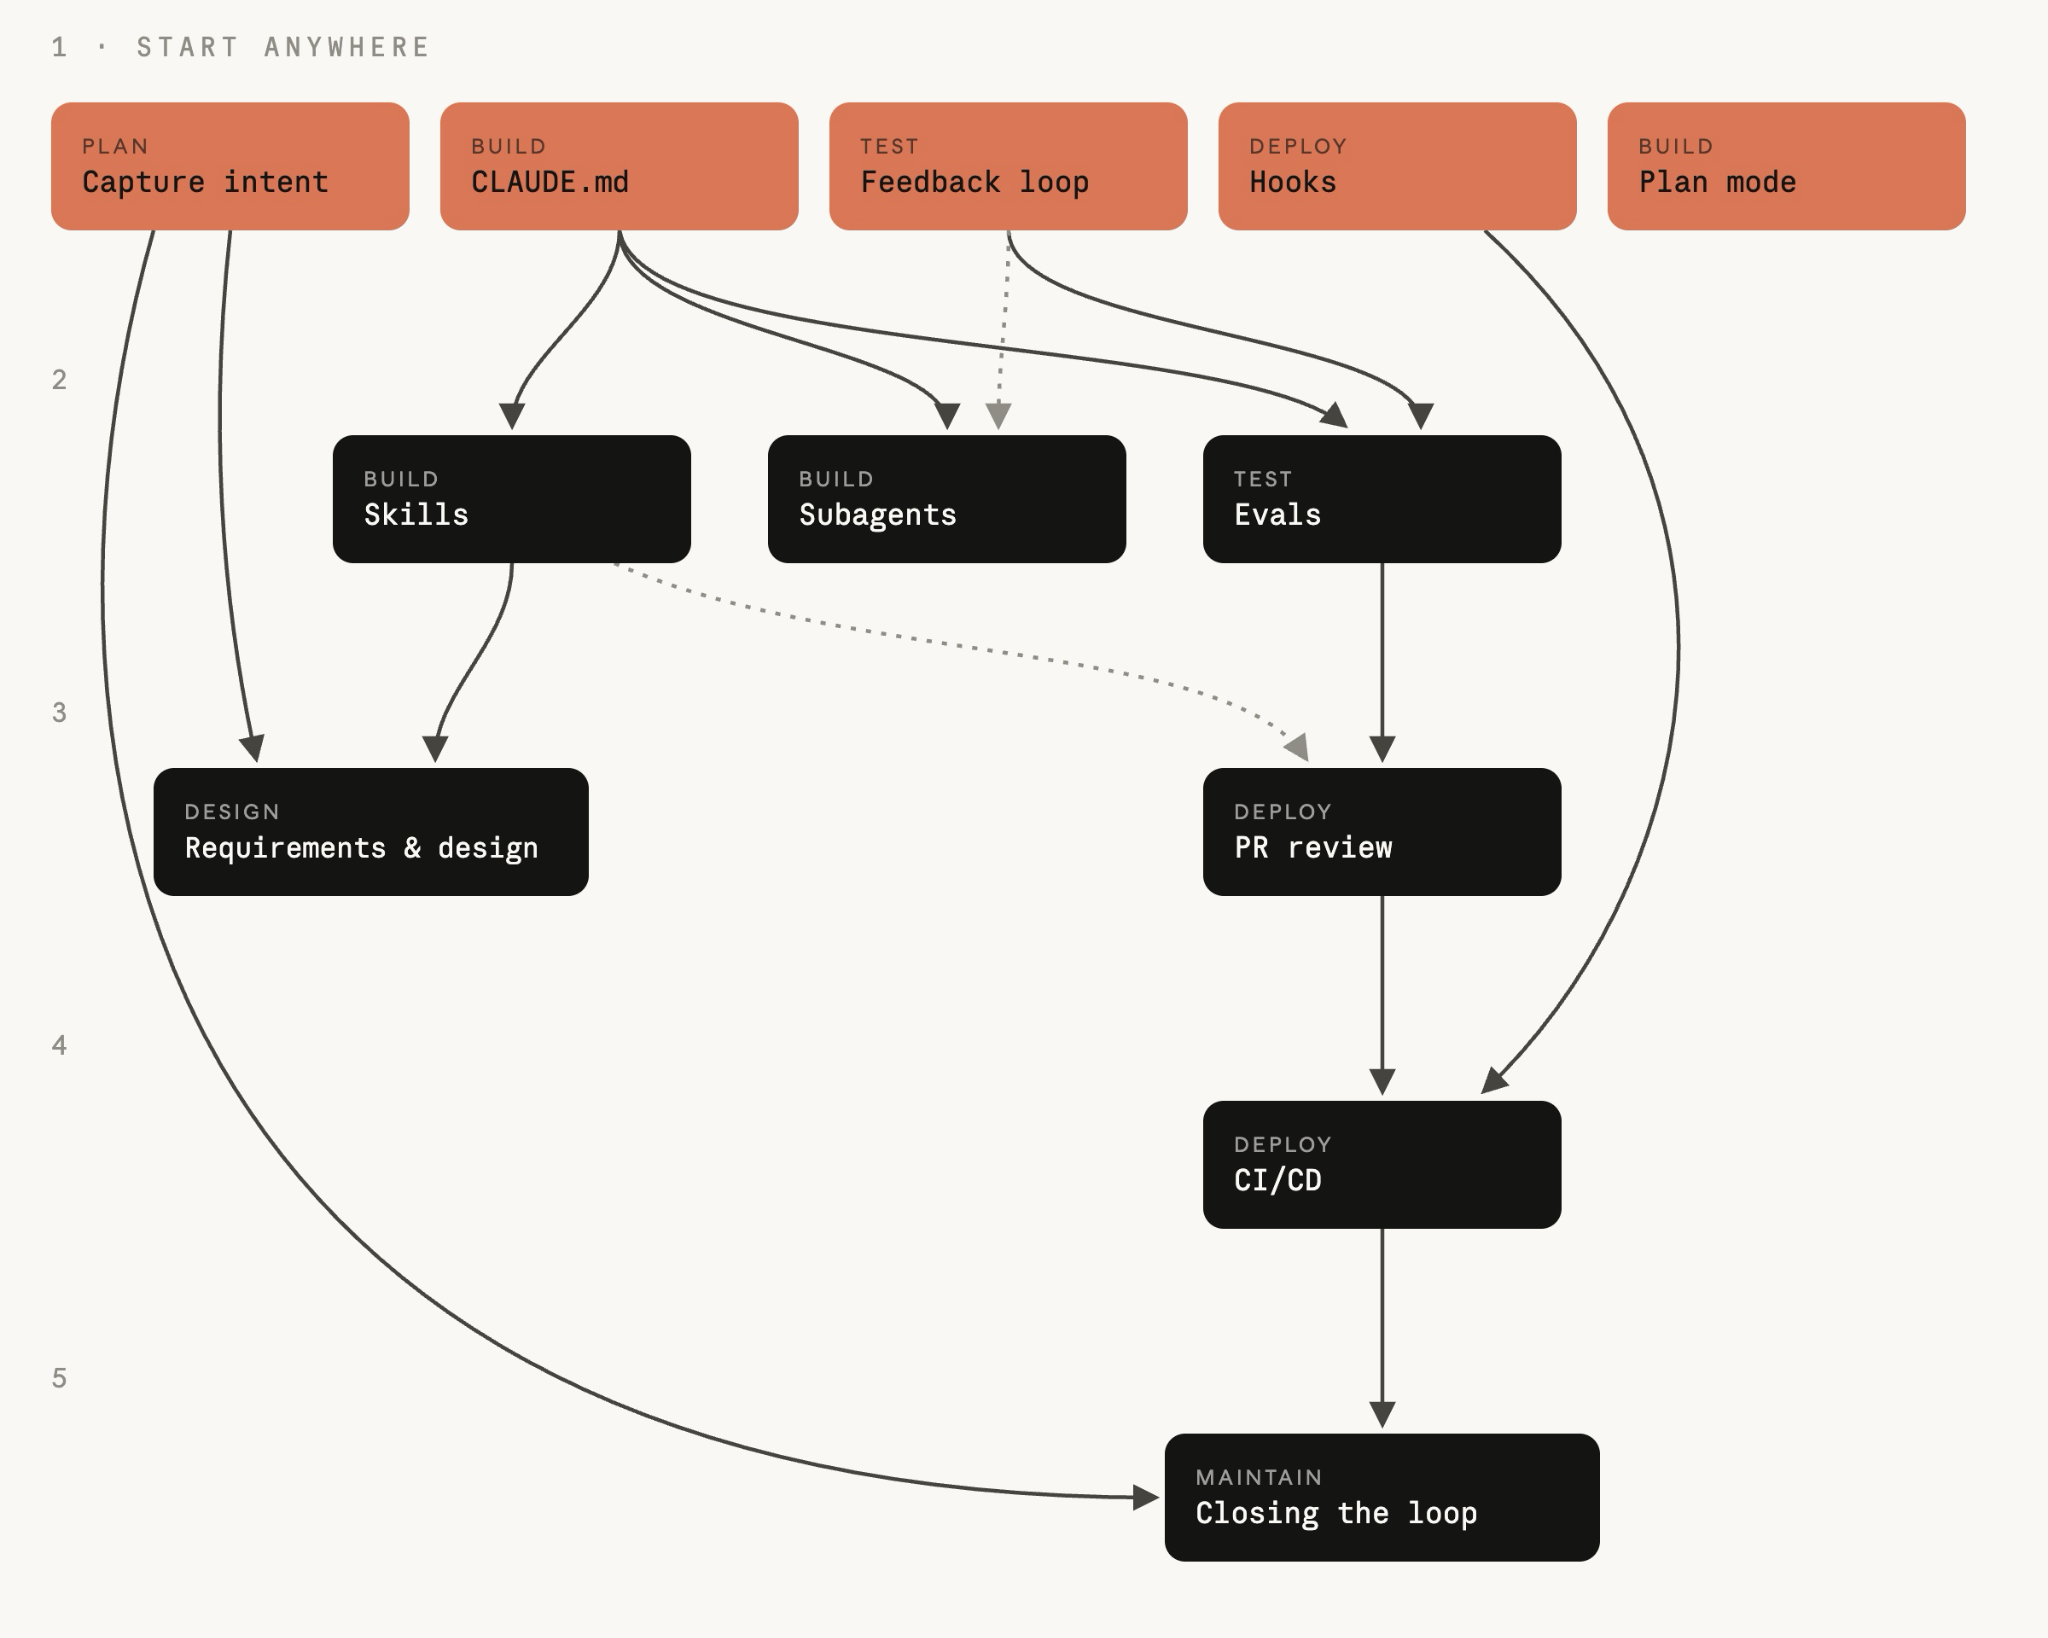
Die Plays sind das Herzstück des Playbooks. Sie sind in sechs nichtlineare Phasen (Planung, Design, Erstellung, Test, Bereitstellung, Wartung) unterteilt, die zusammen den gesamten Lebenszyklus abdecken.
Jedes Play deckt Folgendes ab:
- Was sich ändert;
- Erste Schritte;
- Konkrete Schritte für die Implementierung;
- Überlegungen hinsichtlich Governance; und
- Wie Sie messen können, ob es funktioniert hat.
Die Schritte sind modular aufgebaut und Unternehmen können jederzeit die verschiedenen Phasen ihren individuellen Bedürfnissen entsprechend priorisieren. Für jedes Play werden unter "Voraussetzungen" die Abhängigkeiten genannt, die in der Grafik weiter veranschaulicht werden.
Eine Phase endet mit dem Commit eines Artefakts, wobei der Commit die nächste Phase einleitet. Ein akzeptiertes intent.md löst die Anforderungen sowie den Design-Durchlauf aus, ein genehmigtes spec.md löst den Planmodus aus, eine zusammengeführte PR löst die Pipeline aus und eine Überschreitung der Kontrollbänder in der Produktion schreibt die nächste intent.md, und so setzt sich die Schleife fort.
Zuerst lösen Sie jeden Schritt manuell aus, wobei der Endzustand eine Schleife ist, in der jedes akzeptierte Artefakt das nächste Gate aktiviert. Die menschliche Aufmerksamkeit konzentriert sich auf die Gates und überprüft die vom Agenten markierten Elemente, anstatt jede Phase von Grund auf zu starten.
Als intent.md erfassen
Die intent.md, die den Softwareentwicklungsprozess einleitet, kann über verschiedene Wege erreicht werden. Eine Person hat eine Idee, ein Ticket wird eingereicht oder ein Vorfall wird über eine Warnung gemeldet (siehe Phase 6: Wartung).
Wenn jemand eine Idee hat, führt er ein Brainstorming mit Claude durch und erstellt eine Markdown-Proto-Spezifikation. Im herkömmlichen SDLC muss dieselbe Person dann ein Mitglied des Produktteams überzeugen, die Idee mit ihr oder in ihrem Namen zu entwickeln.
Die von Claude generierte Proto-Spezifikation ist für Menschen lesbar, versionskontrolliert und kann in der nächsten Phase sofort genutzt werden. Die Proto-Spec wird als intent.md gespeichert.
Unabhängig davon, ob sie von einem Vorfall oder einem Agenten ausgelöst wurde, gelten die gleichen Schritte: Der Product Owner überprüft und korrigiert die vom Agenten geschriebene intent.md, bevor sie bestätigt wird.
Die Einrichtung ist eine einmalige Aufgabe der Plattform oder des Engineering-Teams. Ein Mitglied des technischen Teams muss den Intent einrichten und entscheiden, wer schreibberechtigt ist, da unternehmensweit viele Personen daran beteiligt sein werden.
Sobald das Repository eingerichtet ist, können auch Personen ohne Git-Erfahrung mitwirken. Claude kann über einen Konnektor zum Versionskontrollsystem (z. B. GitHub) Markdown-Dateien von claude.ai oder Cowork in ihrem Namen übergeben.
Wie es ausgeführt wird
- Die Person, die den Vorgang initiiert, beschreibt Claude das Problem in eigenen Worten. Die initiierende Person kann beschreiben, was aktuell nicht möglich ist, wer von der Idee betroffen ist, wie eine Verbesserung aussieht oder was außerhalb des Anwendungsbereichs liegt. Es ist keine förmliche Sprache erforderlich.
- Das Brainstorming wird fortgeführt, bis die Idee konkret ist. Claude stellt die Fragen, die ein Analyst stellen würde: Umfang, Benutzer, Einschränkungen und wie der Erfolg aussehen würde.
- Weisen Sie Claude an, das Ergebnis als
intent.mdzu schreiben unter Verwendung der Unternehmensvorlage, die codiert werden kann als Skill, die von einem Mitglied des technischen Teams eingerichtet und von einem Lead bestätigt werden kann. Dies kann das Problem, die vorgeschlagenen Ergebnisse, die betroffenen Benutzer und Systeme, Einschränkungen und offene Fragen umfassen. - Der Originator korrigiert alles, was Claude missverstanden hat.
- Führen Sie einen Commit von
intent.mdin das Shared Home durch. Autor und Zeitstempel werden hinzugefügt, und der Product Owner nimmt die Idee von dort aus auf.
# Intent: claims status self-service
Author: J. Ortiz (claims operations). Status: draft.

## Problem
Customers phone the contact center to ask where their claim is.
Handlers spend roughly a third of call time on status-only queries.

## Proposed outcome
Customers see claim status, next step and expected date in the portal.

## Affected users and systems
Claims handlers, portal team, claims-core API.

## Constraints
No new PII in the portal session. Existing authentication only.

## Open questions
Do third-party loss adjusters need access too?
Überlegungen zur Governance
Der Nachweis ist die committed intent.md, die den Autor, den Zeitstempel und den vollständigen Überarbeitungsverlauf enthält. Dies ist im Git-Verlauf des Intent Home protokolliert. Der Product Owner gibt die Genehmigung, und die Entscheidung über Annahme oder Ablehnung, die die Absicht in Phase 2: Design führt, wird als Zusammenführung oder abschließende Prüfung aufgezeichnet.
Anforderungen und Design
Nach der Genehmigung durch den Product Owner erstellt Claude Anforderungen und Design-Spezifikationen anhand der akzeptierten intent.md. Dies wird von den Skills des Unternehmens in Bezug auf Marke, Sicherheit, Compliance und UX bestimmt.
Der Product Owner überprüft diese Spezifikation, schreibt sie aber nicht aus. Ziel dieses Prozesses ist es, eine Spezifikation zu erstellen, anhand derer das Engineering-Team planen kann, wobei bedenkliche Bereiche gekennzeichnet werden.
Die Front-End-Arbeit ist das deutlichste Beispiel. Sobald die intent.md akzeptiert wurde, macht der Product Owner eine Kopie des Designs in Claude Design (Beta) aus der intent.md, überarbeitet die Kopie und exportiert es dann zur Entwicklung in Claude Code.
Wie es ausgeführt wird
- Der Product Owner eröffnet eine Sitzung mit den verfügbaren Skills des Unternehmens und fügt die
intent.mdbei. - Der Prompt des Product Owners verweist auf die
intent.md, benennt die Einschränkungen und fordert die gekennzeichneten Bedenken. Führen Sie es zunächst manuell aus und implementieren Sie es dann als Slash-Befehl auf Unternehmensebene. Machen Sie von dort aus die Akzeptanz vonintent.mdim Intent-Verzeichnis zum Auslöser, mit einem nicht interaktiven Auftrag, der bei der Zusammenführung startet, führen Sie den Durchlauf mit den geladenen Fähigkeiten der Organisation aus und committen Siespec.mdals Pull-Request (das CI/CD-Play in Phase 5: Deploy deckt das Plumbing ab). Ab diesem Zeitpunkt ist die erste Beteiligung des Product Owners die Überprüfung. - Derselbe Product Owner vergleicht die Spezifikation mit der Idee. Löst die Spezifikation das angegebene Problem, und wurden die offenen Fragen von
intent.mdbeantwortet oder weitergeführt? - Gehen Sie zuerst die gekennzeichneten Bedenken durch, da es sich um Punkte handelt, die ein Analyst eskaliert hätte. Der Product Owner klärt jedes davon mit dem jeweiligen Policy Owner, bevor die technische Entwicklung die Spezifikation sieht.
- Committen Sie
spec.mdzusammen mitintent.md. Das Dateipaar protokolliert, was angefordert und was entschieden wurde. - Der Product Owner entscheidet darüber, ob die Spezifikation und der Intent in den Build gehen unter Absprache mit einem technischen Leiter bei allen Fragen, die das Unternehmen als höheres Risiko einstuft. Diese Entscheidung wird immer von einem menschlichen Teammitglied getroffen. Die Annahme der Spezifikation führt dazu, dass der Planmodus in Phase 3: Entwickeln gestartet wird.
Wie es aussieht (die Eingabe)
Read the attached intent.md and produce a requirements and design spec for integrating it into our existing codebase. Apply the skills available to you so the plan conforms to our brand guidelines, security policies and UX standards. Document the spec fully as spec.md, ready to hand to the engineering team. Describe clearly any areas of concern, especially where you cannot satisfy contradicting policies.Überlegungen zur Governance
Statt der Entdeckung Wochen später in einer Überprüfung wird die live Richtlinie noch bei Erstellung der Spezifikation gelesen und angewendet. Die Skills des Unternehmens werden als Einschränkungen auf die Spezifikation angewendet. Die Spezifikation, der Prompt, der sie erstellt hat, und die gültigen Skill-Versionen werden in der Versionskontrolle protokolliert. Der Product Owner genehmigt die Spezifikation und leitet die gemeldeten Bedenken an die genannten Policy-Owner weiter.
Plan-Modus für Claude Code als Standardausgangspunkt
Entwickler starten Claude Code-Sitzungen im Planmodus, geben Claude die genehmigte spec.md aus Phase 2: Design und lassen sich von Claude interviewen, wobei sie den Plan so lange überarbeiten, bis der Entwickler damit zufrieden ist.
Wie es ausgeführt wird
- Der Entwickler beginnt die Sitzung im Planmodus mit Claude.
- Der Entwickler gibt Claude die
intent.mdund diespec.mdund bittet um einen Implementierungsplan, der die zu ändernden Dateien, die Reihenfolge der Arbeiten und die Tests enthält, die dies belegen. - Überprüfen Sie den Plan, indem Sie fragen, was die Änderung beeinträchtigen könnte, welcher Schritt am riskantesten ist und welche anderen Optionen Claude bewusst nicht gewählt hat.
- Iterieren Sie, bis ein Entwickler, der die Konversation noch nie gesehen hat, die Änderung aus dem Plan alleine umsetzen kann.
- Committen Sie den genehmigten Plan als
plan.md. Der Plan wird in den Audit-Trail aufgenommen, und die PR-Überprüfung (Phase 5: Bereitstellung) vrgleicht eventuelle Diff mit dem Plan. - Nehmen Sie den Plan an und überlassen Sie Claude die Umsetzung. Mit einem soliden Plan ist die Implementierung oft ein einziger Schritt.
- Wenn die Implementierung vom Plan abweicht, aktualisieren Sie
plan.mdim selben Commit. Sie können einen Hook verwenden, um die Synchronisation zwischen den beiden zu erzwingen.
Wie es aussieht (plan.md)
# Plan: claims status self-service (from intent.md 2026-06-02)

## Files that change
portal/src/claims/StatusPanel.tsx (new), claims-api/routes/status.py,
claims-api/tests/test_status.py

## Order of work
1. Add the status endpoint behind existing auth.
2. Panel against the endpoint.
3. Wire into the portal nav.

## Risks
The claims-core API rate-limits at 50 rps; the panel must cache.

## Proof
test_status.py covers the four claim states; screenshot matches the
approved mock.
Überlegungen zur Governance
Die Designprüfung findet vor der Codegenerierung statt, wenn eine Kursänderung lediglich eine Änderung an einem Dokument erfordert. Der Planmodus selbst erzwingt dies, da Claude Dateien erst bearbeiten kann, wenn der Entwickler den Plan annimmt. Der Plan und seine Revisionen werden unter Angabe der Personen, die ihn angenommen haben, protokolliert. Routineänderungen werden vom Entwickler genehmigt, und alles, was vom Unternehmen als höheres Risiko eingestuft wird, wird an einen Tech-Lead oder Architekten weitergeleitet.
Claude Code im automatischen Modus
Claude Code kann auch im automatischen Modus ausgeführt werden, wobei der Entwickler den Plan genehmigt und Claude nach erfolgreicher Iteration jede Änderung übernimmt, ohne dass eine Bearbeitungsaufforderung erforderlich wird. Wenn die Voraussetzungen für die späteren Tests ausgereift sind (ein abgestimmtes CLAUDE.md, Skills, die Richtlinien kodieren, Hooks, die unsichere Aktionen blockieren, und eine Testsuite, die Claude ausführen kann), wird die automatische Annahme zum Standard für Routineaufgaben: enge spec.md, kleiner Blast-Radius und Code, der bereits durch Tests abgedeckt wird.
Die Überprüfung durch den Benutzer findet nun nicht mehr nach Beobachtung der einzelnen Handlungen des Agenten statt, sondern es werden die Artefakte erst nach längeren, autonomen Sitzungen untesucht. Der Auto-Accept-Modus ermöglicht bei der Verwendung mit Worktrees zudem Parallelität zwischen Einzelpersonen und dem Team und ist grundlegend für die autonome Ausführung des SDLC sowie das Schließen der Schleife, wie in Phase 6: Wartung beschrieben.
Die CLAUDE.md
CLAUDE.md gibt Claude den Kontext, den ein neuer Joiner benötigt, einschließlich Konventionen, Befehlen, Architektur und der Fehler, die das Team am häufigsten sieht. Wissen, das früher in den Köpfen der Menschen und in Wikis zu finden war, ist nun eine Datei, die vom gesamten Team gepflegt und bei jedem Fehler weiterbearbeitet wird. Sie wird vom Agenten zu Beginn jeder Sitzung gelesen.
Wie es ausgeführt wird
- Führen Sie
/initim Repo aus. Claude generiert aus seinen Erkenntnissen eineCLAUDE.mdals Startpunkt. - Reduzieren Sie die generierte Datei auf das, was ein neuer Joiner am ersten Tag benötigt. Behalten Sie die Befehle build, test und lint, die wichtigen Konventionen und die Dinge, die Claude immer wieder falsch macht, bei.
- Checken Sie
CLAUDE.mdim Root-Verzeichnis des Repositorys in git ein, damit das gesamte Team dieselbe Version verwendet und Änderungen wie Code überprüft werden. - Eine Faustregel hilft hierbei. Wenn Claude zweimal denselben Fehler macht, wird die Korrektur in
CLAUDE.mdeingegeben. - Gehen Sie nicht über eine Seite hinaus, denn Claude liest alles zu Beginn einer Sitzung und veraltete Informationen beanspruchen unnötig Kontext ohne wirklichen Nutzen.
Wie es aussieht (CLAUDE.md)
# Payments service

## Commands
- Build: make build
- Test: make test (unit), make itest (integration, needs docker)
- Lint: make lint (runs in CI; fix before pushing)

## Conventions
- Java 21, Spring Boot 3. No new Lombok.
- Money is always BigDecimal, never double.
- Every endpoint needs an integration test in src/itest.

## Architecture
- api/ holds REST controllers, core/ holds domain logic,
  adapters/ talks to external systems.
- Kafka events are defined in schemas/; never edit generated classes.

## Things Claude gets wrong
- Do not bump dependency versions; the platform team owns them.
- The legacy v1/ package is frozen; changes go in v2/.
Überlegungen zur Governance
CLAUDE.md ist versionskontrolliert, sodass die Anweisungen, nach denen der Agent arbeitet, überprüft und auditiert werden können. Teamkonventionen werden in der gesamten Datei angewendet, Änderungen daran werden im Git-Verlauf protokolliert und Code Owners genehmigen diese Änderungen bei der PR-Überprüfung.
Skills als institutionelles Wissen
Skills sind das Mittel, mit dem ein Unternehmen sein institutionelles Wissen in die Praxis umsetzt. Die Anweisungen sind explizit, versionskontrolliert, finden vielseitige Anwendung und werden zentral aktualisiert, wenn sich die Richtlinien ändern. Die Faustregel: Schreiben Sie einen Skill für institutionelles Wissen, das konsequent angewendet werden muss; schreiben Sie keinen Skill für Komponenten, die in CLAUDE.md oder einen Prompt gehören.
Wie es ausgeführt wird
- Wählen Sie ein Wissensmaterial, das derzeit uneinheitlich angewendet wird. Dies kann ein Sicherheitsstandard, eine API-Designkonvention oder eine Markenregel sein.
- Schreiben Sie es als Skill, einen Ordner mit einer
SKILL.md, deren Frontmatter angibt, wann sie ausgelöst wird, und deren Inhalt beschreibt, was zu tun ist. Ein Entwickler erstellt ihn mithilfe von Claude anhand der Single Source of Truth des Richtlinienverantwortlichen. - Legen Sie den Skill im Repo unter
.claude/skills/<name>/ab, damit er mit dem Code ausgeliefert wird, oder verteilen Sie ihn unternehmensweit über ein Plugin. - Testen Sie, ob der Skill ausgelöst wird. Bitten Sie Claude, die jeweilige Aufgabe auf verschiedene Arten zu erledigen und jedes Mal die Skill-Belastung zu bestätigen.
- Wenn sich die Richtlinie ändert, ändern Sie den Skill und lassen Sie den Richtlinieninhaber die Änderung bestätigen.
- Das Entwickler-Team greift auf die neue Version automatisch in ihrer nächsten Sitzung zu.
Wie es aussieht (.claude/skills/secure-api-review/SKILL.md)
---
name: secure-api-review
description: Apply the API security standard. Use whenever creating or
  modifying an external-facing endpoint, reviewing API code, or
  generating an OpenAPI spec.
---
# Secure API review

When you create or change an API endpoint:
1. Authentication: every endpoint requires the gateway JWT;
   no anonymous routes outside /health.
2. Input validation: validate request bodies against the OpenAPI
   schema and reject unknown fields.
3. Audit: every state-changing endpoint emits an audit event with
   actor, action, entity and timestamp.
4. Data classification: fields tagged pii in the schema must never
   appear in logs or error messages.

Run scripts/check-endpoints.sh and include its output in your summary.
Überlegungen zur Governance
Ein Skill ist eine eher beratende Kontrollfunktion. Es ist wahrscheinlich, dass Claude die Richtlinie anwendet, während der Code geschrieben wird, und nichts zwingt eine Sitzung dazu, sie einzuhalten. Eine Richtlinie, die immer gültig sein muss, benötigt etwas Deterministisches hinter dem Skill, wie z. B. einen Hook, der die Aktion blockiert, oder einen Prüfdurchlauf, der die Richtlinie im PR erneut überprüft. Der Skill macht Verstöße selten und der Hook macht sie nahezu unmöglich. Skill-Aufrufe werden in Sitzungsverfolgungen protokolliert, und der Policy Owner überprüft Änderungen an Skills wie Code.
Hooks als Vorgaben während des Builds
Ein Skill ist eine beratende Steuerung, während ein Hook die deterministische Ebene dahinter ist. Die meisten Aktionen von Claude sind Dateibearbeitungen und Shell-Befehle während der Implementierung, daher ist die Build-Phase der Zeitpunkt, an dem Hooks am häufigsten ausgelöst werden.
Hooks der Build-Phase können:
- Änderungen an geschützten Pfaden wie generierten Klassen oder eingefrorenen Paketen blockieren;
- Führen Sie Formatter und Linter nach Dateiänderungen aus, damit sich keine Abweichungen ansammeln;
- Nehmen Sie keine Anmeldeinformationen in das Diff auf.
Unterstützen Sie alle Skills, deren Richtlinien ausnahmslos gelten müssen. Ein Hook wird bei jeder Aktion ausgeführt, die auf ihn zutrifft; daher sollten Hooks in der Build-Phase schnell sein und sich auf die Datei beschränken, die geändert wurde. Umfangreichere Prüfungen, wie die vollständige Testsuite, gehören zum Commit oder zum PR.
Ein Hook, der eine menschliche Genehmigung erfordert, gehört zu den Gates in Phase 5: Bereitstellung, da eine Genehmigungsaufforderung während des Builds die Person wieder in den kritischen Pfad aller parallel laufenden Sitzungen einbindet.
Parallele Sitzungen und Subagenten
Ein Entwickler kann mehrere Arbeitsbereiche gleichzeitig bearbeiten.
Eine parallele Sitzung ist eine weitere vollständige Claude Code-Instanz, die eine separate Aufgabe in einem eigenen Git-Worktree bearbeitet. Keine der unabhängigen Sitzungen haben Einsicht in die anderen, und das Einzige, was sie gemeinsam haben, ist der Entwickler, der sie leitet.
Ein Subagent wird innerhalb einer einzelnen Sitzung als umfasster Helfer mit eigenen Kontextfenstern und Tool-Einschränkungen ausgeführt und eignet sich für Aufgaben, die in mehreren Aufgaben auftreten, wie z. B. die Überprüfung, ob die App wie erwartet ausgeführt wird.
Parallele Sitzungen erhöhen die Anzahl der Aufgaben, die ein Entwickler gleichzeitig bearbeiten kann, während Subagenten jede Sitzung auf ihre eigene Aufgabe konzentrieren. Die Aufgabe des Entwicklers besteht darin, alle Vorschläge zu steuern und zu überprüfen.
Wie es ausgeführt wird
- Der Entwickler teilt die Arbeit in Aufgaben auf, die verschiedene Dateien betreffen, und verwendet den Plan aus dem Planmodus-Play (Phase 3: Erstellen), um zu sehen, wo die Arbeiten unabhängig voneinander sind. Aufgaben, die Dateien gemeinsam nutzen, werden in einer einzigen Sitzung ausgeführt, und zwar nacheinander.
- Jede parallele Aufgabe erhält ihren eigenen Worktree, beispielsweise
claude --worktree feature-authin einem Terminal undclaude --worktree fix-rate-limitin einem anderen. Ein Worktree ist ein separater Checkout in einem eigenen Branch, der verhindert, dass Sitzungen bei Dateien kollidieren. - Zwei oder drei Sitzungen sind ein sinnvoller Ausgangspunkt. Die praktische Obergrenze ist die Anzahl der Streams, die eine Person korrekt überprüfen kann. Fügen Sie also nur Sitzungen hinzu, solange die Überprüfung auf dem gleichen Stand ist.
- Wandeln Sie wiederkehrende Aufgaben in Subagenten um, wie in den Markdown-Dateien unter
.claude/agents/definiert, jeweils mit einem Namen, einer Beschreibung der Einsatzszenarien und den Tools, auf die sie zugreifen können. Beispiele hierfür sind ein Code-Vereinfacher, der nach der Fertigstellung des Hauptagenten unnötige Komplexität entfernt, ein Prüfer, der die App ausführt und das Verhalten überprüft, ein Forscher, der die Codebasis untersucht und darüber berichtet, ohne den Hauptkontext zu überschwemmen. Checken Sie die Definitionen in Git ein, damit sie dem gesamten Team zur Verfügung stehen.
Wie es aussieht (.claude/agents/verifier.md)
---
name: verifier
description: Runs the app and checks the change works before the session
  reports done
tools: Bash, Read
---
Start the app with make run. Exercise the changed behavior and the two
nearest neighboring flows. Report what you ran, what you saw, and any
behavior that does not match plan.md. Do not fix anything; report only.
Überlegungen zur Governance
Mehr Sitzungen bedeuten mehr Output, daher müssen die Kontrollen aus der Konfiguration im Repo stammen. Hooks und Berechtigungseinstellungen dort gelten für alle Sitzungen, und die Ereignisse einer Sitzung werden protokolliert und dem Entwickler zugeordnet, der sie ausgeführt hat.
Geben Sie Claude eine Feedbackschleife
Geben Sie Claude immer die Möglichkeit, seine eigene Arbeit zu überprüfen, sei es ein Test, ein Build oder ein Screenshot. Eine Sitzung überprüft die eigene Arbeit und behebt eigene Fehler, bevor sie von einem Entwickler zur Kenntnis genommen werden.
Die Feedback-Schleife sollte nicht mit einem Verifizier-Subagent verwechselt werden (Phase 3: Erstellung). Die Feedback-Schleife durchläuft die gesamte Aufgabe so oft wie die Arbeit. Der Verifier-Subagent hingegen ist eine Möglichkeit, die abschließende Prüfung zu verpacken, indem ein neues Kontextfenster ausgeführt wird, sobald die Sitzung davon ausgeht, dass die Arbeit erledigt ist. Auf diese Weise wird das Urteil nicht von den Annahmen beeinflusst, die dem Code zugrunde liegen.
Wie es ausgeführt wird
- Wenn die Überprüfung der Arbeit heute eine Abfolge von Befehlen und einige Umgebungskenntnisse erfordert, fassen Sie diese in einem einzigen Ziel wie "make test" oder "npm test" zusammen, das bei einem Fehler mit einem Exit-Code ungleich Null beendet wird.
- Listen Sie im Abschnitt „Commands“ der
CLAUDE.mdjeden Befehl mit einem Beispiel für eine korrekte Ausgabe auf. - Geben Sie ein Ziel an und machen Sie es quantifizierbar, damit Claude die Arbeit überprüfen kann, ohne Sie zu fragen, z. B.: „Alle Tests in test_status.py sind erfolgreich“, „der Screenshot stimmt mit dem angehängten Mock überein“ oder „der Endpunkt liefert 200 mit dem neuen Feld“.
- Schreiben Sie bei Fehlerbehebungen zuerst den fehlgeschlagenen Test. Bitten Sie Claude, den Fehler als Test zu reproduzieren, auszuführen und zu bestätigen, dass er aus den von Ihnen gewünschten Gründen fehlschlägt. Committen Sie den Test. Bitten Sie Claude erst dann, dafür zu sorgen, dass er besteht, ohne den Test zu bearbeiten, wobei der Hook für die Testdatei aus dem letzten Schritt die Einschränkung durchsetzt. Ein Test, der vor der Korrektur existierte und den der Agent nicht überarbeiten konnte, ist der Beweis dafür, dass der Fehler behoben wurde.
- Schließen Sie den Prozess bei der UI-Arbeit mit einer visuellen Prüfung ab. Geben Sie Claude einen Browser oder ein Screenshot-Tool, geben Sie ihm den Entwurf und lassen Sie ihn iterieren. Implementieren, Screenshot erstellen, vergleichen und anpassen. Zwei oder drei Runden sind normal, und das Ergebnis sollte mit jeder Runde besser werden.
- Integrieren Sie die Überprüfung in "done". Die Anweisungen werden in
CLAUDE.mdgespeichert. Führen Sie die Tests durch, bevor Sie eine Aufgabe als abgeschlossen melden, und zeigen Sie die Ausgabe an. - Schließlich muss die Schleife selbst geschützt werden, da ein Agent, der den Code korrigiert, die Überprüfung dieses Codes nicht beeinträchtigen darf. Das geschieht durch einen Hook, der Änderungen blockiert, um Dateien während einer Korrekturaufgabe zu testen. Die Alternative besteht darin, den Diff bei der Überprüfung zu checken und alle Änderungen abzulehnen, die einen Test betreffen.
Wie es aussieht (CLAUDE.md-Verifizierungsblock)
## Verifying your work

- Build: make build (must finish with "Build succeeded")
- Test: make test (all green; never skip or delete a failing test)
- Lint: make lint (zero warnings)

Run all three before reporting any task complete, and paste the output.
If a test fails, fix the code, not the test.Kontinuierliche Evaluierungen im CI
Evals sind das KI-native Äquivalent zur Qualitätssicherung nach dem Stage-Gate-Modell. In der Praxis bedeutet dies eine Suite, die ausgeführt wird, wenn sich die Konfiguration des Agenten ändert. Wenn ein neues Modell eingeführt oder ein Prompt neu geschrieben wird, gibt die Bewertungssuite an, ob der Agent die Arbeit immer noch nach demselben Standard erledigt.
Die Evals sollten als Live-Suite betrachtet werden. Mit der Verbesserung der Modelle verlieren Fälle, die früher zur Unterscheidung herangezogen wurden, ihre Relevanz, und es müssen neue hinzugefügt werden, die sich aus der laufenden Überwachung ergeben.
Je nach Anwendungsfall ziehen es einige Teams vor, diese Bewertungen offline zu einem festgelegten Zeitpunkt durchzuführen, anstatt bei jeder einzelnen Änderung. Die folgenden Schritte dienen der kontinuierlichen Bewertung.
Wie es ausgeführt wird
- Der Plattform-Entwickler stellt 20 bis 50 echte Aufgaben aus kürzlich durchgeführten Arbeiten mit den jeweils erwarteten/akzeptierten Ergebnissen zusammen.
- Schreiben Sie jede Aufgabe als Eval, d. h. die Eingabeaufforderung sowie die Prüfungen, die die Akzeptanz definieren (Tests bestanden, Linting erfolgreich, Verhalten unverändert, Richtlinie eingehalten).
- Die Suite wird nicht-interaktiv in der CI nach einem Zeitplan und bei jeder Änderung von
CLAUDE.md, Skills oder Hooks ausgeführt, da diese Konfiguration den Agenten steuert und die Regressionstests verdient, die auch Code erhält. - Änderungen der Gate-Konfiguration wirken sich auf die Ergebnisse aus. Eine Änderung einer Fähigkeit, die die Bestehungsrate senkt, wird geprüft, bevor sie zusammengeführt wird.
- Für jeden Produktionsvorfall wird eine Auswertung durch das zuständige Team erstellt, die anschließend als Regressionstest in der Suite verbleibt.
Wie es aussieht (.github/workflows/agent-evals.yml)
name: Agent evals
on:
  pull_request:
    paths: ['CLAUDE.md', '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: Run eval suite
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
Überlegungen zur Governance
Durch Evals erhält die QS ein Gate, das mit der Agentenleistung mithalten kann. Der Schwellwert für die Bestehensrate wird als Zusammenführungsprüfung durchgesetzt und die Ausführungen werden protokolliert, damit die Ergebnisse im Laufe der Zeit verglichen werden können, wobei das Team, das die Konfigurationsänderung vornimmt, sie genehmigt.
KI in der PR-Review-Schleife
Claude gibt und erhält Bewertungen. Claude prüft eingehende PRs anhand der Richtlinien des Unternehmens und geht auf die Kommentare zu den eigenen PRs ein. Dadurch können sich Entwickler bei ihrem PR-Review auf das Verhalten konzentrieren, was auf die Beurteilung von Absicht und Risiko hinausläuft.
Wie es ausgeführt wird
- Der verwaltete Code-Review-Service ist der schnellste Einstieg. Ein Admin aktiviert es und wählt Repositories aus. Führen Sie die Überprüfung in Ihrer eigenen CI mit der claude-code-action durch, wenn Sie die Kontrolle über die Pipeline benötigen oder API-Aufrufe über Ihre eigene Cloud-Vereinbarung weiterleiten möchten (der CI/CD-Play deckt das Plumbing ab).
- Der Tech-Lead schreibt die Review-Richtlinie als
REVIEW.mdim Root-Verzeichnis des Repositorys, unterteilt in die Prüfschritte, die für das Unternehmen wichtig sind: Bugs und logische Fehler; Sicherheit und Schwachstellen; Compliance mit der Spezifikation (spec.mdaus dem Anforderungs-Play); den Implementierungsplan (plan.mdaus dem Planmodus-Play) sowie Designprinzipien.REVIEW.mddefiniert auch, was als Wichtig im Gegensatz zu einem Nit gilt und was übersprungen werden soll. - Der technische Leiter legt den Schwellenwert für menschliches Eingreifen fest. Die Ergebnisse allein stellen keine Grundlage für die Genehmigung oder Blockierung einer PR dar, und der Branch-Schutz erfordert weiterhin die Genehmigung durch einen Code-Eigentümer. Ein Plattform-Entwickler, der Merges auf der Grundlage von Ergebnissen blockieren möchte, kann die Schweregrad-Zahlen lesen, die der Prüflauf als maschinenlesbare Zusammenstellung veröffentlicht.
- Wenn ein Prüfer oder der Autor
@claudein einem Bewertungskommentar markiert, geht Claude auf den Kommentar ein und führt die Korrektur durch. Der PR-Thread zeichnet sowohl die Anfrage als auch die Änderung auf. Diese Korrekturschleife durchläuft die claude-code-action. Im verwalteten Service hingegen wird durch das Kommentieren von@claude revieweine neue Überprüfung angefordert. Für von Claude eröffnete PRs können Sie noch einen Schritt weiter gehen und Claude die PR bis zur Zusammenführung betreuen lassen. Teams kapseln die Schleife in einem benutzerdefinierten Slash-Befehl, der die ungelösten Review-Kommentare und fehlgeschlagenen Prüfungen der PR durchsucht, diese behebt und die Korrekturen pusht, bis die PR grün ist und nur noch auf die Genehmigung des Code-Owners wartet. - Die Ergebnisse der Überprüfung werden in
CLAUDE.mdeingespeist. Wenn bei einer Review ein Fehler zum zweiten Mal markiert wird, wird die Korrektur als Teil dieser Überprüfung inCLAUDE.mdaufgenommen, und da bei der ReviewCLAUDE.mdgelesen wird, wird der Fehler ab der nächsten PR erkannt. Die Review zeigt auch an, wennCLAUDE.mddurch eine Änderung veraltet ist. - Einmal im Monat passt der Tech-Lead das Setup an, indem er die Ergebnisse bewertet, damit sich der Prüfer verbessert, und indem er das Nit-Volumen in
REVIEW.mdbegrenzt. Generierte Pfade und alles, was CI bereits erzwingt, werden ausgeschlossen.
Wie es aussieht (REVIEW.md)
# Review instructions

## Passes
Run three passes and tag each finding with its pass:
- Bugs: logic errors, broken edge cases, subtle regressions
- Security: injection risks, authentication gaps, PII in logs
- Compliance: the change matches spec.md, plan.md and our design principles

## What Important means here
Reserve Important for findings that would break behavior, leak data
or breach a policy. Style and naming are nits.

## Cap the nits
Report at most five nits per review; summarize the rest as a count.

## Do not report
Generated files under src/gen/ and anything CI already enforces.
Überlegungen zur Governance
Die Aufgabentrennung bleibt erhalten, da der Agent, der den Code geschrieben hat, keine Möglichkeit hat, ihn zu genehmigen. Die Review-Richtlinie in REVIEW.md wird auf alle PRs angewendet, und die Ergebnisse, Korrekturen, Bewertungen und Genehmigungen werden im PR-Verlauf protokolliert, sodass die PR das Audit-Log ist. Die Genehmigung erfolgt durch einen Menschen mittels Branch-Schutz, basierend auf den Ergebnissen.
Weitere Informationen dazu, wie diese Kontrollen im Produktionsmaßstab zusammengesetzt sind, finden Sie unter Sicherung einer KI-nativen SDLC bei Anthropic.
Hooks als Freigabegates
Die Build-Phase verwendete Hooks als Schutzmechanismen, die Handlungen ohne menschliches Eingreifen erlaubten oder blockierten (Stage 3: Build). Ein Hook kann auch nachfragen und die Aktion pausieren, bis eine bestimmte Person die Genehmigung erteilt – genau das, was für das Release Gating benötigt wird.
Das Play befindet sich in Stage 5: Deploy, da das Release-Gate der eindeutigste Fall ist, aber die Hooks sind nicht bereitstellungsspezifisch: Sie werden ausgeführt, wo immer Claude tätig ist. Hooks können beispielsweise Änderungen an Migrationen und Infrastruktur ohne Änderungsticket während der Phase 3: Build blockieren und den Agenten daran hindern, Testdateien während der Korrekturaufgabe in Phase 4: Test zu bearbeiten.
Wie es ausgeführt wird
- Die Engineering-Führung listet unter Einbeziehung von Änderungsmanagement und Compliance die menschlichen Genehmigungsinstanzen auf, die beibehalten werden müssen, wie etwa die Genehmigung durch das Änderungsmanagement, die Freigabeautorisierung und die Genehmigung von Änderungen an geschützten Pfaden.
- Der Platform Engineer drückt jedes Gate als Hook aus, ein Skript, das ausgeführt wird, bevor Claude handelt, und das Aktionen zulassen, nachfragen oder blockieren kann.
- Team Hooks werden in
.claude/settings.jsonin Git gespeichert, und nicht verhandelbare Hooks werden in verwalteten Einstellungen der Plattform oder des IT-Administrators aufgeführt, wo einzelne Entwickler sie nicht deaktivieren können. - Ein Block sollte sich selbst erklären. Wenn also ein Hook eine Aktion stoppt, werden der Grund und der Weg zur Genehmigung in der Claude-Ausgabe angezeigt.
Wie es aussieht (.claude/settings.json)
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "Bash",
          "hooks": [
            { "type": "command",
              "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
          ]
        }
      ]
    }
}
Und das Gate selbst (.claude/hooks/production-gate.sh)
#!/bin/bash
# Production deploys require a named release authorization
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
   if [ -z "$RELEASE_APPROVAL" ]; then
     echo "Production deploys need a release authorization." >&2
     exit 2 # exit 2 blocks the action; the message goes to Claude
   fi
fi
exit 0
Überlegungen zur Governance
Hooks sind die Freigabetore. Die Gate-Bedingung wird jedes Mal für alle durchgesetzt. Entscheidungen zum Zulassen und Blockieren werden mit einem Zeitstempel protokolliert. Das Gate definiert auch, was als Genehmigung gilt, unabhängig davon, ob es sich um ein genehmigtes Änderungsticket oder die Genehmigung durch den Release-Manager handelt.
CI/CD-Integration und Bereitstellung
Führen Sie Claude Code nicht-interaktiv innerhalb der CI/CD-Pipeline aus, isolieren Sie die Ausführung in einer Sandbox, damit lang laufende Agenten sicher laufen, machen Sie die Bereitstellung über MCP-Integrationen zugänglich und proben Sie die Rollback-Pfade, bevor der Agent sie jemals benötigt.
Wie es ausgeführt wird
- Der Plattform-Engineer beginnt mit Read-Only Bewertungsschritten. Verwenden Sie
claude -pin einem Pipeline-Job, um einen fehlgeschlagenen Build zu prüfen, einen unzuverlässigen Test zusammenzufassen oder das Changelog zu entwerfen. - Fügen Sie Schreibschritte hinter den bestehenden Gates für Aufgaben wie das Beheben von Lint-Fehlern, das Aktualisieren generierter Dokumente oder das Bearbeiten von Code-Review-Kommentaren über die
@claude-Erwähnungen hinzu. Alles, was der Agent schreibt, kommt durch den Branch-Schutz als PR an, und der Agent hat keine Möglichkeit, direkt in den Main-Branch zu pushen. - Die Ausführung erfolgt in einer Sandbox. Agenten-Jobs werden in Containern unter einer Netzwerkrichtlinie mit kurzlebigen, bereichsbezogenen Tokens ausgeführt und enthalten standardmäßig keine Produktionszugangsdaten.
- Stellen Sie die Bereitstellung über MCP bereit. Bereitstellung, Status und Rollback werden zu Tools, die auf die jeweilige Umgebung begrenzt sind, sodass die Bereitstellungsbefugnisse des Agenten eine Zulassungsliste darstellen und kein Shell-Skript mit Anmeldeinformationen.
- Staffeln Sie die Autonomie nach Umgebung. In der Entwicklung wird der Agent frei bereitgestellt. In der Produktion bereitet der Agent die Veröffentlichung vor, der Release-Manager autorisiert sie und ein Hook erzwingt die Durchsetzung des Produktionsgates. Staging liegt irgendwo in der Mitte.
- Ein Rollback sollte der am häufigsten geübte Pfad in der Pipeline sein, ein einziger Befehl, den der Agent ausführen kann und der regelmäßig im Staging getestet wird. Das Closing-the-Loop-Play (Phase 6: Wartung) ruft dieses Rollback auf, wenn ein Kontrollband überschritten wird, daher muss dies im Voraus nachgewiesen werden.
Wie es aussieht (Pipeline-Schritt)
- name: Triage failed build
  if: failure()
  run: >
    claude -p "Read the build log at out/build.log. Identify the most
    likely cause, say whether the failure looks flaky or real, and write a
    three-line summary for the PR thread." >> triage.md
Überlegungen zur Governance
Das Leitprinzip besagt, dass der Agent bis zum Produktionsgate agieren, dieses jedoch nicht passieren darf. Die folgenden Steuerelemente setzen dieses Prinzip durch.
- Der Branch-Schutz verwandelt alles, was der Agent schreibt, in einen PR, ohne dass es einen direkten Weg zum Main-Branch gibt.
- Der Production-Deploy-Hook blockiert die Veröffentlichung, bis ein benannter Release-Manager sie genehmigt. Jeder nicht-interaktive Run erfolgt unter der eigenen Identität des Agenten, sodass das Pipeline-Protokoll die Aktionen des Agenten von den Aktionen des Ingenieurs unterscheidet, der den Run ausgelöst hat.
- Die Berechtigungsstufen pro Umgebung legen fest, wie viel der Agent auf dem Weg zum Gate leisten darf.
Wartung und Prozessabschluss
Bisher haben wir besprochen, wie Claude in jeder Phase des SDLC-Prozesses hinzugefügt werden kann, wobei für jede Phase ein Mensch erforderlich ist, der die ersten Schritte einleitet. In dieser Phase liegt der Schwerpunkt jedoch auf der autonomen Ausführung von Claude, um den Prozess abzuschließen.
Ein kontinuierlich laufender Überwachungsagent könnte beispielsweise auf der Grundlage eines Bug-Tickets eine intent.md erstellen und die Anforderungs-, Planungs-, Build-, Test- und Überprüfungsphasen durchlaufen. Stufe 6: Die Wartung läuft headless, mit einem unabhängigen Confidence Gate zwischen den Stufen, einer deterministischen Prüfung oder einem adversariellen Prüf-Agenten, die entscheiden, ob die Ausgabe der vorherigen Stufe weiterverarbeitet oder an einen Menschen eskaliert wird.
Den Prozess abschließen
Ein deterministisches Skript überwacht die Produktion und ruft Claude auf, wenn eine Regelgrenze verletzt wird. Die Überwachung eines Verstoßes ist ein hilfreiches Beispiel für das Muster eines autonomen Ablaufs, während der Abschnitt Claude Tag (öffentliche Beta) am Ende der Phase Arbeiten behandelt, die über verschiedene Kanäle eingehen.
Wie es ausgeführt wird
- Der Service-Owner oder Plattform-Engineer wählt eine Kennzahl mit einer stabilen und fortlaufenden Basis, wie z. B. die CI-Testfehlerrate, die 5xx-Rate nach der Bereitstellung oder die PR-Zykluszeit.
- Sie schreiben das Erkennungsskript, wobei sie in der Regel den Mittelwert und die Standardabweichung über ein fortlaufendes Zeitfenster mit Regeln (Western Electric oder Ähnliches) verwenden, damit die Bänder sowohl eine langsame Drift als auch Spitzen erfassen. Das Skript ist versionskontrolliert und unit-getestet, und die Erkennung erfolgt völlig deterministisch, ohne dass ein Modell beteiligt ist.
- Die Reaktionsstufen werden in der versionskontrollierten Konfiguration definiert (
bands.yamlunten). Bei 1σ protokolliert das Skript nur, bei 2σ wird Claude Read-Only zur Diagnose verwendet und bei 3σ kann Claude handeln, allerdings nur durch Öffnen eines PR im Review-Gate oder durch Auslösen eines vorab genehmigten Runbooks. - Die Trigger-Ebene kann ein geplanter Workflow in GitHub oder GitLab, ein Webhook aus dem bestehenden Monitoring-Stack oder ein Cron-Job innerhalb des Netzwerks sein. Claude wird stateless ausgeführt, entweder als nicht-interaktiver Schritt auf einem CI-Runner oder als Agent SDK-Service in einem Sandbox-Container, und das CI/CD-Play deckt die Bereitstellungs- und Modellzugriffsoptionen ab. Da der Lauf zustandslos und nicht interaktiv ist, kann eine Schleife beginnen und enden, ohne dass jemand sie startet.
- Der Agent schreibt seine Diagnose als
intent.mdim Format „Stage 1: Plan“ und deckt dabei die Anomalie und ihre Nachweise, ein vorgeschlagenes Ergebnis, die betroffenen Systeme sowie alle offenen Fragen ab. Von da an durchläuft der Befund die Pipeline wie alles andere auch. - Der Service-Owner oder der On-Call-Ingenieur sichtet die Warteschlange und leitet die produktbezogenen Ergebnisse an den Product-Owner weiter. Jetzt beheben, planen oder verwerfen. Dezimierer stimmen die Bänder ab und helfen, Noise zu reduzieren.
- Wenn ein Fix ausgeliefert wird, fügen Sie ein Eval für den Vorfall hinzu (das Continuous Evals Play), um sicherzustellen, dass solche Probleme in Zukunft vermieden werden.
Wie es aussieht (z. B. eine bands.yaml zur Überwachung der CI-Testfehlerrate)
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: { action: log }
  2sigma: { action: diagnose,
            tools: "Read,Grep,Bash(gh run view *)" }
  3sigma: { action: propose,
            routes: [pull_request, runbook:rollback-deploy] }
Überlegungen zur Governance
Die Tier-Grenzen werden über die versionskontrollierte Konfiguration erzwungen, wobei Berechtigungen und verwaltete Einstellungen den Produktionszugriff verweigern. Aufrufe, Ergebnisse und Entscheidungen zur Einstufung werden mit einem Zeitstempel protokolliert. Ein Service-Owner sichtet und genehmigt die Ergebnisse, die resultierenden Änderungen durchlaufen das normale PR-Prüfverfahren und die Runbooks, die der Agent eventuell auslöst, wurden im Voraus genehmigt.
Beispiele
- Wenn die Fehlerrate des CI-Tests 3σ überschreitet, stellt der Agent den instabilen Test unter Quarantäne oder eröffnet einen Revert-PR, und das Review-Gate entscheidet.
- Wenn die 5xx-Rate nach der Bereitstellung 3σ überschreitet und eine Bereitstellung im Zeitfenster stattfindet, löst der Agent die bestehende Rollback-Pipeline aus.
- Wenn die PR-Zykluszeit eine Drift-Regel auslöst, erstellt der Agent einen Bericht für die Engineering-Führung, der zeigt, dass das Harness sowohl für Prozess- als auch für Produktionskennzahlen funktioniert.
Wiederkehrende Codebasis-Scans
Ein Sicherheitsscan ist eine punktuelle Aussage über eine Codebasis unter einem bestimmten Modell, und beide Hälften veralten: Der Code ändert sich jede Woche, und jede Modellgeneration findet Schwachstellen, die die vorherige übersehen hat. Die KI-native Antwort besteht darin, den Scan nach einem Zeitplan durchzuführen, ohne dass ein Mensch am Aufrufpfad beteiligt ist, und die Ergebnisse über die gleichen Qualitäts-Checkpoints zu übermitteln wie jede andere Änderung an der Codebasis.
Claude Security ist die gehostete Form des geplanten Scans. Verbinden Sie ein GitHub-Repository, und die Scans werden mit Claude Mythos 5 in der Infrastruktur von Anthropic ausgeführt, wobei jeder Befund vor der Meldung validiert und mit einer Konfidenzbewertung versehen wird. Die vorgeschlagenen Patches werden in Claude Code im Web überprüft und angewendet. Das Unternehmen erhält die Ergebnisse, ohne Zugriff auf das Modell selbst zu benötigen.
Wie es ausgeführt wird
- Der Sicherheitsverantwortliche verbindet die Repositories und ordnet sie in Projekte nach Repo, Service oder Team ein, sodass die Zuständigkeit für die Ergebnisse von Anfang an klar ist.
- Führen Sie einen ersten vollständigen Scan der wichtigsten Repositories durch, einschließlich solcher, die zuvor von anderen Tools oder älteren Modellen gescannt wurden. Betrachten Sie den ersten Scan als Ausgangsbasis. Der erste Scan wird wahrscheinlich Schwachstellen bei Code aufdecken, der als sauber eingestuft wurde.
- Legen Sie einen Zeitplan pro Projekt fest. Ein wöchentlicher Scan ist ein sinnvoller Standardwert für aktiv entwickelte Services; begrenzen Sie Scans auf ein Verzeichnis oder einen Branch, wenn ein Repository groß oder gemischt ist.
- Analysieren Sie die Ergebnisse unter Berücksichtigung vorliegender Konfidenzbewertung. Geben Sie einen Grund an, damit die Ablehnung aufgezeichnet und dasselbe Ergebnis beim nächsten Durchlauf nicht als neu angegeben wird.
- Öffnen Sie für einen begrenzten Befund den vorgeschlagenen Patch in Claude Code im Web, überprüfen Sie ihn und reichen Sie ihn wie jede andere Änderung durch das PR-Review-Gate ein. Der Agent, der den Fix vorgeschlagen hat, hat keine Möglichkeit, ihn zu genehmigen.
- Schreiben Sie alle Probleme, die größer sind als ein Patch, wie z. B. eine Schwäche in der Architektur oder ein Muster, das sich in allen Services wiederholt, als
intent.mdim Stage 1-Format, beginnen Sie es bei Plan. - Wenn ein Fix für die Produktion freigegeben wird, fügen Sie der Suite ein Eval für die Schwachstellenklasse aus dem Continuous-Evals-Play hinzu, damit die Konfiguration, die den Agenten steuert, von da an anhand dieser Klasse getestet wird.
- Sie können die Ergebnisse als CSV oder Markdown exportieren oder Webhooks verwenden, um die vorhandenen Tracker- und Auditsysteme des Unternehmens als Referenzsystem zu verwenden, da die Auditoren sie dort bereits erwarten.
Überlegungen zur Governance
Der Scan erfolgt unter den Verwaltungseinstellungen des Unternehmens; das bedeutet, dass die verbundenen Repositorys, die Zuweisung von Scan-Lizenzen sowie das Ausgabenlimit zentral festgelegt werden. Jeder Befund hat ein Validierungsergebnis und eine Vertrauensbewertung, und jede Ablehnung hat einen Grund. Daher ist der Scan-Verlauf ein Audit-Protokoll darüber, was gefunden, behoben und bewusst akzeptiert wurde.
Korrekturen erreichen die Produktion über das PR-Review-Gate und Branch Protection, nicht über den Scan selbst. Claude Security ergänzt die bestehenden statischen Analysen und Abhängigkeitsprüfungen. Die deterministischen Prüfungen bleiben in der CI, und die modellgesteuerte Suche deckt die kontextabhängigen Schwachstellen ab, für deren Erkennung diese Prüfungen nicht ausgelegt sind.
Claude auf Abruf mit Claude Tag
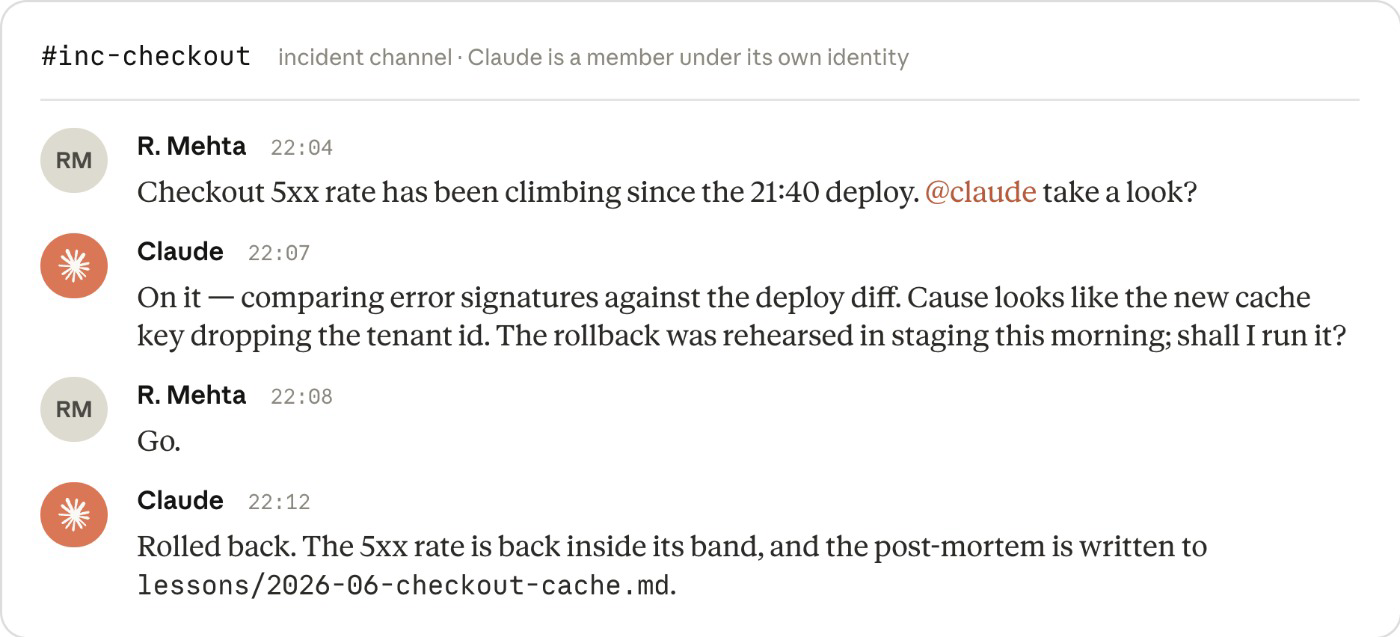
Vorfälle können auch über andere Kanäle eingehen, z. B. über Kommunikations-Apps für Unternehmen wie Slack oder Teams. Sie könnten z. B. als Slack-Nachricht spätnachts eingehen und die eine dringende Behebung eines Vorfalls-Channels verlangen. Der Vorfall kann dann sofort bearbeitet werden. Claude Tag (öffentliche Beta derzeit in Slack verfügbar) macht Claude zu einem Mitglied dieser Kanäle mit eigener Identität, sodass jedem neuen Vorfall ein First Responder zugeteilt wird und die Antwort selbst Teil der Schleife und des Gedächtnisses für zukünftige Vorfälle wird.
Die Konversation und das institutionelle Wissen bleiben im Kanal, wobei alle Teilnehmer des Kanals die Antwort steuern und umsetzen können. Jedes Teammitglied kann Hypothesen testen, neue Optionen erkunden und in Echtzeit Nachforschungen anstellen, wobei der Kanalverlauf die Prüfbarkeit erhöht. Durch den Zugriff auf MCP überprüft Claude, ob die Kennzahl wieder auf dem Basiswert ist und bestätigt dies im Thread, schreibt das Post-Mortem in eine versionskontrollierte Lessons-Learned-Datei, die in zukünftigen Untersuchungen gelesen werden kann.
Vorfälle sind nicht die einzigen Aufgaben, die Claude Tag übernimmt. Ganz gleich, ob Claude in einem Ticket über MCP markiert oder im Kanal gefragt wird, Claude sichtet die Arbeit auf die gleiche Weise. Eine kleine, genau umrissene Korrektur kommt als PR durch das Überprüfungs-Gate an, und alles Größere wird als intent.md für Phase 1: Plan verfasst, woraufhin die rekursive Selbstverbesserung der der Schleife beginnt. Siehe: wie Claude Tag On-Call für CI/CD bei Anthropic arbeitet.
Abschließende Überlegungen
Modelle und Test-Harnesses sind fortschrittlicher geworden, sodass Unternehmen nicht nur die Art und Weise, wie sie Code erstellen, sondern den gesamten Softwareentwicklungszyklus transformieren können.
Bei dieser Transformation steht das menschliche Urteilsvermögen im Mittelpunkt des Prozesses und berücksichtigt die Governance- und Regulierungsanforderungen großer Unternehmen.
In diesem Leitfaden haben wir viele der Best Practices zusammengestellt, die unser Team Angewandte KI täglich für unsere Kunden umsetzt. Wir hoffen, dass er Ihnen als praktische und umsetzbare Ressource dient.
Ressourcen und Danksagungen
Die folgende Dokumentation zeigt, was ein Plattform-Team zur Einrichtung dieser Kontrollen in der ungefähren Reihenfolge ihrer Einführung benötigt.
Vielen Dank an Jim Blackhurst, Will Steuk und Jamal Arif für ihre Beiträge zu diesem Leitfaden, der von zahlreichen früheren Arbeiten inspiriert wurde und darauf aufbaut.