Anthropic が Claude でセルフサービスデータ分析を可能にする方法
多くのデータサイエンスやデータエンジニアリングチームが証言しているように、セルフサービスでのデータ分析を実現するのは従来、困難な作業でした。
ワイドで非正規化されたテーブルを通じて、技術レベルの低い同僚がデータモデルにアクセスしやすくしようとすると、ビジネスの拡大に伴い、一貫性のない定義を持つビューの重複につながることがよくあります(SQL を学ぶ意欲がほとんどない従業員にとってのギャップを埋めるにはほとんど役立ちません)。あるいは、ユーザー向けにより隔離された環境を構築することは、ビジネス上の質問のロングテールを見逃すことが多く、チームが作業をサイロ化するにつれて、指標やダッシュボードが肥大化してしまう原因になります。
LLM の台頭により、これらの課題を回避するセルフサービス分析への新たな道筋が生まれました。しかし、Claude を倉庫業務に配置して、エージェントに実行させることは、精度に対する誤った感覚を生み出す可能性があります。
アドホックなリクエストから解放された最初の歓喜は、このセットアップが、これまで慎重に選定されたデータセットへと利害関係者を導いていた基盤インフラストラクチャ、ドキュメント、専門知識から彼らを切り離していることに気づくにつれて、恐怖へと変わります。
Anthropic では、ビジネス分析クエリの 95% が Claude で自動化されており、総合的な精度は約 95% です。 このしばしば機械的反復的な作業を Claude に任せることで、データサイエンスチームは因果関係モデリング、予測、機械学習など、より戦略的な作業に集中できます。
Anthropic のトップ Claude Code ユーザー数十人とのミーティングを行い、分析エージェントの無数の設計パターンを確認した結果、LLM を活用する他のデータチーム向けのベストプラクティスをいくつかまとめました。この記事では、セルフサービス型のビジネスインサイトを促進する Claude の能力を最大限に活用するためのヒントとアプローチを、以下のように紹介します。
- 分析の正確性がコード生成の問題ではなく、コンテキストと検証の問題である理由;
- ほとんどのエラーの原因となる 3 つの障害モード;
- これらのエラーに対処するために構築したエージェント型分析スタック;
- 効果の測定方法;、および
- スキルの大半をどのように作成するかを示す基本的なテンプレート(付録を参照)
データはソフトウェアではありません。
LLM の生成能力は両刃の剣です。複雑な問題に対する創造的な解決策を可能にするメカニズムは、ハルシネーション(誤った出力)を引き起こす可能性もあります。分析エージェントの課題を完全に理解するには、コーディングエージェントと比較すると便利です。
コーディングはモデルの創造性に報酬を与えるオープンエンドのソリューション空間であり、ドキュメントとテストは、ハルシネーションに対する自然なガードレールを提供します。 対照的に、分析のユースケースでは、単一の正しいソースに基づく正解が1つだけである場合が多いものですが、その正しさを証明する決定的な方法はありません。
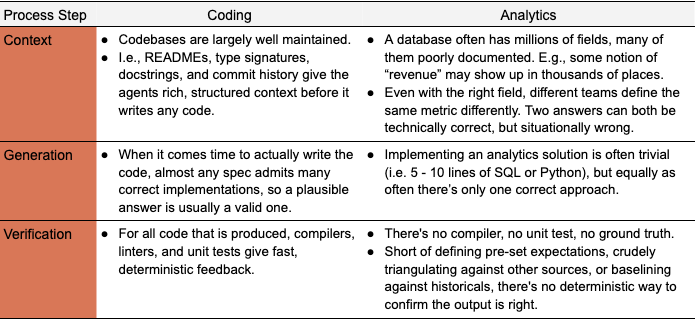
セルフサービス型のビジネス分析において、その複雑さは主にデータの曖昧さに起因します。 中心的な問題は、ユーザーの質問をデータモデル内の特定の最新のエンティティにマッピングし、それらを適切に扱う方法を把握できるかどうかにあります。それができれば、実行処理や SQL は単純なものになります。
この問題の 3 つの属性が、不正確な応答の圧倒的多数を占めていることを特定しました。
- 概念 <> エンティティの曖昧さ:データモデル内に(潜在的に数百万ものフィールドの中から)数百もの実行可能なオプションが存在するため、エージェントはユーザーの質問に最も適切に答える正しいフィールドを選択できません。たとえば、アクティブユーザー数を測定する際、「アクティブ」であると見なされるのはどのようなアクションでしょうか? 不正なユーザーは含まれていますか? どのルックバックウィンドウを使用していますか?
- データの古さ:データソース、ビジネス定義、スキーマが絶えず変化する中、資産やエージェントの知識が古くなって、微妙に間違った回答を返し始めます。
- 取得の検索失敗:適切な情報が実際にデータモデルに存在し、適切に注釈が付けられている場合もありますが、検索領域が広大であることを考えると、エージェントがそれを見つけることができないのです。
エージェント型セルフサービス分析スタック
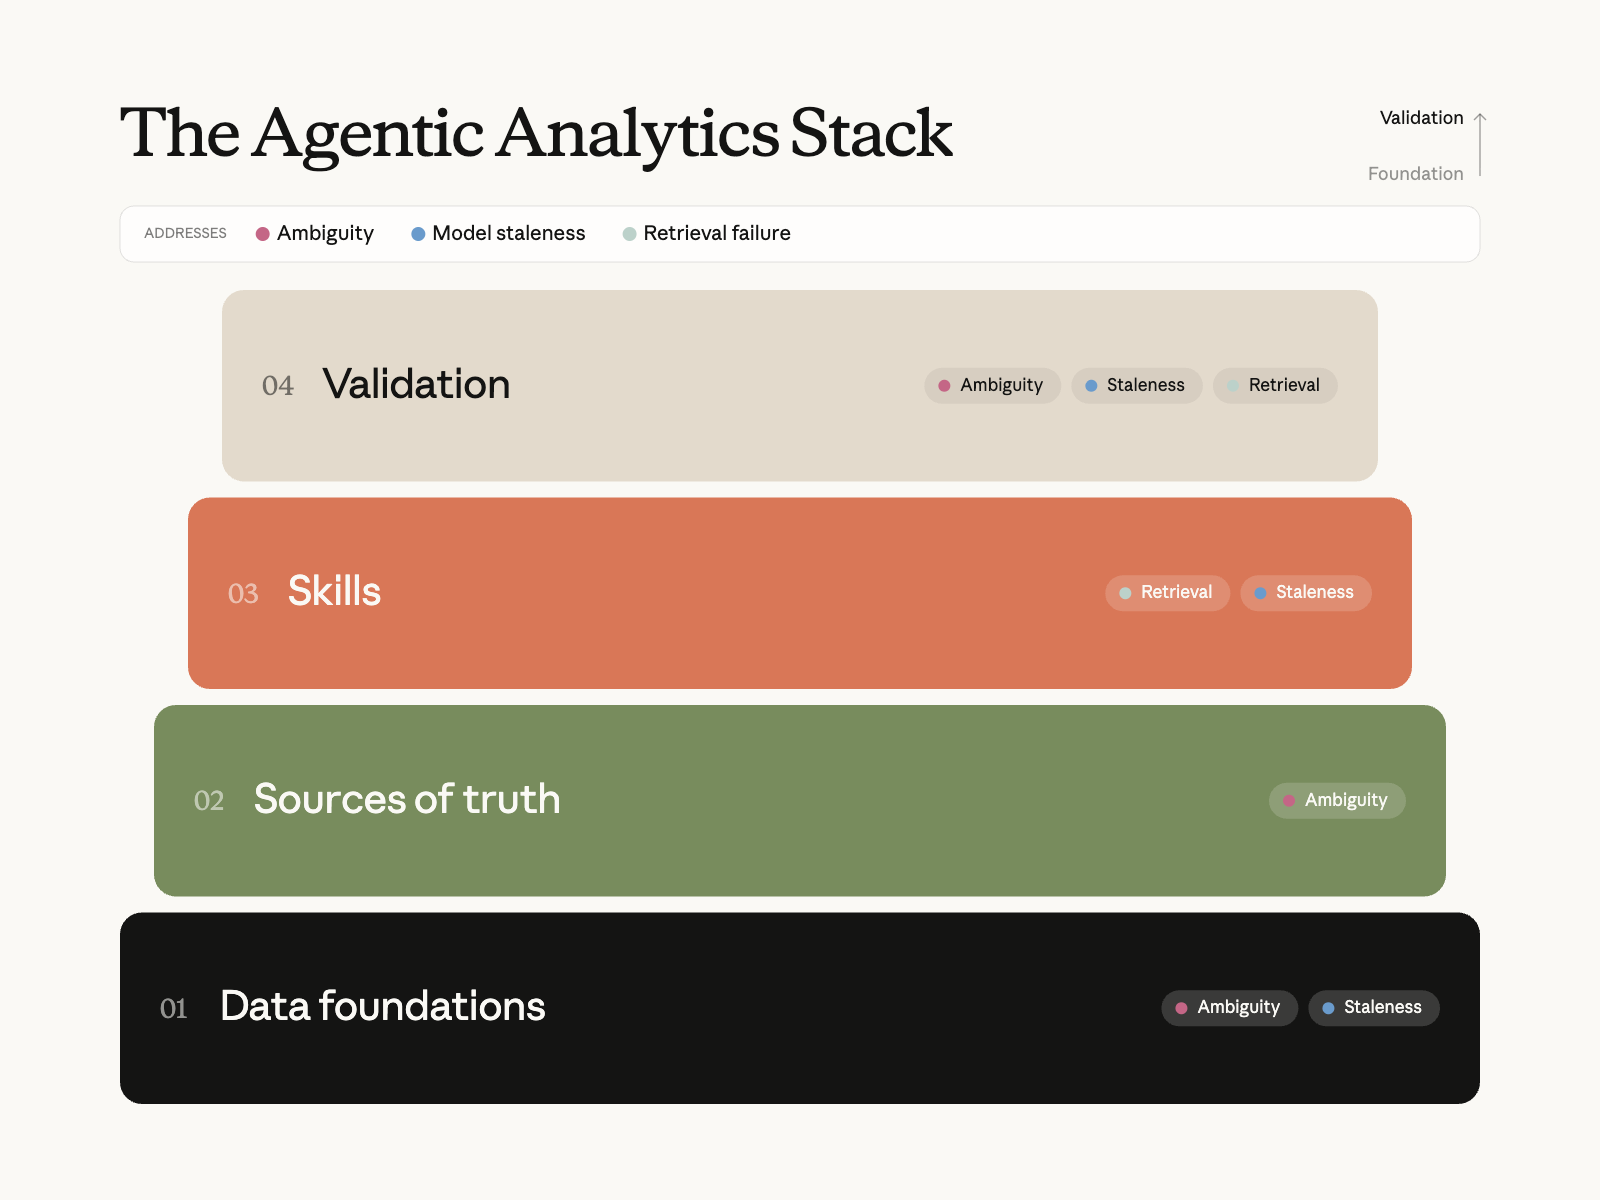
Anthropic では、これら 3 つのエラーを最小限に抑える主な方法は、当社のエージェント型データスタックを活用することです。 各レイヤーは主に、これらの問題の 1 つ以上に対処するために存在します:
- エンティティの曖昧さ:データ基盤と信頼できる情報源は、単一の管理された回答が得られるまで、妥当なエンティティの領域を狭めます。
- 老朽陳腐化:保守と検証プロセスにより、ビジネスの変化に伴ってすべてが形骸化するのを防ぎます。
- 検索失敗:スキルにより、エージェントは確実にその回答を見つけ、正しく使用できます。
このセクションでは、各レイヤーをどのように構築したかについて説明します。
“Slack で直接寄せられるアドホックな質問については、データチームが Claude Tag を活用したデータ分析エージェントをどのように導入しているかをご覧ください。”
データ基盤
分析エージェントの正確性を確保する上で最も重要な側面は、データウェアハウス内のデータモデル、変換、テスト、テーブル、およびそれらを記述するメタデータを含む、強力なデータ基盤です。標準的なデータエンジニアリングおよびデータ品質の慣行(次元モデリング、シフトレフトテスト、重要なパイプラインにおける新鮮度や完全性のチェックなど)はすべて引き続き適用されます(これらについて改めて議論はしません)。
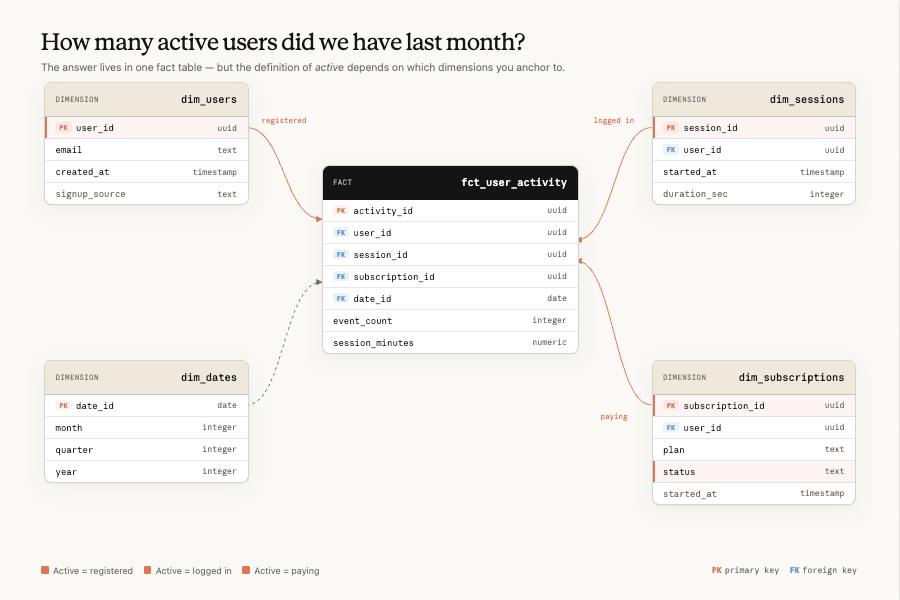
変わったのは、データモデルのエンドユーザーがもはやデータ専門家(データサイエンティストなど)ではなく、データの専門知識や基盤となるインフラストラクチャに対する理解度が異なるユーザーに代わって行動するエージェントになっているという点です。この移行には、エンドユーザーが根本的な正確性を判断できないという理由から、結果の検証をユーザーに求めることができないという課題があります。
データ基盤レイヤーは主に曖昧さに対処することを目的としています。たとえば、収益が 40 の妥当な候補ではなく1つの管理対象データセットに解決される場合、エージェントが検索を行う前に問題の大部分は解消されます。ここは最初の陳腐化防止策が存在する場所でもあります。なぜなら、標準カノニカルモデルを定義するリポジトリこそが、それらを最新の状態に保つための自然な場所だからです。
特にうまく機能するプラクティスをいくつか見てきました:
- 標準的なカノニカルデータセットを作成:圧倒的に最も一般的な失敗は、エージェントが概念(「製品 X の収益」)を単一の正しいテーブル、列、指標定義にマッピングできないことで、これは通常、実装が微妙に異なる複数の妥当な候補が存在するためです。解決策は、より少なく、より厳格に管理された論理モデルを導入することです。明確な所有者が存在し、即利用可能で、発見しやすい正規の信頼できる唯一の情報源となるデータセットを少数選定し、それ以外の類似データは積極的に非推奨としてください。物理的なロールアップとキャッシュは依然としてコストとパフォーマンスにとって重要ですが、正規なモデルと併存するのではなく、正規なモデルから機械的に導き出すべきです。目標は、エージェントがコンセプトを検索する際に、単一のガバナンスの効いた回答を見つけることです。
- 基準の適用:基準が成立するのは、正規のモデルと指標定義がツール(エージェントはまず構造的にそれらにルーティングされます。詳しくは以下参照)、CI(それらを回避する変更はレビューで不合格となります)、およびマンデーション義務化(下流のチームはガバナンスレイヤーに基づいて構築するか、そうしない理由を説明する必要があります)によって適用されている場合に限られることがわかりました。執行を伴わないガバナンスは、そうでなければすぐに複数の候補の問題へと逆戻りしてしまいます。
- アーティファクトをコロケートする:絶えず変化するデータモデルやビジネスロジックに対する当社の主な防御策は、コロケーションです。ほぼすべてのデータコード(モデリング、セマンティックレイヤー、リファレンスドキュメント、標準的なダッシュボード定義など)が 1 つのリポジトリに存在し、CI チェックによりレイヤー間の整合性が保護されます。 モデリングの変更によって下流のダッシュボードが機能しなくなったり、文書化された指標が無効になったりする場合、CI がそれを検知し、同じ PR 内で修正が反映されます。(この仕組みについては、下記のSkills セクションで再度説明します。)
- メタデータをファーストクラスの製品として扱う:コーディングエージェントが良好なパフォーマンスを発揮する理由の1つは、コードベースが読みやすいためです:README、型シグネチャ、docstring など。ウェアハウスも同じくらい判読しやすいものにできますが、カラムとテーブルの説明、標準的な指標の定義、粒度に関するドキュメント、有効な値範囲、系統、所有者、モデル階層化が、トランスフォーメーション自体と同じ厳格さで維持されている場合に限ります。目新しい洞察ではありませんが、優れたガバナンスは重要なコンテキストを提供し、エージェントが適切なデータセットを選択するのに役立ちます。
真実の情報源
データ基盤がデータウェアハウスそのものである場合、信頼できる情報源(ソース・オブ・トゥルース)は、エージェントがデータハウス内をナビゲートするために参照する基準点となります。このレイヤーは、概念エンティティの曖昧さを軽減し、利害関係者からの質問に含まれる「週間のアクティブユーザー」を、データモデル内の特定の管理対象エンティティに変えます。信頼度の高い順に、おおよそ次のとおりです:
- セマンティックレイヤー: コンパイルされた指標とディメンションの定義。 質問が定義された指標に明確にマッピングされる場合、エージェントは関数を呼び出し、社内の他のすべてのインターフェースが生成するものと同じ数値を1つ取得します。当社のエージェントは、(スキル指示により)まずセマンティックレイヤーを活用するよう構造的に求められています(付録を参照)。私たちが試みたもののうまくいかなかった アイデアの一つは、LLM に生のテーブルやクエリログから指標定義を自動生成させることで、セマンティックレイヤーをブートストラップすることでした。それは、私たちが排除しようとしていた曖昧さをそのまま内包するもっともらしい定義を生成してしまい、人間が精選した小規模なレイヤーと比較して、評価においてはマイナスの結果となりました。したがって、Claude でドキュメントを作成し、定義は人間に任せることをお勧めします。
- リネージとトランスフォーメーショングラフ:セマンティックレイヤーが質問をカバーしていない場合、リネージとテーブルのランキング(参照数に基づく)を活用することで、エージェントは、どのアップストリームモデルがコンセプトにデータを供給しているか、どれが非推奨か、どれが同じ粒度を持っているかを推論できるようになります。これにより、「メトリクスがわからない」は「どのガバナンス対象モデルから集計すればよいかがわかっている」に変わります。これはまた、以下のオンライン検証で表示する鮮度と出所のシグナルの基盤でもあります。
- クエリコーパス:ダッシュボード、ノートブック、および過去の分析から得られた履歴 SQL。直感的に言えば、これは高い価値があるはずです。すでに正しく回答されたすべての質問の記録だからです。実際には、エージェントに数千件の以前のクエリに対する生の検索アクセスを提供しても、精度は1ポイント未満しか変化しなかったことがわかりました。(このアブレーションについては、後のセクションで説明します)。非構造化検索では、新しい質問を適切な先例にマッピングできませんでした。有効なのは、そのコーパスを、スキルで説明されているドメインごとの構造化された参照ドキュメントや再利用可能な分析パターンへと抽出・集約することです。クエリ履歴を、エージェントが直接読み取る信頼できる情報源としてではなく、キュレーションの原材料として扱ってください。
- ビジネスコンテキスト:ほとんどのチームがスキップするレイヤーであり、私たちが最も長く過小評価していたレイヤーです。貴社のビジネスを理解していないエージェントは、ユーザーの質問には答えても、その真意までは汲み取れません。「第2四半期のリリース」が特定の製品を指していること、2 つのチームが同じ用語を異なる意味で定義していること、木曜日に取締役会があるために質問がされていることなどは、認識できません。索引付きドキュメント、ロードマップ、意思決定ログ、組織構造から構成される社内のナレッジグラフを取り込むことで、エージェントが文脈依存の参照を解決し、より的確な確認質問を行えるようにしています。
4 つすべてに共通する失敗パターンは、データ基盤レイヤーにおけるものと同じです。ドキュメントが貧弱または古くなっています。Claude はギャップを埋める(列の説明の草案作成、クエリパターンからのメトリクスドキュメントの提案、CIにおける文書化されていないモデルの特定)のに非常に役立ちますが、キュレーションと所有権の管理は人間が行います。
続く2つのセクションでは、その所有権を実際に実現できるほど安価にする方法について説明します。
Skills
真実のソースがエージェントの宣言的な知識(すなわち、指標の意味)である場合、スキルとは手続き的な知識です。どのソースをどの順序で参照するか、曖昧なデータをどのようにナビゲートするか、最終的な分析結果はどのようなものかなどです。
Claude Code では、スキルとは、エージェントがオンデマンドで読み込むマークダウンフォルダーのことです。 Anthropic では、私たちが開発したスキルは価値を大きく高めるものです。スキルがなければ、分析に関する質問に正確に答える Claude の能力は、当社の評価において 21% を上回りませんでした。スキルを追加することで、これらの数値は一貫して95%を超え、特定の領域では頻繁に99%前後となります。スキルの大部分を構築するために使用するスケルトンについては、付録をご覧ください。
いくつかのベストプラクティス:
ペアワイズスキルを作成:ひとつのナレッジスキルは薄い最上位ルータとして機能し、必要に応じて追加のドメインの詳細を読み込むことができます。「まずセマンティックレイヤーを試してください。もしカバーされていない場合は、このドメインに関連するテーブル、列、結合、および注意点を説明した約30件のリファレンスファイルがあります」と書かれています。このルーターは、事実上、取得失敗に対する当社の解決策です。エージェントに百万項目のウェアハウスを検索させるのではなく、クエリが書き込まれる前に、検索範囲を数十のキュレーションされたファイルに絞り込むことができます。 ランブックスキルは、シニアアナリストが従うプロセスを定義します。質問を明確にし、(ナレッジスキルを通じて)ソースを見つけ、クエリを実行し、その結果を敵対的レビューサブエージェントに通します。また、再利用可能な12の分析パターン(リテンション曲線、レート分解、ファネル分析)をバンドルしているため、一般的なリクエストに対して毎回分析を構築し直す必要がありません。
適切なリファレンスドキュメントを作成:LLM が取得できるように書かれたもの。 当社のリファレンスドキュメントでは、テーブル(粒度、スコープ、除外項目)、 注意点の仕組み(例:「既知の無料メールドメインは除外し、anthropic.com のようなカスタムドメインは維持する」)、および明示的なルーティングトリガー(例:「質問が実験のリフトに関するものである場合…生のイベントカウントには使用しない」)について、陳腐化しやすい規定的なレシピに頼ることなく説明しています。リファレンスドキュメントの作成に使用するスケルトンについては、以下を参照してください。
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]スキルメンテナンスを第一級市民として扱う:スキルドキュメントには日々変更されるデータモデルが記述されているため、積極的なメンテナンスを行わなければ、数週間以内に誤りが生じます。私たちは、オフラインの精度がリリース時の約95%から1か月間で約65%にまで低下するのを目の当たりにし、その後ようやくこれをエンジニアリングの問題として扱うようになりました。つまり、トランスフォーメーションモデルと同じリポジトリにスキルマークダウンファイルを配置する必要があったため、モデルを変更する PR は、それを説明するドキュメントを更新する PR と同じものになります。コードレビューフックは、スキルファイルの変更を伴わないレポートモデルの変更に対してフラグを立てます。現在、データモデル PR の約 90% で、同じ差分内にスキルの変更が含まれるようになっています。また、モデルが改善されて、以前の失敗モードが当てはまらなくなった場合には、定期的にスキルのスキャホールディング(足場)を整理しています。
すべてのサーフェスで一貫性のあるシームレスなエクスペリエンスを作成します:Slack、IDE、ダッシュボードツール、スタンドアロンのエージェントセッションにおいて、同じスキルが質問に対して必ず同じ回答を提供する必要があります。これは、正規のソース(データリポジトリ)を 1 つにし、スキルの変更が自動的に同期されるようにすることで実現しました。マージ時に、スキルはプラグインマーケットプレイス(IDE ユーザー向け)やクラウドストレージ ブロブ(単一のファイルを読み込むホスティングアプリ向け)に同期され、MCP を介してリソースとして直接提供されます。 また、ハードコーディングされたリポジトリパスやサーフェス固有のネームスペースを避けることで、最初からポータビリティを考慮して設計しました。
検証
最後に、検証とは、3 つの障害モードのうち、どれがまだ漏洩しているかを特定する方法です。
オフライン評価
私たちがよく目にする一般的なパターンは、データチームが分析エージェントの精度を把握するプロセスを一切持たないまま、精巧な分析環境を構築してしまうことです。
このギャップを解消する手段の 1 つとして、シンプルな質問と回答のペアからなるオフライン評価があります。オフライン評価は、オンラインエージェントのパフォーマンスを直接示すものではないという点で、MLモデルのオフラインテストと似ていると考えることができますが、重大な欠陥がないかどうかを把握する上では有用です。
Anthropic では 2 種類のオフライン評価を導入しています。 ダッシュボードベースの評価は Claude が自動的に生成し(その後、人間が検証)、ステークホルダーからの最も一般的な質問に対応します。 ロングテール評価では、Claude にビジネスコンテキスト(ロードマップ、テーブルドキュメント)を読み込ませ、ドメインの残りの部分全体にわたって妥当な質問を生成させます。また、ステークホルダーがスレッドでエージェントを修正するたびに、その修正内容が評価候補となるため、継続的に収集を行っています。
その他のベストプラクティスは以下の通りです:
- グラウンドトゥルースを固定して、ドリフトを防ぐ:ライブデータに対して作成された評価は、基盤となる数値が変化した瞬間に陳腐化します。すべての評価をスナップショットの日付に固定するか、安定したファクトテーブルに基づいて記述するか、あるいは採点者にエージェントの数値ではなくクエリを評価させるようにしてください。スイートを CI に連携することで、依存関係を変更するPR が影響を受ける評価を再実行できます。
- テストログではなく、テレメトリのように結果を保存:すべての実行は、スキルバージョン、git SHA、モデル ID、アサーションごとの合格/不合格、トークン数、実経過時間を含むウェアハウスのテーブルに保存されます。「この変更は役に立ちましたか?」 それがクエリとなり、単一の CI 実行では捉えられないパフォーマンスの低下を検知するための時系列データが得られます。
- ドメインごとのゲート付きローンチ:ドメイン所有者は、評価セットの各スライスがある一定の閾値(当初は約 90% を使用していました)をクリアするまで、関係者に対してエージェントを発表できません。ユーザーが障害を確認する前に、リファレンスドキュメントの修正を強制します。
- 適切な数の評価を作成する:実施すべき評価の数は、ビジネス分野の複雑さと基盤となるデータモデルの複雑さによって異なります。オフラインの精度がオンラインの精度をどの程度予測できるかを追跡することで調整します。トピック(「成長」など)あたり数十件を超えると効果が逓減し、モデルの世代が新しくなるごとにその上限が低下することがわかっています。
- オフライン評価の精度は約100%である必要があります:また、正解はすべて、セマンティックレイヤー(ある場合)にも到達している必要があります。繰り返しますが、このレベルの精度では、システムが間違った回答を生成しないことを保証するものではなく、適切な評価カバレッジがあることを前提として、明らかな欠落がないということを示しているに過ぎません。
アブレーション技術
スキルに関する構造的な決定(どのソースを公開するか、サブエージェントがそのレイテンシーを許容できるか、2 つのスキルを1つに統合するかなど)は、オフラインの評価セットを固定した状態で行われます。
コンポーネントを1つだけ変更し、合格率を比較します。各実行は 1 時間で完了し、多くの引数が置き換えられます。手法は、単一の結果よりも重要です:
- 検索結果がゼロ件の場合を想定して設計する。 最も有益だったアブレーションは、ネガティブなものでした。エージェントに対し、当社のダッシュボード、トランスフォーメーション、アナリストノートブックのSQL全体(数千ファイル)への直接的なgrepアクセス権を付与しました。その後、毎回の回答前に実際にそれらを読んでいることを、トランスクリプトで確認しました。精度はどちらの方向にも 1 ポイント未満の変動にとどまりました。次に、明らかな 混同を確認しました。間違っていた質問の答えは、実際にコーパスに含まれていたのでしょうか?8割方はそうです。「answer present」は「now gets it right」を予測しましたか?いいえ、反転率は横ばいでした。 情報はそこにあり、エージェントはそれを確認しましたが、それでも利用しませんでした。 この1つの実験から、ボトルネックは以前の作業へのアクセスではなく、構造(つまり、質問を適切なエンティティにマッピングすること)にあることがわかりました。その洞察により、数か月分のロードマップが変更されました。
- PR 単位でアブレート(削除)します。 有意なスキル編集はすべて、関連する評価スライスで実行前/実行後の評価を行い、その差分をPRの説明に記載します。これは「ドキュメントを改善した」という主張が正しいことを保証し、善意の追加が事態を悪化させてしまうという驚くほどよくあるケースを捉えています。
- うまくいかなかった点の短いリストを残しておきましょう。 私たちの失敗例を2つ挙げます。1つは、ある時点を過ぎてもドキュメントの改良を重ねたことです(3回連続で正味マイナスの反復に陥りました。ドキュメントは改善されるどころか、長くなる一方でした)。もう1つは、敵対的レビューアーをより安価なモデルに切り替えてレイテンシーを短縮しようとしたことです(精度の向上分はほとんど失われ、実際の速度向上も得られませんでした)。ネガティブな結果は記録するコストが低く、次の人が同じ実験を繰り返すことを防ぐことができます。
オンライン検証
最後のステップは、実際のオンラインシステムのパフォーマンスをできる限り最適化することです。私たちが実施する手順には以下が含まれます。
- 敵対的レビュー:Claude スキルを採用して、潜在的な最終回答の基盤となるすべての前提に積極的に挑戦することで、評価セットにおける精度が 6% 向上しましたが、その代償としてトークンが 32% 増加し、レイテンシーが 72% 増加しました。
- Provenance footer:すべての応答には、その応答がどのソース階層(セマンティックレイヤー › 厳選されたリファレンス › 生テーブル)から取得されたか、基盤となるデータの最新性、モデルの所有者などを含むフッターが付いています。 回答がより正確なものになるわけではありませんが、消費者が回答をどれだけ信頼できるかを判断するのに役立ちます。 「Rawテーブル、新鮮度不明」というフッターは、上流へ転送する前に検証すべきシグナルであり、サイレント障害に対して私たちが講じられる数少ない緩和策の1つです。
- データ品質チェック:エージェントが適切な方法で正しいフィールドを使用しているにもかかわらず、データ自体が正しくない可能性があります。 参照フィールドが最新かつ完全で、異常がないことを確認するために基本的なデータ品質チェックを追加することは、一般的に良い習慣です。
- 受動的な監視:私たちが継続的に追跡している2つの本番環境シグナルは、セマンティックレイヤーを介して解決されたエージェントクエリの割合と、訂正言語(「それは間違ったテーブルです」「不正フィルターが適用されていません」)を使用する応答の割合です。どちらもダッシュボードに反映され、オフラインの合格率と合わせて毎週レビューされます。
- アクティブな修正収集:ループを閉じる部分。 定期実行されるエージェントが、数時間おきにステークホルダーチャネルをスキャンして類似の修正文言を検出し、関連するリファレンスドキュメントに対する1行の修正草案を作成して、ドメイン所有者をタグ付けしたPRをオープンします。修正手順は意図的に単調なものにしています。マークダウンファイルの編集、マージ、自動同期といった手順を踏むだけで済むため、ドメイン所有者がタスクに多くの時間を費やす必要はありません。同じ修正内容がオフラインの評価セットに反映されます。
これらでは完全には捉えきれない障害モードが、サイレントなものです。答えは間違っていますが、もっともらしく見え、異論なく使用されています。当社の緩和策は、出所フッター、リーダーシップ層に報告されるあらゆる事項に対する明示的な人間による承認、そして各ドメインの主要KPIに対する常時評価であり、毎日、承認済みのダッシュボードと照合して妥当性確認を行っていますが、まだ堅牢なソリューションには至っていません。
セルフサービス分析の始め方
ゼロから始める場合、数件の標準的なデータセット、数十件のオフライン評価、そして軽量な知識スキルがあれば、大部分の成果が得られるでしょう。この記事のその他の内容は、それらを構築した後に追加したものです。
また、多くのベストプラクティスを共有しましたが、そのすべてが各データチームに適しているわけではありません。アプローチに影響を与えるいくつかの原則について、以下の質問を通して組織と認識を合わせてください:
- 現在と将来において、正しい答えを出すことの重要性はどの程度ですか?AI モデルは急速なペースで進化しています。 私たちは、現在のモデルの欠点を補うために多大なインフラストラクチャを構築する企業をよく目にしますが、そうしたインフラはモデルが改善されると不要になります。モデルの限界を把握し、そのギャップを埋めるためにモデルの改善を待つ方がオーバーヘッドを大幅に削減できますが、自社のリスク許容度には適合しない可能性があります。
- 時間の経過とともにビジネスの複雑さがどのように変化していくことを予測していますか?私たちが話し合ったプロセスの中には、たとえば生成するデータが少ない場合や、出力の利用者がわずかである場合、あるいはデータモデルがシンプルなまま維持されそうな場合など、やりすぎ(オーバーキル)となる可能性があります。
- アウトプットの対象となるオーディエンスは、どの程度の技術知識を持っていますか?別の言い方をすれば、回答が間違っていることを認識できるデータサイエンティスト向けにこの分析システムを構築している場合、基盤となるデータモデルを全く知らないオーディエンスを対象とする状況と比べて、エラーに対してより寛容になれるかもしれません。
- 精度を向上させるために、いくらまで支払うことができますか?敵対的検証のような特定のプロセスが精度を大幅に改善できることがわかりましたが、多くの場合、コストとレイテンシーが高くなります。
- アクセス制御と社内データのプライバシーについて、どの程度安心していますか?エージェントは多くの場合、コンテキストが多いほどパフォーマンスが大幅に向上しますが、広範なデータアクセスは、ほとんどの企業のガバナンス体制と矛盾します。これにより、単一のエージェントを構築するのか、スコープ化された複数のエージェントを構築するのかが決まります。
どのようなルートをとるにせよ、私たちが最大の成果を得られたのは、3 つの失敗モードのそれぞれに対処してきたからです。具体的には、曖昧さを単一の管理された回答に集約すること、その回答を容易に発見できるようにすること、そしていずれかが古くなった場合にフラグを立てることです。
本記事は、データサイエンスおよびデータエンジニアリングチームのメンバーである Chen Chang、Clement Peng、Justin Leder、Johanne Jiao、Josh Cherry が執筆しました。 著者一同、Michael Segner 氏の貢献に感謝いたします。
付録
スキルファイルの雛形
以下は、当社の主要な倉庫スキルの骨組みです。実際のファイルの構造であり、内部の詳細は[括弧で囲まれたプレースホルダー]に置き換えられています。そのままコピーするものではなく、私たちが書き留める価値があると考えたセクションを示すためのものです。
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]