Verbesserung des Skill-Creatorss: Agenten-Skills testen, messen und verfeinern
Skill-Autoren können jetzt überprüfen, ob ihre Skills funktionieren, Regressionen erkennen und Beschreibungen verbessern.
Mit Skill-Creator können Sie jetzt Evaluierungen schreiben, Benchmarks ausführen und dafür sorgen, dass Ihre Skills auch weiterhin funktionieren, wenn sich Modelle weiterentwickeln. Diese Updates sind jetzt in Claude.ai und Cowork, als Plugin für Claude Code und in unserem Repository verfügbar.
Seit der Einführung von Agentenskills im Oktober letzten Jahres haben wir festgestellt, dass die meisten Autoren Experten in ihrem Fach und keine Entwickler sind. Sie kennen ihre Workflows, haben jedoch nicht die Tools, um festzustellen, ob ein Skill mit einem neuen Modell immer noch funktioniert, ob er ausgelöst wird, wann er sollte, oder ob er sich nach einer Änderung tatsächlich verbessert hat.
Heute stellen wir Verbesserungen am Skill-Creator vor, die Autoren helfen, ihre Skills mit mehr Zuversicht zu entwickeln. Wir übertragen die Stringenz der Softwareentwicklung (Tests, Benchmarking, iterative Verbesserung) auf die Erstellung von Skills ohne Programmierkenntnisse.
Zwei Arten von Skills
Skills können in der Regel in zwei Kategorien unterteilt werden:
Skills zur Erweiterung von Fähigkeiten helfen Claude, etwas zu tun, was das Basismodell entweder nicht oder nicht konsistent kann. Unsere Skills zur Dokumentenerstellung sind gute Beispiele dafür. Sie beinhalten Techniken und Muster, die bessere Ergebnisse liefern als das Prompting allein.
Die Skils für eine kodierte Präferenz dokumentieren Workflows, bei denen Claude bereits jeden einzelnen Schritt erledigen kann, der Skill sie jedoch gemäß den Prozessen Ihres Teams sequenziert. Beispiele: ein Skill, der eine NDA-Überprüfung anhand festgelegter Kriterien durchläuft, oder ein Skill, der wöchentliche Updates mit Daten verschiedener MCPs erstellt.
Diese Unterscheidung ist wichtig, da diese beiden Arten von Skills aus verschiedenen Gründen getestet werden müssen:
- Skills zur Erweiterung von Fähigkeiten werden möglicherweise nicht mehr so notwendig, weil sich die Modelle verbessern. Evaluierungen zeigen Ihnen, wann es eingetreten ist.
- Kodierte Präferenz-Skills sind zwar beständiger, aber hängen davon ab, wie gut Sie zu Ihrem tatsächlichen Workflow passen. Evaluierungen überprüfen diese Genauigkeit.
In beiden Fällen wird ein Skill, der zu funktionieren scheint, durch Tests in einen Skill umgewandelt, von dem Sie wissen, dass er funktioniert.
Verwenden von Evaluierungen zum Testen und Verbessern von Skills
Skill-Creator hilft Ihnen jetzt beim Schreiben von diesen Evaluationen. Dabei handelt es sich um Tests, die überprüfen, ob Claude das tut, was Sie für einen bestimmten Prompt erwarten. Wenn Sie bereits ein paar Softwaretests geschrieben haben, wird sich dies vertraut anfühlen: Definieren Sie einige Test-Prompts (und ggf. Dateien), beschreiben Sie, wie ein gutes Ergebnis aussieht, und der Skill-Creator sagt Ihnen, ob der Skill standhält.
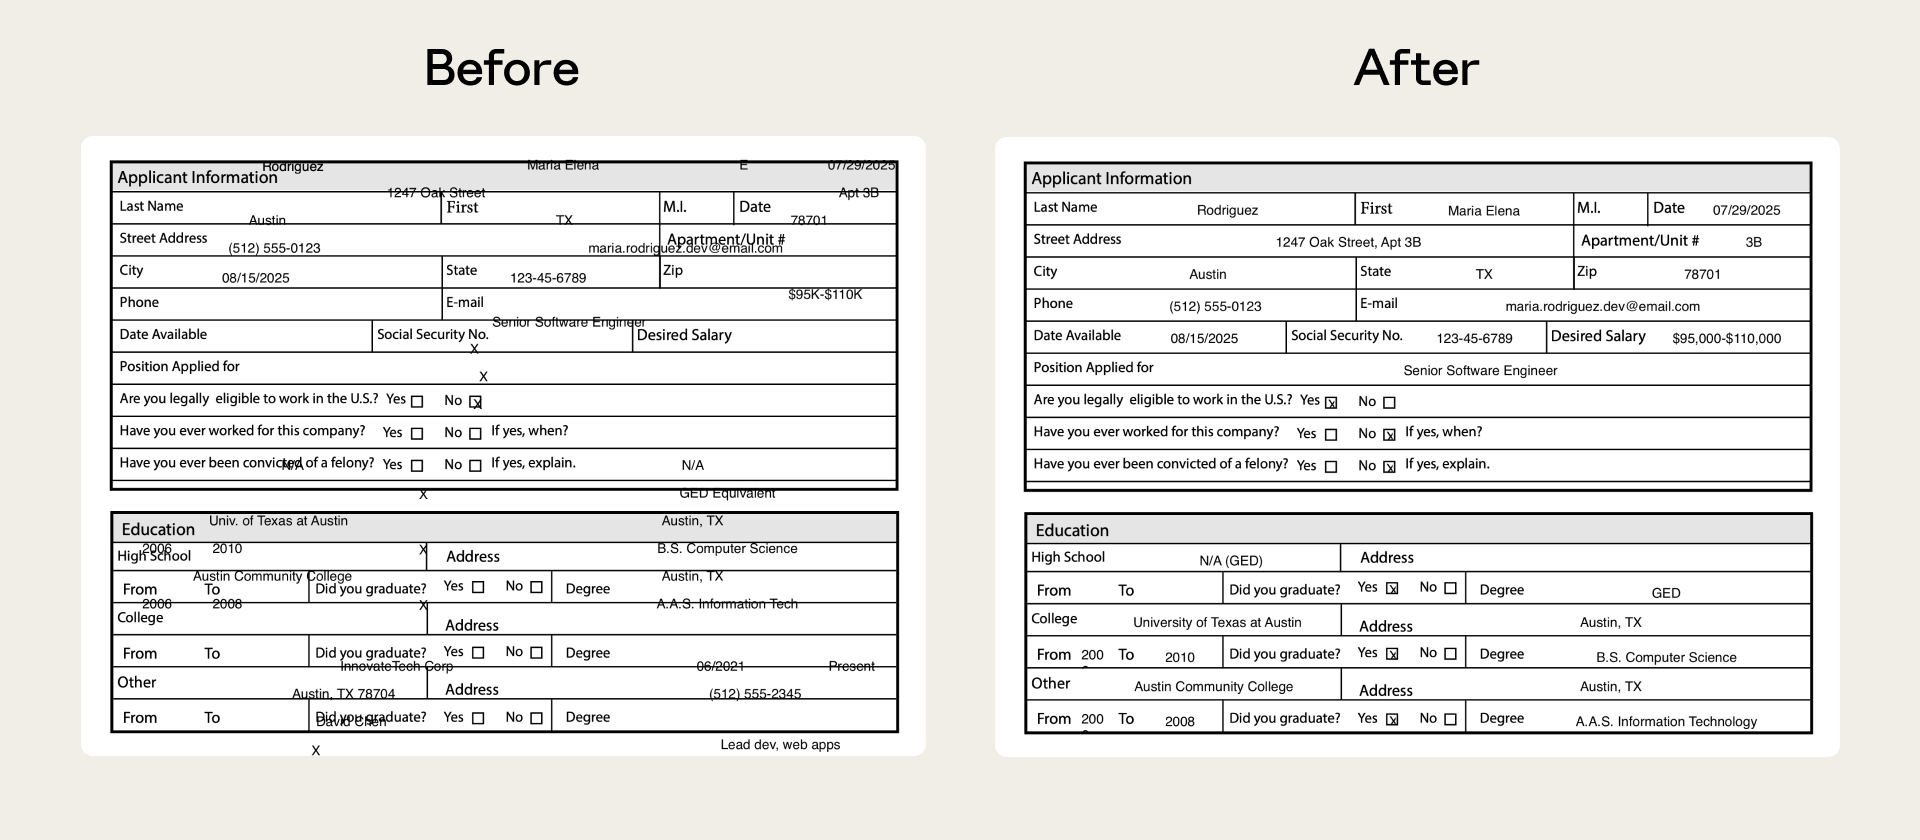
Unser PDF-Skill hatte beispielsweise bisher Probleme mit nicht ausfüllbaren Formularen. Claude musste Text an genauen Koordinaten platzieren, ohne dass definierte Felder vorhanden waren, die als Orientierung dienten. Evaluationen isolierten den Fehler, und wir haben einen Lösung bereitgestellt, der die Positionierung an extrahierten Textkoordinaten verankert.
Evaluationen sind in vielerlei Hinsicht hilfreich, aber zwei wichtige Anwendungen sind die Erfassung von Qualitätsregressionen und das Nachvollziehen des Modellfortschritts.
Schauen wir uns zunächst das Erkennen von Qualitätsregressionen an. Da sich Modelle und die Infrastruktur um sie herum weiterentwickeln, kann es sein, dass sich ein Skill, der letzten Monat gut funktioniert hat, heute anders verhält. Wenn Sie Evaluierungen anhand eines neuen Modells durchführen, erhalten Sie bei Änderungen frühzeitig ein Signal - und zwar bevor sie sich auf die Arbeit Ihres Teams auswirken können.
Zweitens ist es wichtig zu erkennen, wann die allgemeinen Modellfähigkeiten besser als Ihr eigener Skill geworden sind. Dies gilt hauptsächlich für Skills zur Verbesserung von Fähigkeiten. Wenn das Basismodell beginnt Ihre Evaluierungen zu bestehen, ohne dass der Skill geladen wird, ist dies ein Signal dafür, dass die Techniken des Skills möglicherweise in das Standardverhalten des Modells integriert wurden. Der Skill ist nicht defekt, er wird nur nicht mehr benötigt.
Wir haben auch einen Benchmark-Modus hinzugefügt, der eine standardisierte Bewertung auf Grundlage Ihrer Evaluierungen durchführt. Sie können dies nach Modellaktualisierungen oder bei der Weiterentwicklung des Skills selbst ausführen. Sie verfolgt die Bestehensrate der Evaluierungen, die verstrichene Zeit und die Tokennutzung.
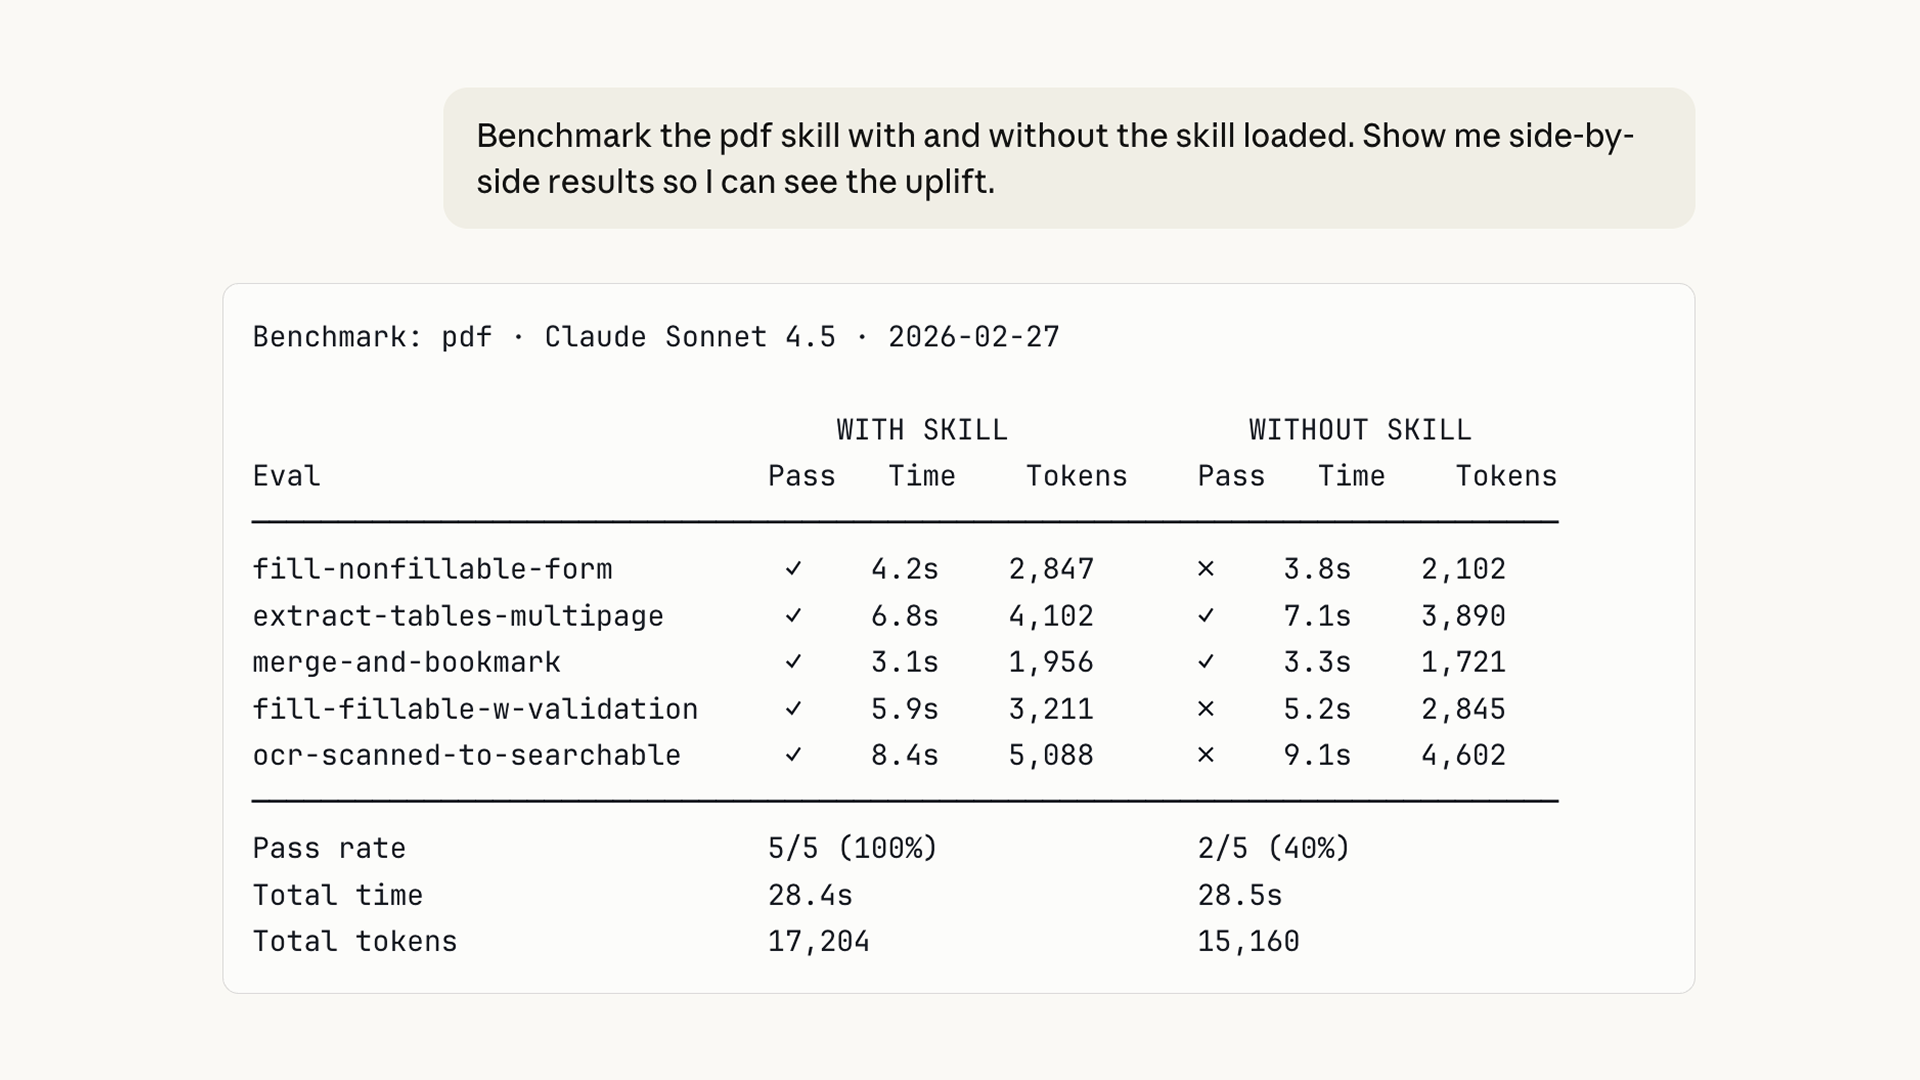
Ihre Evaluierungen und Ergebnisse bleiben bei Ihnen. Speichern Sie sie lokal, integrieren Sie sie in ein Dashboard oder schließen Sie sie an ein CI-System an.
Schnellere und konsistentere Evaluierung mit Multi-Agenten-Unterstützung
Die sequenzielle Ausführung von Evaluierungen kann langsam sein, und angesammelter Kontext kann zwischen den Testläufen durchsickern. Skill-Creator startet jetzt unabhängige Agenten, um Evaluierungen parallel mit Multi-Agenten-Unterstützung durchzuführen – jeder in einem sauberen Kontext mit eigenen Token- und Zeitmetriken. Schnellere Ergebnisse, keine Kreuzkontamination.
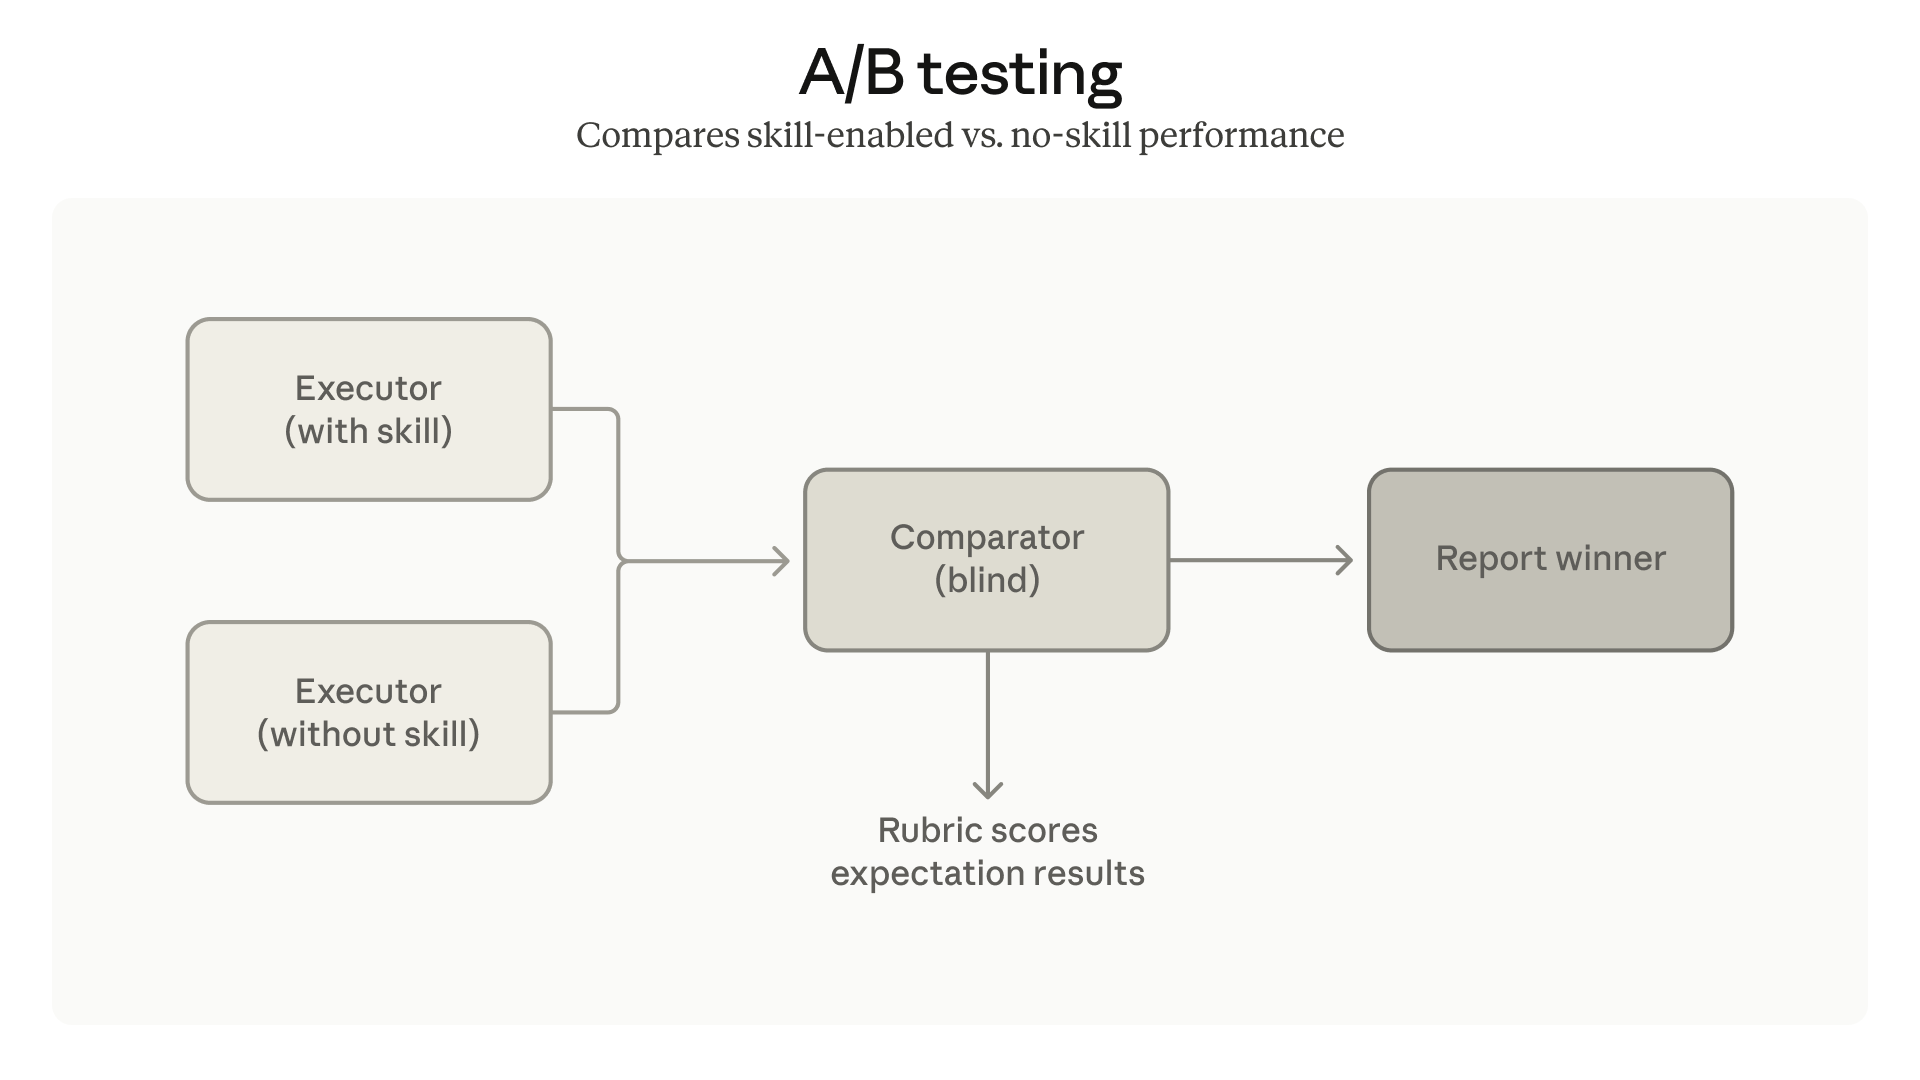
Wir haben auch Vergleichsagenten für A/B-Vergleiche hinzugefügt: zwei Versionen eines Skills oder Skill vs. kein Skill. Sie beurteilen die Ergebnisse, ohne zu wissen, welches welches ist, sodass Sie feststellen können, ob eine Änderung tatsächlich geholfen hat.
Auslösung von Skills zum richtigen Zeitpunkt
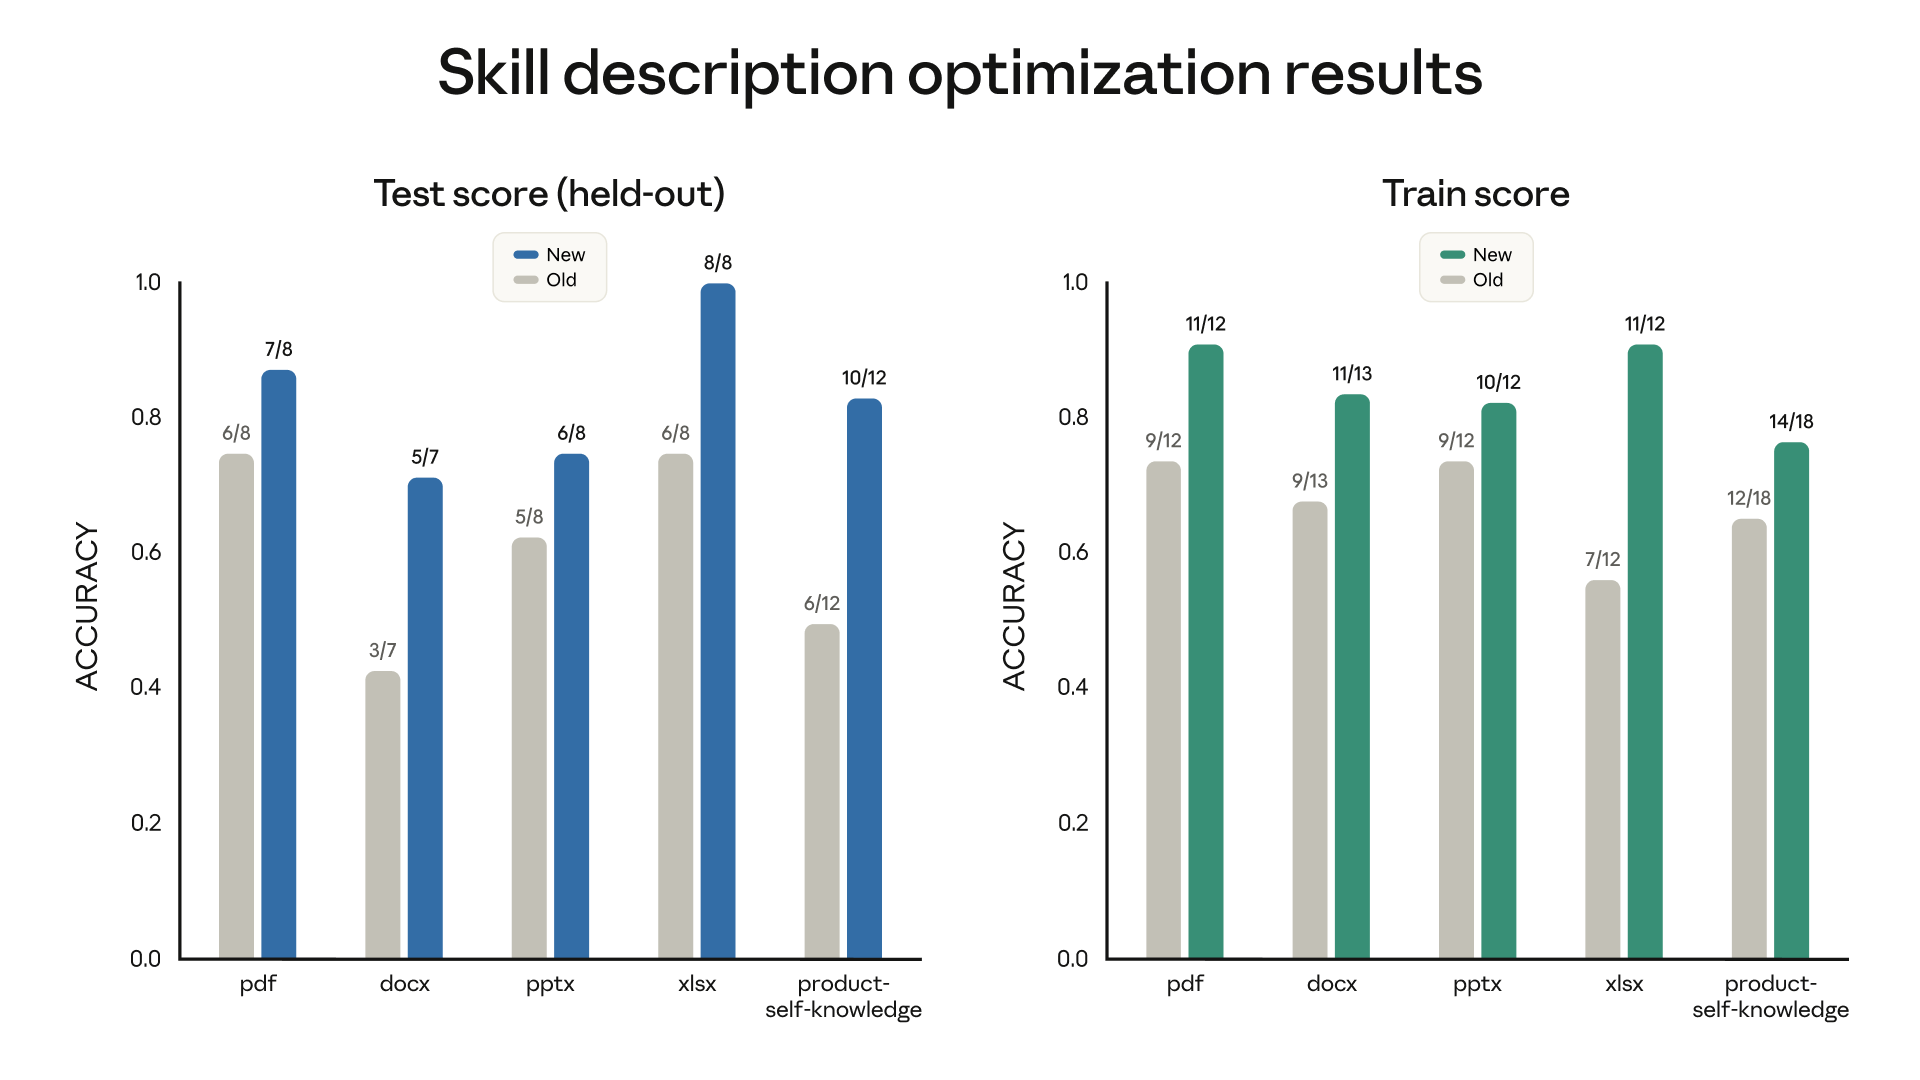
Evaluationen messen die Ausgabequalität, aber das ist nur wichtig, wenn Ihr Skill ausgelöst wird, wenn er es soll. Bei einer steigenden Anzahl von Skills wird die Genauigkeit der Beschreibung kritisch: zu allgemein gehalten und Sie erhalten falsche Trigger, zu eng gefasst und er wird nie ausgelöst. Skill-Creator hilft Ihnen jetzt, Beschreibungen für eine zuverlässigere Auslösung zu optimieren — er analysiert Ihre aktuelle Beschreibung anhand von Beispiel-Prompts und schlägt Änderungen vor, die sowohl falsch-positive als auch falsch-negative Ergebnisse reduzieren.
Wir haben es auf unsere Skills zur Dokumenterstellung angewendet und konnten bei 5 von 6 öffentlichen Skills eine verbesserte Auslösung feststellen.
Blick in die Zukunft
Durch die Verbesserung der Modelle kann die Grenze zwischen „Skill“ und „Spezifikation“ verschwimmen. Heute ist eine SKILL.md-Datei im Wesentlichen ein Implementierungsplan mit detaillierten Anweisungen für Claude, wie etwas zu tun ist. Im Laufe der Zeit könnte eine Beschreibung in natürlicher Sprache dessen ausreichen, was der Skill tun soll, und das Modell findet den Rest allein heraus.
Der Evaluationsrahmen, den wir heute veröffentlichen, ist ein Schritt in diese Richtung. Evaluationen beschreiben bereits das „Was“. Letztendlich kann es sich bei dieser Beschreibung um den Skill selbst handeln.
Erste Schritte
Alle Aktualisierungen des Skill-Creators sind jetzt auf Claude.ai und Cowork verfügbar. Bitten Sie Claude, den Skill-Creator zu verwenden.
Nutzer von Claude Code können das Plugin installieren oder es aus unserem Repository herunterladen.