Wie Anthropic mit Claude Self-Service-Datenanalysen ermöglicht
Wie viele Data Science- und Data Engineering-Teams bestätigen können, war die Bereitstellung von Self-Service-Datenanalysen traditionell eine mühsame Angelegenheit.
Der Versuch, das Datenmodell für weniger technisch versierte Mitarbeitende über breite und denormierte Tabellen zugänglicher zu machen, führt bei wachsenden Unternehmen oftmals zu sich überschneidenden Ansichten mit inkonsistenten Definitionen (was Mitarbeitende nur wenig dazu motiviert, SQL zu erlernen). Andererseits werden bei der Schaffung stärker abgeschotteter Umgebungen für Benutzer oft geschäftliche Long-Tail-Fragen übersehen, wodurch Kennzahlen und Dashboards überflutet werden, da Teams ihre Arbeit isolieren.
Mit dem Aufstieg von LLMs öffnet sich ein zusätzlicher Weg für Self-Service-Analysen ohne derlei Herausforderungen. Wenn Claude jedoch auf ein Warehouse verwiesen und den Agenten die Ausführung überlassen wird, entsteht ein falsches Gefühl der Genauigkeit.
Aus der anfänglichen Begeisterung durch die Befreiung von Ad-hoc-Anfragen wird jedoch Furcht, sobald erkannt wird, dass diese Einrichtung die Beteiligten von der zugrunde liegenden Infrastruktur, Dokumentation und Expertise trennt, durch die vorher sorgfältig kuratierte Datensätze erzielt wurden.
Bei Anthropic werden 95 % der Anfragen von Geschäftsanalysen über Claude automatisiert – mit einer Genauigkeit von insgesamt ~95 %. Durch die Übertragung dieser oft eintönigen, sich wiederholenden Arbeiten an Claude kann sich unser Data-Science-Team auf strategischere Aufgaben wie kausale Modellierung, Prognosen und maschinelles Lernen konzentrieren.
Nachdem wir uns mit Dutzenden der besten Claude Code-Nutzer von Anthropic getroffen und unzählige Designmuster für Analyseagenten gesehen haben, konnten wir einige Best Practices für andere Datenteams zusammenstellen, die mit LLMs arbeiten. In diesem Beitrag stellen wir die daraus gewonnenen Tipps und Ansätze vor, sodass Sie das meiste aus Claudes Fähigkeit zur Generierung von Self-Service-Geschäftsergebnissen holen können, darunter:
- Warum die Genauigkeit von Analysen ein Kontext- und Verifizierungsproblem ist und kein Problem der Codegenerierung;
- Die drei Fehlermodi, die die meisten Fehler verursachen;
- Der agentische Analyse-Stack, den wir zur Behebung dieser Fehler entwickelt haben;
- Wie wir die Effektivität messen; und
- Eine Basisvorlage, um zu zeigen, wie wir die Mehrheit unserer Skills entwickeln (siehe Anhang)
Daten sind keine Software
Die generativen Fähigkeiten von LLMs sind ein zweischneidiges Schwert: Die Mechanismen, die kreative Lösungen für komplexe Probleme ermöglichen, können auch zu fehlerhaften Ausgaben führen. Um die Herausforderungen, vor denen uns Analyseagenten stellen, besser verstehen zu können, hilft ein Vergleich mit Codingagenten.
Coding ist ein offener Lösungsraum, der die Kreativität der Modelle belohnt, während Dokumentation und Tests natürliche Schutzmechanismen gegen Halluzination bieten. Im Gegensatz dazu lässt sich bei Analysen oft nur eine einzige richtige Antwort aus einer einzigen richtigen Quelle erzielen, für die es keine deterministische Möglichkeit gibt, die Richtigkeit zu beweisen.
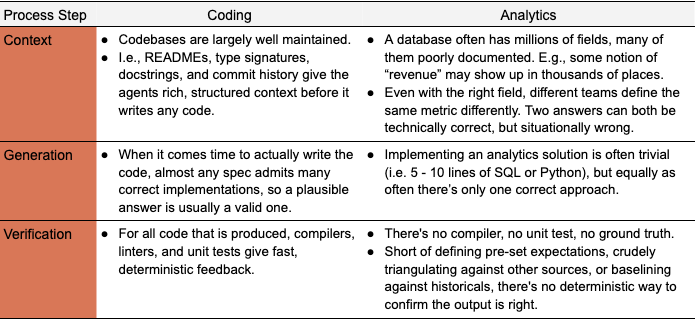
Bei agentischen Self-Service-Geschäftsanalysen liegt die Komplexität hauptsächlich in der Mehrdeutigkeit der Daten. Das zentrale Problem liegt in unserer Fähigkeit, die Frage eines Nutzers bestimmten und aktuellen Entitäten in unserem Datenmodell zuzuordnen und darin zu erkennen, wie die korrekte Arbeitsweise ist. Wenn wir das schaffen, werden die resultierenden Ausführungen und die SQL trivial.
Wir haben drei Attribute dieses Problems identifiziert, die für die überwältigende Mehrheit der ungenauen Antworten verantwortlich sind:
- Konzept <> Ambiguität der Entität: Bei Hunderten von brauchbaren Optionen in einem Datenmodell (aus potenziell Millionen von Feldern) ist der Agent nicht in der Lage, die richtigen Felder auszuwählen, die die Frage des Benutzers am besten beantworten. Zum Beispiel bei der Messung der Anzahl der aktiven Nutzer: Welche Aktionen gelten als „aktiv“? Schließen Sie betrügerische Benutzer ein? Welches Lookback-Fenster verwenden Sie?
- Datenveraltung: Datenquellen, Geschäftsdefinitionen und Schemas ändern sich ständig und die Ressourcen sowie das Wissen der Agenten veralten, was immer mehr zu subtil falschen Antworten führt.
- Fehler beim Abrufen: Die richtigen Informationen befinden sich möglicherweise im Datenmodell und sind ordnungsgemäß kommentiert, aber angesichts des breiten Umfangs des Suchbereichs findet der Agent sie einfach nicht.
Unser agentischer Self-Service-Analyse-Stack
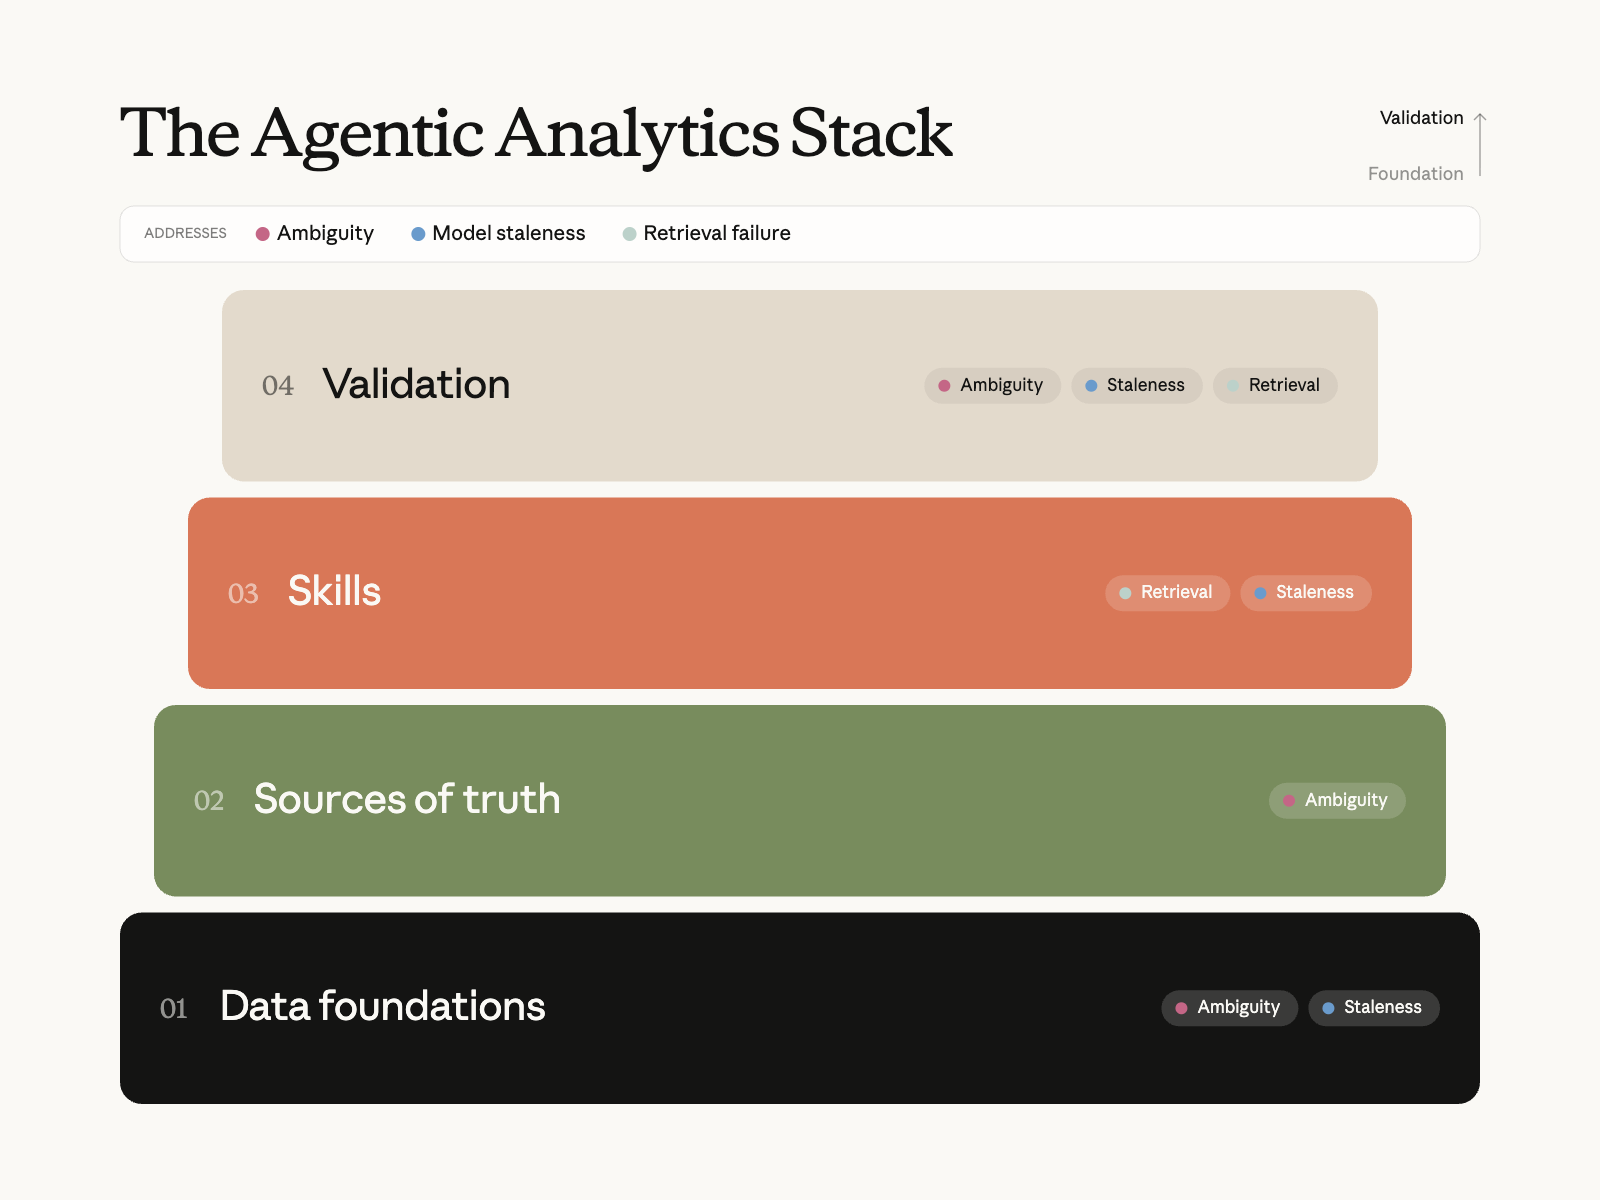
Bei Anthropic minimieren wir diese drei Fehler hauptsächlich über unseren agentischen Daten-Stack. Jede Ebene dient primär zur Lösung eines oder mehrere der folgenden Probleme:
- Mehrdeutigkeit von Entitäten: Datengrundlagen und Wahrheitsquellen verkleinern den Raum der plausiblen Entitäten, bis eine einzige autoritative Antwort vorliegt.
- Veraltung: Wartungs- und Validierungsprozesse verhindern, dass alles im Angesicht von geschäftlichen Veränderungen veraltet.
- Fehler beim Abruf: Skills stellen sicher, dass der Agent diese Antwort zuverlässig findet und korrekt verwendet.
In diesem Abschnitt erläutern wir, wie wir die einzelnen Ebenen entwickelt haben.
“Erfahren Sie, wie unser Datenteam für direkt in Slack gestellte spontane Fragen mit Claude Tag einen Datenanalyseagenten bereitstellt.”
Datengrundlagen
Am wichtigsten für die Genauigkeit von Analyseagenten ist eine starke Datengrundlage mit Datenmodellen, Transformationen, Tests und Tabellen in einem Data Warehouse sowie die Metadaten, die diese beschreiben. Standardverfahren für Data Engineering und Datenqualität wie dimensionale Modellierung, Shift-Left-Tests, Frische- und Vollständigkeitsprüfungen für kritische Pipelines gelten weiterhin (und wir werden nicht erneut darüber sprechen).
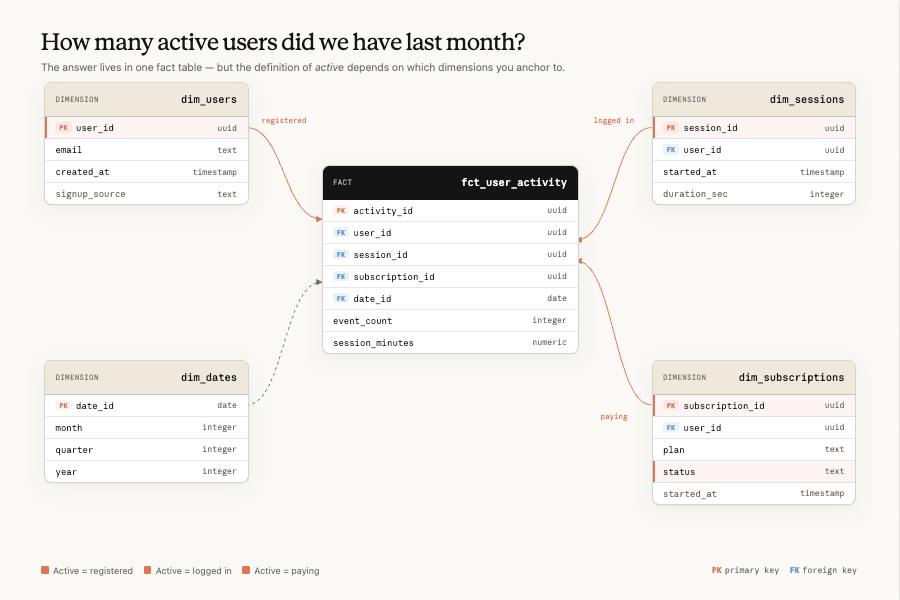
Was sich ändert, ist, dass der Endbenutzer Ihres Datenmodells kein Datenexperte mehr ist (z. B. Data Scientist), sondern vielmehr Agenten, die im Namen von Benutzern mit unterschiedlichem Datenwissen oder Verständnis für die zugrunde liegende Infrastruktur handeln. Diese Verschiebung stellt insofern eine Herausforderung dar, als die Ergebnisse nicht vom Benutzer verlangen können, die zugrunde liegende Richtigkeit zu überprüfen, nur weil der Endbenutzer es nicht weiß.
Bei der Datengrundlagenebene geht es in erster Linie um die Ambiguität: Wenn sich der Umsatz beispielsweise auf einen verwalteten Datensatz statt auf vierzig plausible Kandidaten bezieht, ist das Problem weitgehend gelöst, bevor der Agent überhaupt suchen muss. Hier wird die Veraltung zuerst bekämpft, da dasselbe Repository, das die kanonischen Modelle definiert, auch der natürlich gegebene Ort ist, um sicherzustellen, dass sie aktuell bleiben.
Wir haben einige Verfahren beobachten können, die besonders gut funktionieren:
- Kanonische Datensätze erstellen: Der mit Abstand häufigste Fehler ist, dass der Agent ein Konzept („Umsatz für Produkt X“) nicht der einzigen richtigen Tabelle, Spalte und Kennzahlendefinition zuordnen kann, da es in der Regel mehrere plausible Kandidaten mit subtil unterschiedlichen Implementierungen gibt. Die Lösung besteht in weniger, stärker regulierten logischen Modellen: Kuratieren Sie eine kleine Anzahl kanonischer, Single-Source-of-Truth-Datensätze, die nicht nur einen eindeutigen Inhaber haben, sondern nutzbar und auffindbar sind, und weisen Sie dann die Quasiduplikate aggressiv zurück. Physische Rollups und Caches sind immer noch wichtig für Kosten und Performance, sollten sich jedoch mechanisch aus den kanonischen Modellen ableiten, anstatt als Alternativen neben ihnen zu bestehen. Das Ziel ist, dass ein Agent bei der Suche nach einem Konzept eine einheitliche Antwort findet.
- Setzen Sie Ihre Standards durch: Wir haben festgestellt, dass die Grundlagen nur dann gelten, wenn die kanonischen Modelle und Kennzahlendefinitionen durch Tools (der Agent wird strukturell zuerst an sie weitergeleitet – mehr dazu unten), durch CI (Änderungen, die sie umgehen, scheitern an der Überprüfung) und per Mandat (nachgelagerte Teams bauen auf der verwalteten Ebene auf oder erklären, warum nicht) durchgesetzt werden. Eine Governance ohne Durchsetzung führt schnell zu einem Problem mit mehreren Kandidaten.
- Artefakte zusammenführen: Unsere wichtigste Abwehr gegen sich ständig ändernde Datenmodelle und Geschäftslogik ist die Zusammenführung an einem Ort. Nahezu die gesamte Datencodierung (z. B. Modellierung, semantische Ebene, Referenzdokumente, kanonische Dashboard-Definitionen) befindet sich in einem einzigen Repository, wobei zum Schutz der schichtübergreifenden Integrität CI-Prüfungen erfolgen. Wenn eine Modellierungsänderung ein nachgelagertes Dashboard beschädigen oder eine dokumentierte Kennzahl ungültig machen würde, wird sie von CI markiert und die Korrektur im selben PR mitgeliefert. (Im Abschnitt Skills unten kommen wir noch einmal auf die Mechanik zurück.)
- Behandeln Sie Metadaten als erstklassiges Produkt: Codingagenten schneiden gut ab, weil Codebasen lesbar sind: READMEs, Typesignaturen, Docstrings usw. Ihr Warehouse kann genauso lesbar sein, aber nur, wenn die Spalten- und Tabellenbeschreibungen, die kanonischen Kennzahlendefinitionen, die Granularitätsdokumentation, gültige Wertebereiche, die Herkunft, die Zuständigkeiten und die Modellstufen mit der gleichen Sorgfalt wie die Transformationen selbst gepflegt werden. Eine gute Governance ist zwar keine neue Erkenntnis, bietet aber einen entscheidenden Kontext, der dem Agenten bei der Auswahl der richtigen Datensätze hilft.
Sources of Truth
Wenn die Datengrundlagen das Data Warehouse selbst sind, dann sind Sources of Truth die Referenzquellen, die der Agent heranzieht, um sich darin zurechtzufinden. Diese Ebene reduziert die Unklarheit des Konzepts <> der Entität und verwandelt die „wöchentlich aktiven Nutzer“ in die Frage eines Beteiligten in eine spezifische, verwaltete Entität in Ihrem Datenmodell. Ungefähr in absteigender Reihenfolge des Vertrauens:
- Semantische Ebene: die kompilierten Kennzahlen- und Dimensionsdefinitionen. Wenn eine Frage eindeutig einer definierten Kennzahl zugeordnet wird, ruft der Agent eine Funktion auf und erhält eine Zahl – dieselbe Zahl, die jede andere Oberfläche im Unternehmen produziert. Unsere Agenten müssen strukturell (durch Skill-Anweisungen) zuerst die semantische Ebene nutzen (siehe Anhang). Eine Idee, die wir ausprobiert haben, die jedoch nicht funktioniert hat: das Bootstrapping der semantischen Ebene, indem ein LLM automatisch Kennzahlendefinitionen aus Rohtabellen und Abfrageprotokollen generiert. Es lieferte plausible Definitionen, die genau die Unklarheiten kodierten, die wir beseitigen wollten, und war bei unseren Bewertungen im Vergleich zu einer kleineren, von Menschen kuratierten Ebene netto-negativ. Daher empfehlen wir, die Dokumentation mit Claude zu erstellen, aber die Definition einem Menschen zu überlassen.
- Lineage und Transformationsgraph: Wenn die semantische Ebene eine Frage nicht abdeckt, ermöglichen die Lineage und das Tabellenranking (basierend auf der Anzahl der Referenzen) dem Agenten zu entscheiden, welche vorgelagerten Modelle ein Konzept speisen, welche veraltet sind und welche die gleiche Granularität aufweisen. Dadurch wird aus „Ich kenne die Kennzahl nicht“ ein „Ich weiß, aus welchem Governance-Modell ich aggregieren soll.“ Sie bildet zudem das Rückgrat der Frische- und Provenienzsignale, die wir unten in der Online-Validierung ermitteln.
- Abfragekorpus: historisches SQL aus Dashboards, Notebooks und früheren Analysen. Intuitiv sollte dies ein hoher Wert sein: Es handelt sich um eine Aufzeichnung aller Fragen, die bereits richtig beantwortet wurden. In der Praxis haben wir festgestellt, dass die Genauigkeit um weniger als einen Prozentpunkt erhöht wird, wenn der Agent den Zugriff auf Tausende früherer Abfragen erhält (auf diese Ablation gehen wir in einem späteren Abschnitt weiter unten ein). Ein unstrukturierter Abruf konnte eine neue Frage nicht dem richtigen Präzedenzfall zuordnen. Was funktioniert, ist die Destillation dieses Korpus in strukturierte, domänenbezogene Referenzdokumente und wiederverwendbare Analysemuster, die unter Skills beschrieben werden. Sehen Sie den Abfrageverlauf als Rohmaterial für die Kuratierung und nicht als verlässliche Quelle, die der Agent direkt liest.
- Geschäftlicher Kontext: die Ebene, die die meisten Teams überspringen und die wir am längsten unterschätzt haben. Ein Agent, der Ihr Unternehmen nicht versteht, wird die Frage des Nutzers beantworten, ohne zu wissen, was dahintersteckt. Er kann dann nicht wissen, dass sich die „Einführung im zweiten Quartal“ auf ein bestimmtes Produkt bezieht, dass zwei Teams denselben Begriff unterschiedlich definieren oder dass die Frage gestellt wird, weil am Donnerstag eine Sitzung des Vorstands stattfindet. Wir erstellen einen Wissensgraph aus indizierten Dokumenten, Roadmaps, Entscheidungsprotokollen und unserer Organisationsstruktur, damit der Agent mit Ambiguitäten umgehen und Fragen zur Klärung stellen kann.
Bei allen vieren liegt es an der Datengrundlage: schlechte oder veraltete Dokumentation. Claude ist außergewöhnlich gut im Schließen von Lücken (Erstellung von Spaltenbeschreibungen, Vorschläge für Kennzahlen aus Abfragemustern, Markierung nicht dokumentierter Modelle in CI), aber die Kuratierung und die Verantwortung liegen in der Hand von Menschen.
In den nächsten beiden Abschnitten besprechen wir, wie sich die Inhaberschaft so genug gestalten lässt, dass sie tatsächlich genutzt werden kann.
Skills
Wenn die Sources of Truth das deklarative Wissen des Agenten sind (d. h. zu wissen, was eine Kennzahl bedeutet), dann ist ein Skill dessen verfahrenstechnisches Wissen: welche Quellen in welcher Reihenfolge konsultiert werden sollen, wie durch mehrdeutige Daten zu navigieren ist und wie eine fertige Analyse auszusehen hat.
In Claude Code ist ein Skill ein Ordner mit Markdowns, den der Agent auf Anfrage liest. Bei Anthropic bringen die Skills, die wir entwickelt haben, einen enormen Mehrwert. Ohne Skills lag bei unseren Tests Claudes Fähigkeit zur genauen Beantwortung von Analysefragen bei nur 21 %. Seit Hinzufügen von Skills liegt dieser Wert konstant bei über 95 % und in bestimmten Bereichen regelmäßig bei 99 %. Im Anhang finden Sie ein Skelett, das wir für die Entwicklung der meisten unserer Skills verwenden.
Einige Best Practices:
Erstellen Sie paarweise Skills: Ein Wissensskill fungiert als flacher Router der obersten Ebene, mit dem zusätzliche Domänendetails nach Bedarf geladen werden können. Es heißt: „Versuch es zuerst mit der semantischen Ebene, aber wenn du da keine Abdeckung findest, findest du hier ca. 30 Referenzdateien für diese Domäne, die die relevanten Tabellen, Spalten, Joins und Gotchas beschreiben.“ Dieser Router ist praktisch unsere Antwort auf fehlgeschlagene Abrufdaten: Anstatt den Agenten in einem Warehouse mit Millionen von Feldern suchen zu lassen, wird damit der Bereich auf ein paar Dutzend kuratierte Dateien beschränkt, bevor überhaupt eine Abfrage geschrieben wird. Der Runbook-Skill beschreibt den Prozess, den ein Senior-Analyst verfolgen würde: Er klärt die Frage, sucht Quellen (über den Wissensskill), führt die Abfrage aus und leitet das Ergebnis dann durch Subagenten zur kontradiktorischen Überprüfung durch. Außerdem werden ein Dutzend wiederverwendbare Analysemuster gebündelt (Kundenbindungskurven, Ratenaufschlüsselung, Trichteranalyse), damit gängige Anfragen nicht jedes Mal neu erfunden werden müssen.
Erstellen Sie geeignete Referenzdokumente: für den Abruf durch ein LLM geschrieben. Unsere Referenzdokumente beschreiben Tabellen (Granulat, Umfang und Ausschlüsse), die Mechanismen von gotchas (z. B. „bekannte kostenlose E-Mail-Domains ausschließen, aber benutzerdefinierte wie anthropic.com beibehalten“) und explizite Routing-Trigger (z. B. „WENN die Frage nach der Durchführung des Experiments betrifft … NICHT für die rohe Ereignisanzahl verwenden“) ohne vorgeschriebene Rezepte, die veraltet sind. Unten finden Sie ein Skelett, das wir zur Erstellung von Referenzdokumenten verwenden.
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]
Sehen Sie die Wartung von Skills als oberste Priorität an: Skill-Dokumente beschreiben ein Datenmodell, das sich täglich ändert, sodass sie ohne aktive Wartung innerhalb von Wochen fehlerhaft sind. Wir haben beobachtet, wie unsere Offline-Genauigkeit innerhalb eines Monats von ~95 % bei der Einführung auf ~65 % gefallen ist, bevor wir es als technisches Problem erkannt haben. Das bedeutete, dass wir die Skill-Markdown-Dateien im selben Repository wie unsere Transformationsmodelle platzieren, sodass der PR, der ein Modell ändert, derselbe PR ist, der auch das Dokument aktualisiert, das es beschreibt. Ein Hook für die Codeprüfung markiert alle Änderungen am Berichtsmodell, die keine Skilldatei betreffen. Etwa 90 % unserer Datenmodell-PRs beinhalten jetzt eine Skilländerung in derselben Größenordnung. Wir beschneiden außerdem regelmäßig das Skill-Scaffolding, da sich die Modelle verbessern und frühere Fehlermodi nicht mehr gelten.
Schaffen Sie eine konsistente und nahtlose Oberfläche auf allen Plattformen: Ein und derselbe Skill muss in Slack, in der IDE, in einem Dashboard-Tool und in eigenständigen Agentensitzungen dieselbe Antwort auf Fragen liefern. Wir haben dies erreicht, indem wir eine kanonische Quelle (das Daten-Repo) sichergestellt und Änderungen an den Skills automatisch synchronisiert werden. Beim Merge wird der Skill in einen Plugin Marketplace (für IDE-Nutzer) und in Cloud-Storage-Blobs (für gehostete Apps, die eine einzelne Datei lesen) synchronisiert sowie direkt über MCP als Ressourcen bereitgestellt. Wir haben außerdem von Anfang an die Portabilität berücksichtigt, indem wir fest codierte Repo-Pfade und oberflächenspezifische Namespaces vermeiden.
Validierung
Schließlich besteht die Validierung darin, herauszufinden, welcher der drei Fehlermodi sich noch bemerkbar macht.
Offline-Evaluierungen
Ein häufiges Muster, das wir sehen, ist, dass Datenteams komplexe Analyseumgebungen einrichten, ohne über einen Prozess zur Ermittlung der Genauigkeit ihrer Analyseagenten zu verfügen.
Eine Möglichkeit, diese Lücke zu schließen, sind Offline-Evaluierungen als einfache Frage/Antwort-Paare. Offline-Evaluierungen ähneln den Offline-Tests für ein ML-Modell, da auch sie Ihnen keine Auskunft über die Leistung Ihrer Online-Agenten geben, Ihnen aber ein gutes Gespür dafür geben, ob Sie kritische Lücken haben.
Bei Anthropic setzen wir zwei Arten von Offline-Evaluierungen ein. Dashboard-basierte Evaluierungen werden von Claude automatisch generiert (und dann von einem Menschen validiert) und decken die häufigsten Fragen von Beteiligten ab. Bei Long-Tail-Evaluierungen geben wir Claude geschäftlichen Kontext (Roadmaps, Tabellendokumente) und lassen es plausible Fragen für den Rest der Domäne generieren. Zudem erfassen wir fortlaufend jeden Zeitpunkt, in dem ein Beteiligter den Agenten in einem Thread korrigiert, da diese Korrektur eine potenzielle Bewertung darstellt.
Weitere Best Practices sind:
- Verankern Sie die Ground Truth, damit sie nicht abweichen kann: Eine Evaluierung, die anhand von Live-Daten erfolgt, ist veraltet, sobald sich die zugrunde liegende Zahl ändert. Binden Sie jede Evaluierung an ein Snapshot-Datum, schreiben Sie sie anhand einer stabilen Faktentabelle, oder lassen Sie den Bewerter die Anfrage des Agenten statt der Zahl beurteilen. Verknüpfen Sie die Suite mit CI, damit ein PR, der eine Abhängigkeit betrifft, die betroffenen Evaluierungen erneut durchführt.
- Speichern Sie Ergebnisse als Telemetrie, nicht als Testprotokoll: Jede Ausführung landet in einer Warehouse-Tabelle mit der Skill-Version, Git SHA, Modell-ID, Bestehen/Fehlschlagen pro Assertion, Tokenanzahl und Wall-Clock-Zeit. „Hat diese Änderung geholfen?“ wird zu einer Abfrage, und Sie erhalten die Zeitreihen zur Erkennung langsamer Regressionen, die mit einer einzelnen CI-Ausführung nicht erkannt werden können.
- Gate startet pro Domain: Ein Domaininhaber kann seinen Beteiligten den Agenten erst dann vorstellen, wenn sein Anteil an der Evaluierung einen bestimmten Schwellenwert erreicht hat (wir haben anfangs ~90 % verwendet). Es erzwingt Korrekturen in der Referenzdokumentation, bevor die Benutzer die Fehler sehen.
- Erstellen Sie die richtige Anzahl an Evaluierungen: Die Anzahl an Evaluierungen, die Sie durchführen sollten, hängt von der Komplexität des Geschäftsbereichs und der Komplexität des zugrunde liegenden Datenmodells ab. Kalibrieren Sie, indem Sie nachverfolgen, wie gut die Offline-Genauigkeit die Online-Genauigkeit vorhersagt: Wir haben festgestellt, dass die Renditen ab einigen Dutzend pro Thema (z. B. „Wachstum“) abnehmen, und diese Obergrenze mit jeder neuen Modellgeneration sinkt.
- Die Genauigkeit der Offline-Evaluierung sollte bei ~100 % liegen. Jede richtige Antwort sollte auch Ihre semantische Ebene treffen (falls vorhanden). Auch hier bedeutet diese Genauigkeit nicht, dass Ihr System keine falschen Antworten liefert, sondern nur, dass es keine offensichtlichen Lücken gibt, sofern Sie über eine angemessene Bewertungsabdeckung verfügen.
Ablationstechniken
Jede strukturelle Entscheidung über den Skill (z. B. welche Quellen offengelegt werden sollen, ob ein Subagent seine Latenz verdient, ob zwei Skills zu einem zusammengeführt werden sollen) wird getroffen, indem unser Offline-Evaluierungssatz unverändert bleibt.
Wir ändern genau eine Komponente ab und vergleichen die Erfolgsquoten. Jeder Durchlauf dauert nur eine Stunde und ersetzt viele Argumente. Die Methodik ist wichtiger als jedes einzelne Ergebnis:
- Planen Sie für Null-Ergebnisse. Unsere nützlichste Ablation war eine negative. Wir haben dem Agenten direkten grep-Zugriff auf unser gesamtes Dashboard-, Transformations- und Analyst-Notebook-SQL (Tausende von Dateien) gegeben. Wir haben dann in den Transkripten überprüft, ob er sie vor jeder Antwort tatsächlich gelesen hat. Die Genauigkeit hat sich in keine Richtung um mehr als einen Punkt verschoben. Wir haben dann die offensichtlichen Störfaktoren überprüft: Befand sich die Antwort tatsächlich im Korpus für die Fragen, die er falsch beantwortet hatte? In etwa 80 % der Fälle, ja. Hat „Antwort vorhanden“ vorhergesagt, „jetzt geht es richtig“? Nein, die Flip-Rate war stabil. Die Informationen waren da, der Agent hat sie gesehen und hat sie trotzdem nicht genutzt. Dieses einzelne Experiment zeigte uns, dass unser Engpass nicht der Zugriff auf frühere Arbeiten war, sondern die Struktur (d. h. die Zuordnung einer Frage zur richtigen Entität). Diese Erkenntnis hat die monatelange Roadmap neu beeinflusst.
- Tragen Sie bei der PR-Granularität etwas ab. Jede aussagekräftige Bearbeitung eines Skills erhält eine Vorher-/Nachher-Evaluierung im relevanten Bewertungsbereich, wobei das Delta in der PR-Beschreibung angegeben wird. Es bleibt bei der Aussage „Ich habe die Dokumentation verbessert“ und erfasst den überraschend häufigen Fall, in dem eine gut gemeinte Ergänzung die Situation verschlimmert.
- Erstellen Sie eine kurze Liste mit allen Fehlern. Zwei von uns: die Durchführung zusätzlicher Runden der Dokumentenverfeinerung ab einem bestimmten Punkt (wir hatten drei negativ ausgefallene Iterationen in Folge: die Dokumente wurden länger, nicht besser) und der Austausch des gegensätzlichen Prüfers gegen ein günstigeres Modell, um die Latenz zu reduzieren (es hat die meisten Genauigkeitsgewinne verloren, ohne dass es eine echte Beschleunigung gibt). Negative Ergebnisse sind günstig zu erfassen und verhindern, dass die nächste Person dasselbe Experiment erneut durchführt.
Online-Validierung
Der letzte Schritt besteht darin, sicherzustellen, dass die tatsächliche Online-Systemleistung so genau wie möglich ist. Einige der Schritte, die wir unternehmen, sind:
- Adversariale Überprüfung: Wir haben festgestellt, dass der Einsatz eines Claude-Skills, um alle zugrunde liegenden Annahmen hinsichtlich einer potenziellen endgültigen Antwort aggressiv zu hinterfragen, die Genauigkeit innerhalb unserer Prüfungen um 6 % erhöhte, was jedoch auf Kosten von 32 % mehr Tokens und 72 % höherer Latenz geschah.
- Fußzeile mit der Herkunft: Jede Antwort enthält eine Fußzeile, die angibt, aus welcher Quellenebene die Antwort stammt (semantische Ebene › kuratierte Referenz › Rohtabelle), wie aktuell die zugrunde liegenden Daten sind und wer der Inhaber des Modells ist. Dadurch wird zwar die Antwort nicht richtiger, aber es hilft dem Verbraucher einzuschätzen, wie sehr er der Antwort vertrauen kann. Eine Fußzeile mit dem Stichwort „Rohtabelle, Frische unbekannt“ ist ein Signal, das vor der Weiterleitung eine Überprüfung erfolgen sollte, und ist eine der wenigen Risikominderungen, die wir für stille Fehler haben.
- Prüfung der Datenqualität: Es kann sein, dass Ihr Agent das richtige Feld korrekt verwendet, die Daten selbst jedoch falsch sind. Ein gute Möglichkeit zur Bereinigung ist die grundlegende Überprüfung der Datenqualität, um sicherzustellen, dass das referenzierte Feld aktuell, vollständig und frei von Anomalien ist.
- Passive Überwachung: Zwei Produktionssignale, die wir kontinuierlich verfolgen, sind der Anteil der Agentenanfragen, die über die semantische Ebene gelöst werden, und der Anteil der Antworten, die eine Korrektursprache verwenden („das ist die falsche Tabelle“, „Ihnen fehlt der Betrugsfilter“). Beide speisen ein Dashboard ein, das wöchentlich neben der Offline-Erfolgsrate überprüft wird.
- Aktive Korrekturerfassung: der Teil, der den Kreislauf schließt. Ein zeitgesteuerter Agent durchsucht alle paar Stunden die Kanäle der Beteiligten nach ähnlichen Korrekturformulierungen, entwirft eine einzeilige Korrektur für das relevante Referenzdokument und öffnet einen PR, der dem Inhaber der Domain zugeteilt ist. Der Korrekturweg ist absichtlich langweilig – Markdown-Datei bearbeiten, zusammenführen, überall automatisch synchronisieren –, damit der Inhaber der Domain nicht zu viel Zeit mit der Aufgabe verbringt. Dieselben Korrekturen fließen in die Offline-Evaluierungen ein.
Der Fehlermodus, den keiner dieser Punkte vollständig abdeckt, ist der stille Fehlermodus. Die Antwort ist falsch, sieht aber plausibel aus und wird ohne Einwände verwendet. Unsere Risikominimierungen sind die Fußzeile mit der Herkunft, die explizite menschliche Genehmigung für alle an die Führungsrolle gebundenen Aspekte und eine ständige Evaluierung der Top-KPIs der jeweiligen Branche, die täglich mit dem Dashboard abgeglichen wird, obwohl wir noch keine robuste Lösung haben.
Erste Schritte mit Self-Service-Analysen
Wenn Sie bei Null anfangen, werden eine Handvoll kanonischer Datensätze, ein paar Dutzend Offline-Evaluierungen und ein geringer Wissensstand den größten Teil des Vorteils erfassen. Alles andere in diesem Beitrag ist das, was wir hinzugefügt haben, nachdem diese erstellt wurden.
Zudem haben wir viele Best Practices vorgestellt, die nicht alle für jedes Datenteam geeignet sind. Sie sollten sich mit Ihrem Unternehmen auf einige Prinzipien einigen, die sich auf Ihren Ansatz auswirken, indem Sie folgende Fragen stellen:
- Wie wichtig ist eine richtige Antwort heute im Vergleich zu morgen? KI-Modelle entwickeln sich rasant. Wir sehen oft, dass Unternehmen eine beträchtliche Menge an Infrastruktur aufbauen, um die Defizite ihrer aktuellen Modelle zu beheben, die dann fragwürdig werden, sobald sich die Modelle verbessert haben. Zu wissen, wo die Modelle Mängel aufweisen, und auf Modellverbesserungen zu warten, um die Lücke zu schließen, bedeutet deutlich weniger Aufwand, passt aber möglicherweise nicht zur Risikotoleranz Ihres Unternehmens.
- Wie wird sich die Komplexität Ihres Unternehmens im Laufe der Zeit verändern? Einige der Prozesse, die wir besprochen haben, sind möglicherweise übertrieben, wenn Sie beispielsweise nicht viele Daten generieren, nur wenige Nutzer der Ergebnisse haben oder Ihr Datenmodell wahrscheinlich einfach bleibt.
- Wie technisch ist die Zielgruppe der Ausgabe? Anders ausgedrückt: Wenn Sie dieses Analysesystem für Data Scientists entwickeln, die erkennen können, wenn eine Antwort falsch ist, sind Sie möglicherweise toleranter gegenüber Fehlern im Vergleich zu einer Situation, in der die Zielgruppe mit dem zugrunde liegenden Datenmodell nicht vertraut ist.
- Wie viel darf eine verbesserte Genauigkeit kosten? Wir haben festgestellt, dass bestimmte Prozesse wie die kontroversale Validierung die Genauigkeit erheblich verbessern können, jedoch oft mit höheren Kosten und Latenz verbunden sind.
- Wie sicher sind Sie mit Zugriffskontrollen und interner Datensicherheit? Agenten sind oft wesentlich leistungsfähiger, je mehr Kontext sie haben. Ein breiter Datenzugriff steht jedoch dem Governance-Ansatz der meisten Unternehmen entgegen. Diese Faktoren entscheiden darüber, ob Sie einen Agenten oder viele Agenten für den Anwendungsbereich entwickeln.
Unabhängig von Ihrem Weg haben wir unsere größten Vorteile durch die Bewältigung der drei Fehlermodi erzielt: die Zweideutigkeit in eine einzige Antwort zusammenfassen, die Antwort leicht auffindbar machen und die Fehlermeldung markieren, wenn eine der beiden Fehlermodi veraltet ist.
Dieser Artikel wurde von Chen Chang, Clement Peng, Justin Leder, Johanne Jiao und Josh Cherry, Mitgliedern des Data Science and Data Engineering-Teams, verfasst. Die Autoren möchten Michael Segner für seine Beiträge danken.
Anhang
Skill-Dateiskeleton
Im Folgenden finden Sie das Skeleton unseres wichtigsten Warehouse-Skills: die Struktur der echten Datei, wobei die internen Daten durch [Platzhalter in Klammern] ersetzt werden. Sie soll nicht wörtlich kopiert werden. Sie zeigt die Art von Abschnitten, die wir für aufschreibenswert befunden haben.
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]