Der Automodus ist jetzt Standard in Claude Code für die Pläne Pro, Max und Team
Claude Code läuft für die Pläne Pro, Max und Team bald standardmäßig im Automodus, wodurch zeitintensive autonome Arbeiten möglich und in unseren Tests mehr gefährliche Befehle abgefangen werden als bei einer manuellen Überprüfung.
Update, 22. Oktober 2026: Der Automodus wird nächste Woche als Standard für neue Sitzungen in den meisten Claude-Apps in den Plänen Pro, Max und Team eingeführt. Anstatt Sie bei jeder Aktion um Genehmigung zu bitten, werden diese durch eine automatisierte Kontrolle geprüft: Sichere Aktionen werden ausgeführt und riskante blockiert, während Claude nach einem anderen Weg sucht. Enterprise-Admins erhalten eine E-Mail, bevor der Automodus zum Standard für ihre Organisationen wird.
Bevor wir den Automodus in Claude Code zum Standardmodus gemacht haben, haben wir ihn intern und mit Red-Teaming von Drittanbietern getestet. Anhand der Ergebnisse konnten wir die Funktionsweise des Automodus in all unseren Produkten verbessern. Die Daten in dem nachfolgenden Artikel beziehen sich speziell auf Claude Code.
Wir machen den Automodus in Claude Code zum Standard. Ab dem 14. August werden neue Sitzungen in den Plänen Pro, Max und Team im Automodus ausgeführt. Wenn Sie bereits selbst einen anderen Standard festgelegt haben, werden Sie möglicherweise einmalig in einem Prompt gefragt, ob Sie in den Automodus wechseln möchten. Wenn Sie einen fixierten Standard haben, ändert sich nichts für Sie. Der Klassifikator im Automodus verbraucht pro Toolaufruf eine kleine Anzahl zusätzlicher Tokens, und ab heute berechnen wir Nutzern von Claude Code mit den Plänen Pro, Max und Team diesen zusätzlichen Aufwand für den Klassifikator nicht mehr.
Der Automodus bleibt für Claude Enterprise, die Claude API, die Claude Platform on AWS, Amazon Bedrock, die Agent Platform von Google Cloud und Microsoft Foundry vorerst noch eine freiwillige Option, sodass Administratoren Zeit haben, die Änderung zu überprüfen. Im kommenden Monat planen wir in Zusammenarbeit mit unseren Cloud-Partnern, ihn auf all diesen Plattformen zum Standard zu machen und den Aufwand für den Klassifikator nicht mehr zu berechnen. In der Zwischenzeit können Enterprise-Administratoren den Automodus von Claude Code über verwaltete Einstellungen als Standard festlegen.
Der Automodus soll den Wunsch der Nutzer, nicht unterbrochen zu werden, mit einem System in Einklang bringen, das hilft, schädliche Aktionen zu vermeiden: Statt Prompts leitet er jeden Toolaufruf durch einen Klassifikator, der darauf ausgelegt ist, Aktionen zu blockieren, die irreversibel oder destruktiv sind oder auf Ziele außerhalb Ihrer Umgebung abzielen. Wenn der Klassifikator etwas blockiert, findet Claude in der Regel selbstständig einen sichereren Weg oder bittet Sie direkt um grünes Licht. Kommt Claude nicht voran – drei Blockierungen in Folge oder zwanzig in einer Sitzung –, wechselt Claude Code zurück zu manuellen Genehmigungen.
In den letzten Monaten haben wir getestet, ob der Automodus genauso sicher oder sicherer ist als der durchschnittliche Nutzer, der sich durch Prompts klickt. Wir haben internes Red-Teaming, Red-Teaming- sowie Prompt-Injection-Evaluierungen durch Dritte, eine kontrollierte Studie mit 1.053 bezahlten Testern sowie Analysen echter Produktionssitzungen durchgeführt. Bei jeder von uns getesteten Kennzahl war der Automodus genauso gut wie die manuelle Bewertung oder ihr überlegen.
Im Automodus kann Claude auch über längere Zeitabschnitte autonom arbeiten. Dadurch wird es praktikabler, Modelle für zeitintensive Aufgaben wie Claude Opus 5 stundenlang an großen Aufgaben arbeiten zu lassen. Weniger Aufwand für Nutzer steigert zudem die Produktivität. Unter den Anwendern von Teams und Enterprise liefern Nutzer des Automodus etwa 25 % mehr PRs aus. Wenn Sie Claude entsperren, können Aufgaben länger ohne Unterbrechung ausgeführt und mehr Arbeiten erledigt werden. Teams bei Adobe, Nuro, Gusto und Garner Health lassen bereits den Automodus als Standard in der Produktion laufen.
Nachfolgend stellen wir die Sicherheitsdaten und Kundenergebnisse vor, die diese Änderung begründen, sowie Informationen dazu, wie Sie einen anderen Standardwert festlegen können, wenn Sie dies wünschen.
Vergleich der manuellen Überprüfung mit dem Automodus
Die Daten deuten darauf hin, dass die manuelle Überprüfung zur Gewohnheit werden kann: Die Nutzer genehmigen 97 % der Genehmigungsprompts in Claude Code. Obwohl sich die meisten Prompts wahrscheinlich auf sichere Routinebefehle beziehen, deutet eine so hohe Genehmigungsrate darauf hin, dass viele Nutzer sich reflexartig durchklicken, anstatt jeden einzelnen Befehl einzeln zu überprüfen. Diese Prompts verlangen von Entwicklern, täglich Dutzende oder Hunderte wichtiger sicherheitsbezogener Entscheidungen zu treffen – oft inmitten von Projekten. Dadurch liegt die Last der Überprüfung bei den Nutzern, und die Wahrscheinlichkeit steigt, dass etwas Wichtiges übersehen wird. Die Daten legen außerdem nahe, dass Nutzer andere Arten von Dialogen häufiger prüfen und ablehnen: Wenn Claude beispielsweise einen Plan zur Genehmigung vorlegt, lehnen die Nutzer 39 % davon ab. Bei einzelnen Genehmigungsanfragen beträgt die Ablehnungsrate jedoch nur 3 %.
Dasselbe Muster zeigt sich in Einstellungsdateien. Stand Juni 2026 haben 49,5 % der aktiven CLI-Nutzer manuell eine Bash-Zulassungsregel erstellt – 5 % erlauben ohne Weiteres jeden Shell-Befehl, und weitere 43 % haben Interpreter-Regeln wie Bash(python:*) oder Bash(node:*), die in der Praxis im Wesentlichen gleichwertig sind – und dieser Anteil wächst alle fünf Wochen um etwa fünf Prozentpunkte. Über die Zulassungsregeln hinaus haben 62 % der Nutzer bypassPermissions verwendet oder bei Bash auf „Nicht erneut fragen“ geklickt, und 25 % der interaktiven Sitzungen beginnen im Modus zum Umgehen von Genehmigungen.
Im Automodus greifen Genehmigungsregeln weiterhin vor dem Klassifizierungssystem, außer bei Zulassungsregeln, die so weit gefasst sind, dass sie die Ausführung beliebigen Codes ermöglichen (z. B. python:*). Diese willkürlichen Regeln werden im Automodus ausgesetzt, da Befehle sonst das Klassifizierungssystem vollständig umgehen könnten. Einstellungsdateien werden nicht geändert, und die Regeln gelten erneut, sobald Sie in einen anderen Modus wechseln.
Verbesserung der Sicherheit mit dem Automodus
Interne Untersuchungen sowie Untersuchungen mehrerer Drittparteien deuten darauf hin, dass der Automodus sicherer ist als der heutige Umgang eines typischen Nutzers mit Genehmigungsprompts. Wir haben den Automodus anhand dessen getestet, was Entwickler tatsächlich genehmigen, wenn sie sich durch Genehmigungsprompts klicken. Bei jeder dieser Untersuchungen – internes Red-Teaming, Penetrationstests durch Drittanbieter und Analyse realer Sitzungen – war der Automodus der menschlichen Bewertung ebenbürtig oder überlegen.
Der Automodus ist sicherer manuelle Genehmigungen
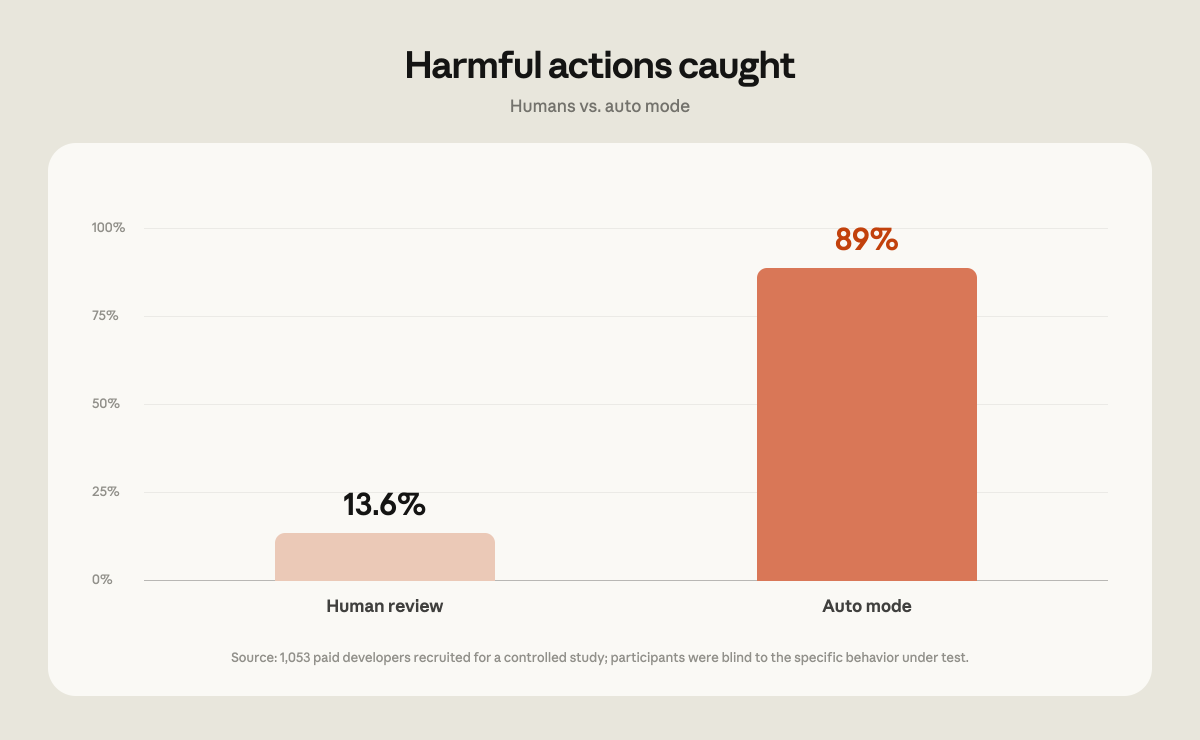
Wir haben über ein Marktforschungsinstitut 1.053 bezahlte Tester für eine Programmierstudie eingestellt. Diese Teilnehmer haben in einer Testumgebung gearbeitet, die speziell für die Studie eingerichtet wurde, nicht in ihren eigenen Codebasen oder an echten Projekten. Die Teilnehmer wussten, dass sie bewertet wurden, aber gemäß dem standardmäßigen Blindstudiendesign wurde ihnen nicht gesagt, welches Verhalten gemessen wurde. Im Verlauf jeder Sitzung wurde ein einzelner Genehmigungsprompt gegen einen eindeutig gefährlichen Befehl ausgetauscht, und der Anbieter zeichnete auf, ob der Tester ihn genehmigt hatte (Hinweis: Die Genehmigung des Prompts führte nie dazu, dass etwas Gefährliches ausgeführt wurde, nur der Text des Prompts, den die Tester sahen, wurde geändert).
Die Tester haben den gefährlichen Befehl nur in 13,6 % der Fälle (143 von 1.053) erkannt, während der Automodus 89 % derselben Befehle blockierte (937 von 1.053). Im direkten Vergleich blockierte der Automodus 800 Befehle, die von einem Menschen genehmigt wurden, während der Mensch nur 6 Befehle blockierte, die im Automodus erlaubt waren. Je länger die Sitzungen dauerten, desto schlechter schnitten Menschen ab: Zu Beginn einer Sitzung blockierten sie etwa 17 % der gefährlichen Befehle, nach 50 oder mehr vorherigen Prompts nur noch etwa 5 %, während die Blockierrate des Automodus unabhängig von der Sitzungsdauer konstant blieb.
Der Automodus verhindert schädliche Aktionen wirksamer
Unsere Untersuchungen legen außerdem nahe, dass der Automodus zu weniger schädlichen Aktionen führt als der manuelle Genehmigungsmodus.
Wir haben untersucht, wie sich der Automodus in der realen Nutzung verhält. Von Mai bis Juni 2026 haben wir Sitzungen untersucht, die unsere Sicherheitspipeline zur Überprüfung markiert hatte und die ausschließlich von Konten stammten, die der Datennutzung für Training und Analysen zugestimmt hatten. Wir haben jede einzelne davon mit einem Modell auf zwei Skalen von 0 bis 10 neu bewertet. Die erste betraf den Schweregrad des Schadens: 10 stand für unternehmensweite, irreversible Schäden wie etwa die Offenlegung des gesamten Quellcodes eines Unternehmens, 7 für einen Schweregrad auf Produktionsebene wie etwa das Löschen von Zeilen aus einer Produktionsdatenbank und 0 für eine vollständig reversible Aktion, die auf den lokalen Arbeitsbereich beschränkt ist, wie etwa das Überschreiben einer temporären Datei. Die zweite betraf den Grad, in dem der Nutzer explizit die Aktion angefordert hatte, sodass wir schädliche Aktionen, die der Nutzer direkt angefordert hatte, von schädlichen Aktionen trennen konnten, die der Agent mit weniger expliziten Anweisungen ausführte.
Unter den markierten Sitzungen enthielten diejenigen, die eine manuelle Genehmigung durchliefen, mehr als doppelt so oft schwerwiegende unbeabsichtigte negative Auswirkungen wie Sitzungen im Automodus. Beim Schweregrad auf Produktionsebene (7+) enthielten 6,3 % der manuell genehmigten Sitzungen schädliche Aktionen, die der Nutzer nicht explizit angefordert hatte, verglichen mit 2,4 % bei Sitzungen im Automodus, und dieser Unterschied zeigte sich bei jedem getesteten Schweregrad.
Durch adversarielles Red-Teaming wurde der Automodus leistungsfähiger
Wir haben mit Apollo Research, einem britischen Startup für KI-Sicherheit, an einem zweiwöchigen Pilotprojekt gearbeitet, bei dem synthetische Angriffe in echte Coding-Trajektorien eingespeist wurden. Dabei wurden drei Datensätze verwendet, die allgemeine Fehler, Datenexfiltration und sicherheitsbezogene Bedrohungen abdecken.
Die Zusammenarbeit folgte einem standardmäßigen Zyklus aus Finden, Beheben und Verifizieren. Apollo stellte uns eine Reihe erfolgreicher Angriffe sowie Empfehlungen zur Stärkung des Automodus zur Verfügung. Wir haben den Klassifikator gegen sie gehärtet, hauptsächlich indem wir ihm mehr Kontext über die Umgebung gegeben haben, die er schützt (Repository-Sichtbarkeit, Git-Status und die unten beschriebenen Regeln zur Datenverarbeitung).
Nach der Härtung testete Apollo erneut mit einem separaten, zurückgehaltenen Angriffsdatensatz, auf den wir nie Zugriff hatten. Der Automodus erkannte etwa die Hälfte der Angriffe, die er zuvor übersehen hatte, wobei etwa 2 % der zuvor erkannten Angriffe nun übersehen wurden. Da wir den Klassifikator nicht auf den zurückgehaltenen Satz abstimmen konnten, deutet dies darauf hin, dass die Härtung auf neue Angriffe generalisiert, anstatt nur die spezifischen Angriffe zu patchen, die von Apollo geteilt wurden. Sowohl bei den bereitgestellten als auch bei den zurückgehaltenen Sätzen ist die Fehlerrate des Klassifikators von 12 % auf 7 % gesunken.
Diese Angriffe sind bewusst synthetisch und adversariell gestaltet, um herauszufinden, wo der Klassifikator versagt, und sind bösartiger als alles, was Claude von sich aus tun würde. Die Fehlerrate von 7 % wird an diesem Satz gemessen und sollte nicht als Fehlerrate für echten Datenverkehr angesehen werden.
Der Automodus reduziert das Risiko von Prompt-Injection
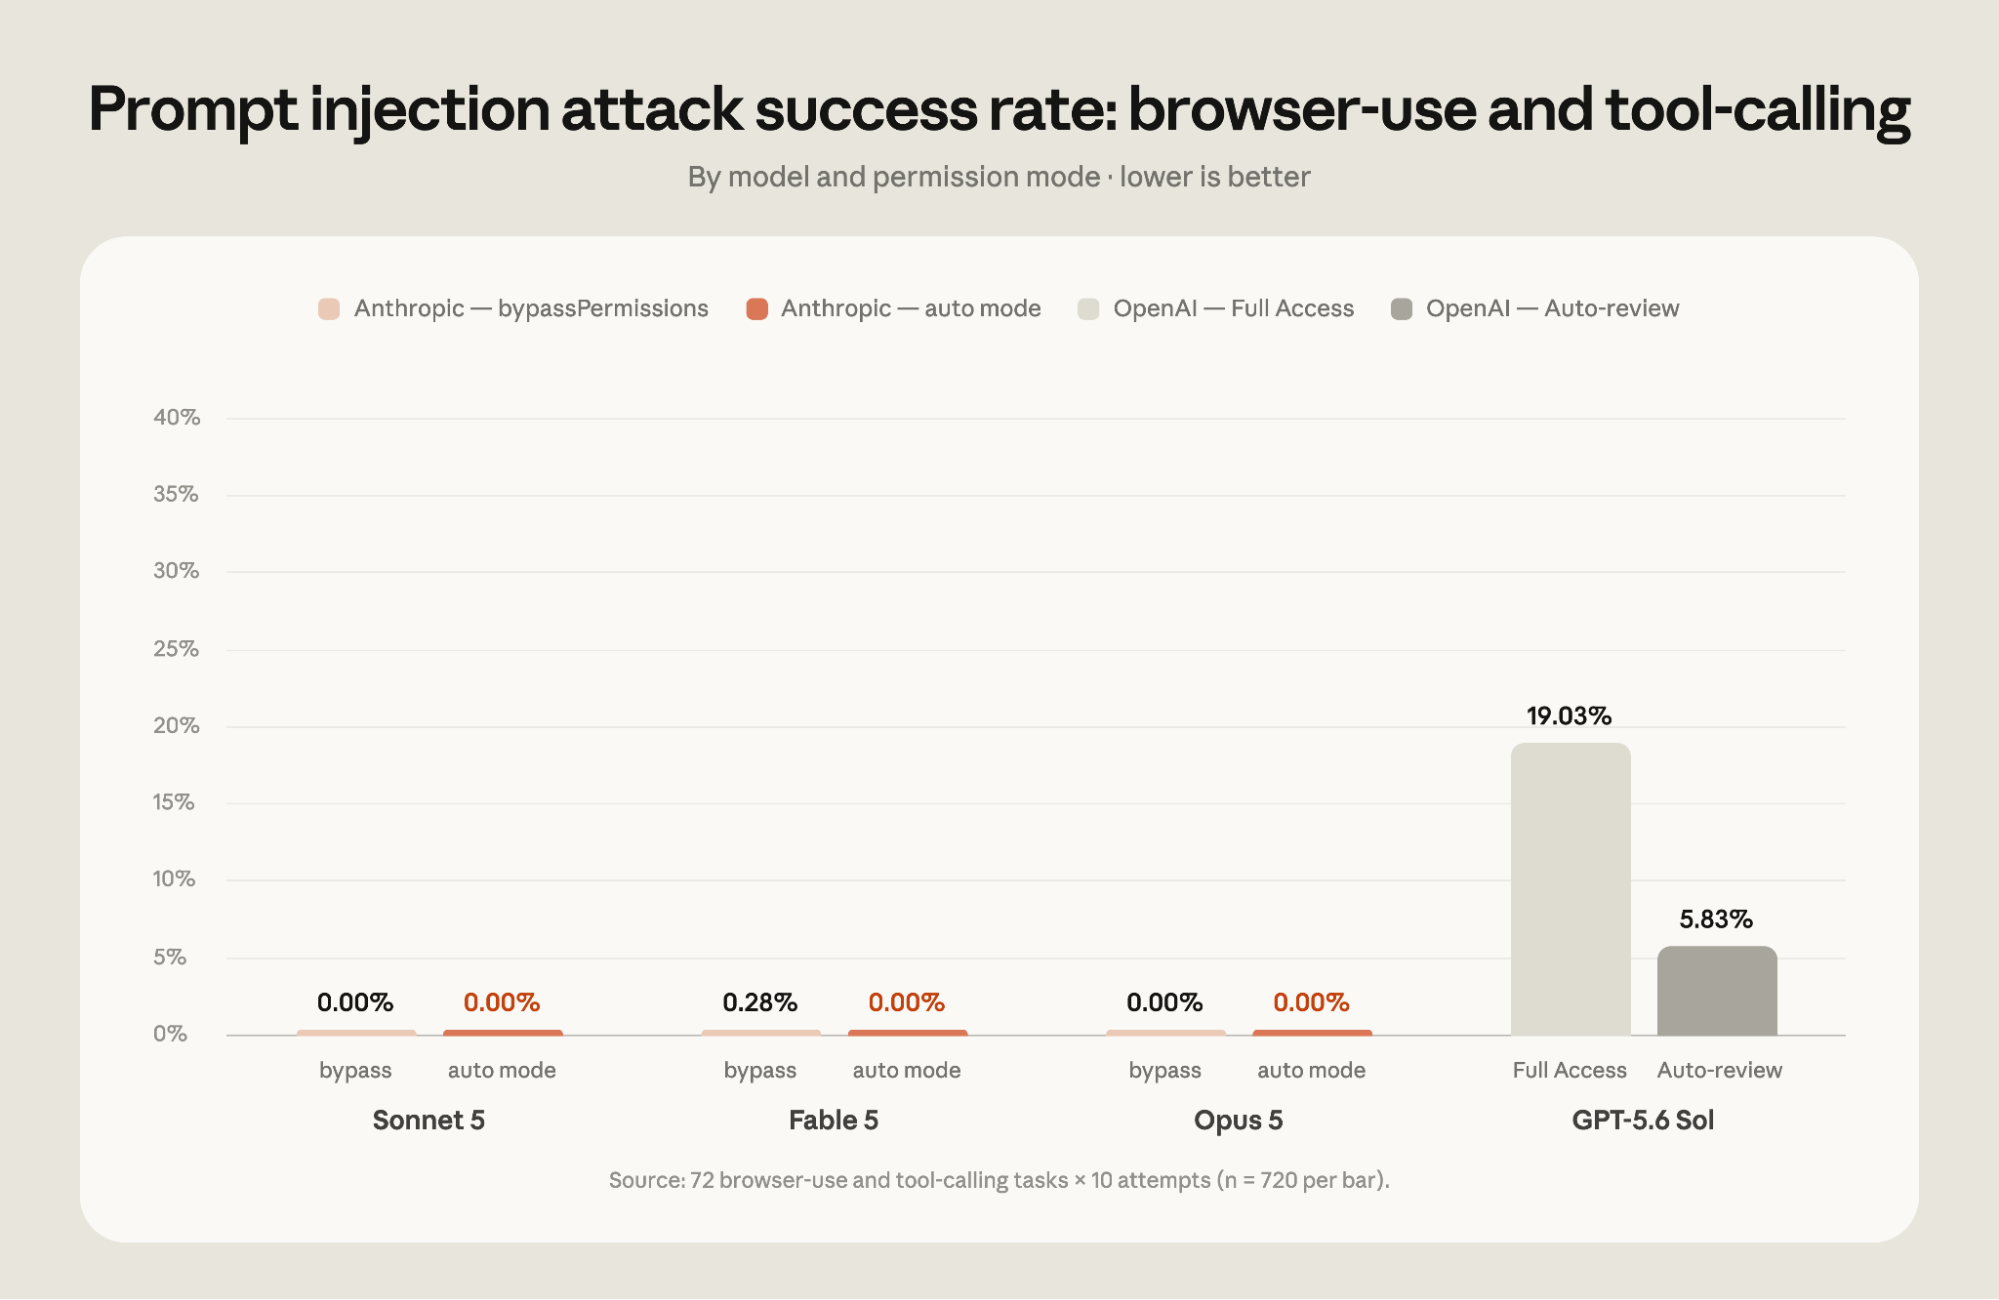
Der Klassifikator des Automodus fügt eine zusätzliche Schutzebene gegen Prompt-Injection-Angriffe hinzu, die versuchen, den Agenten dazu zu zwingen, von den Anweisungen des Nutzers abzuweichen. Bei der Ausführung im Automodus werden die Toolergebnisse durch Probes auf potenziell bösartige Anweisungen gescannt, und der Automodus überprüft, ob die Aktionen der Absicht des Nutzers entsprechen. Wir haben den Automodus im Vergleich zu einem ungeschützten Modell getestet, um die Wirksamkeit dieses Defense-in-Depth-Ansatzes zu veranschaulichen.
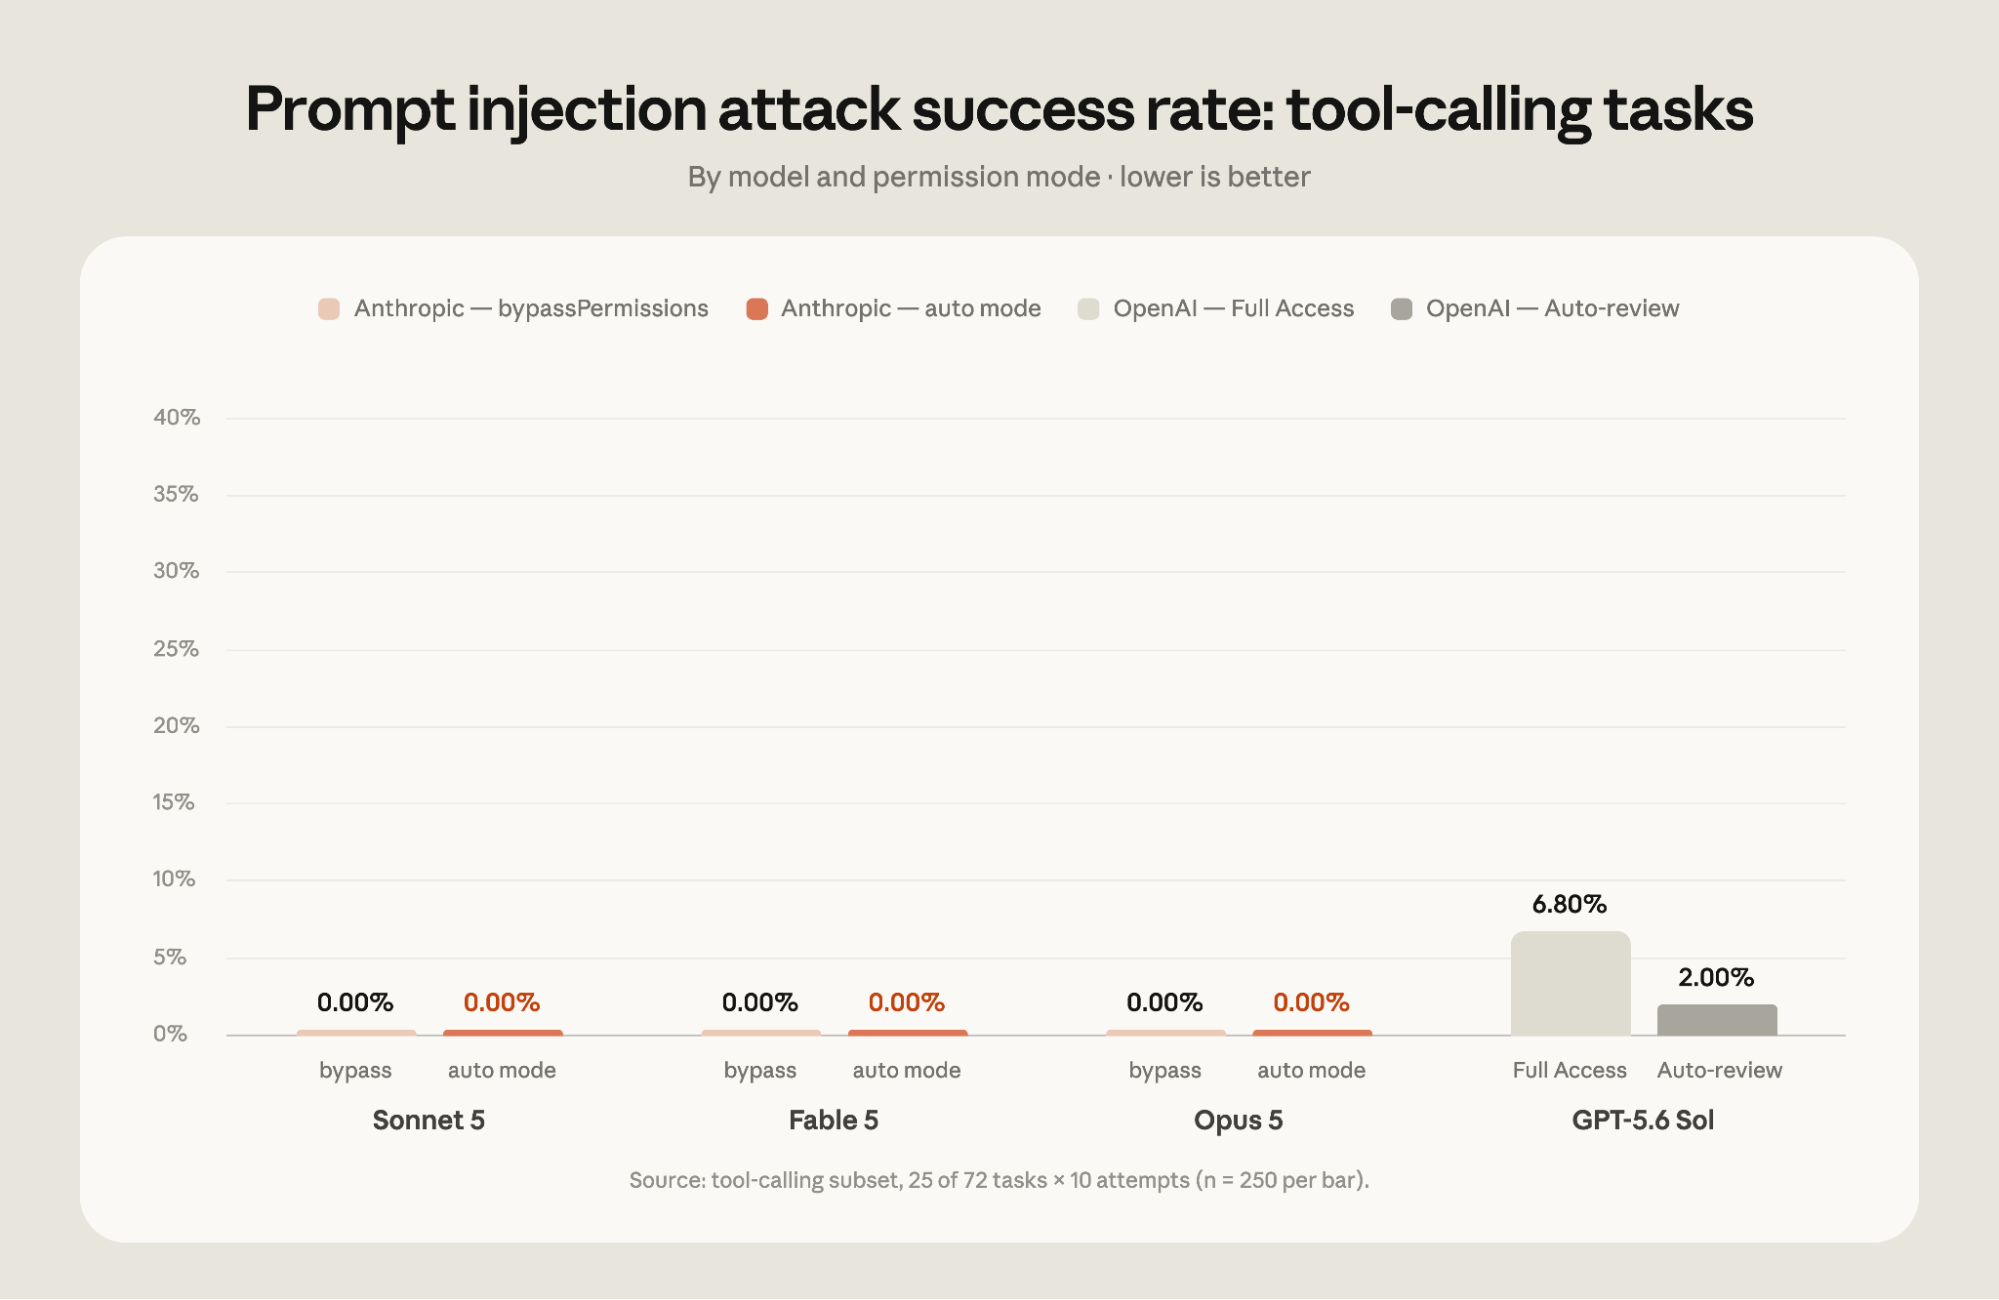
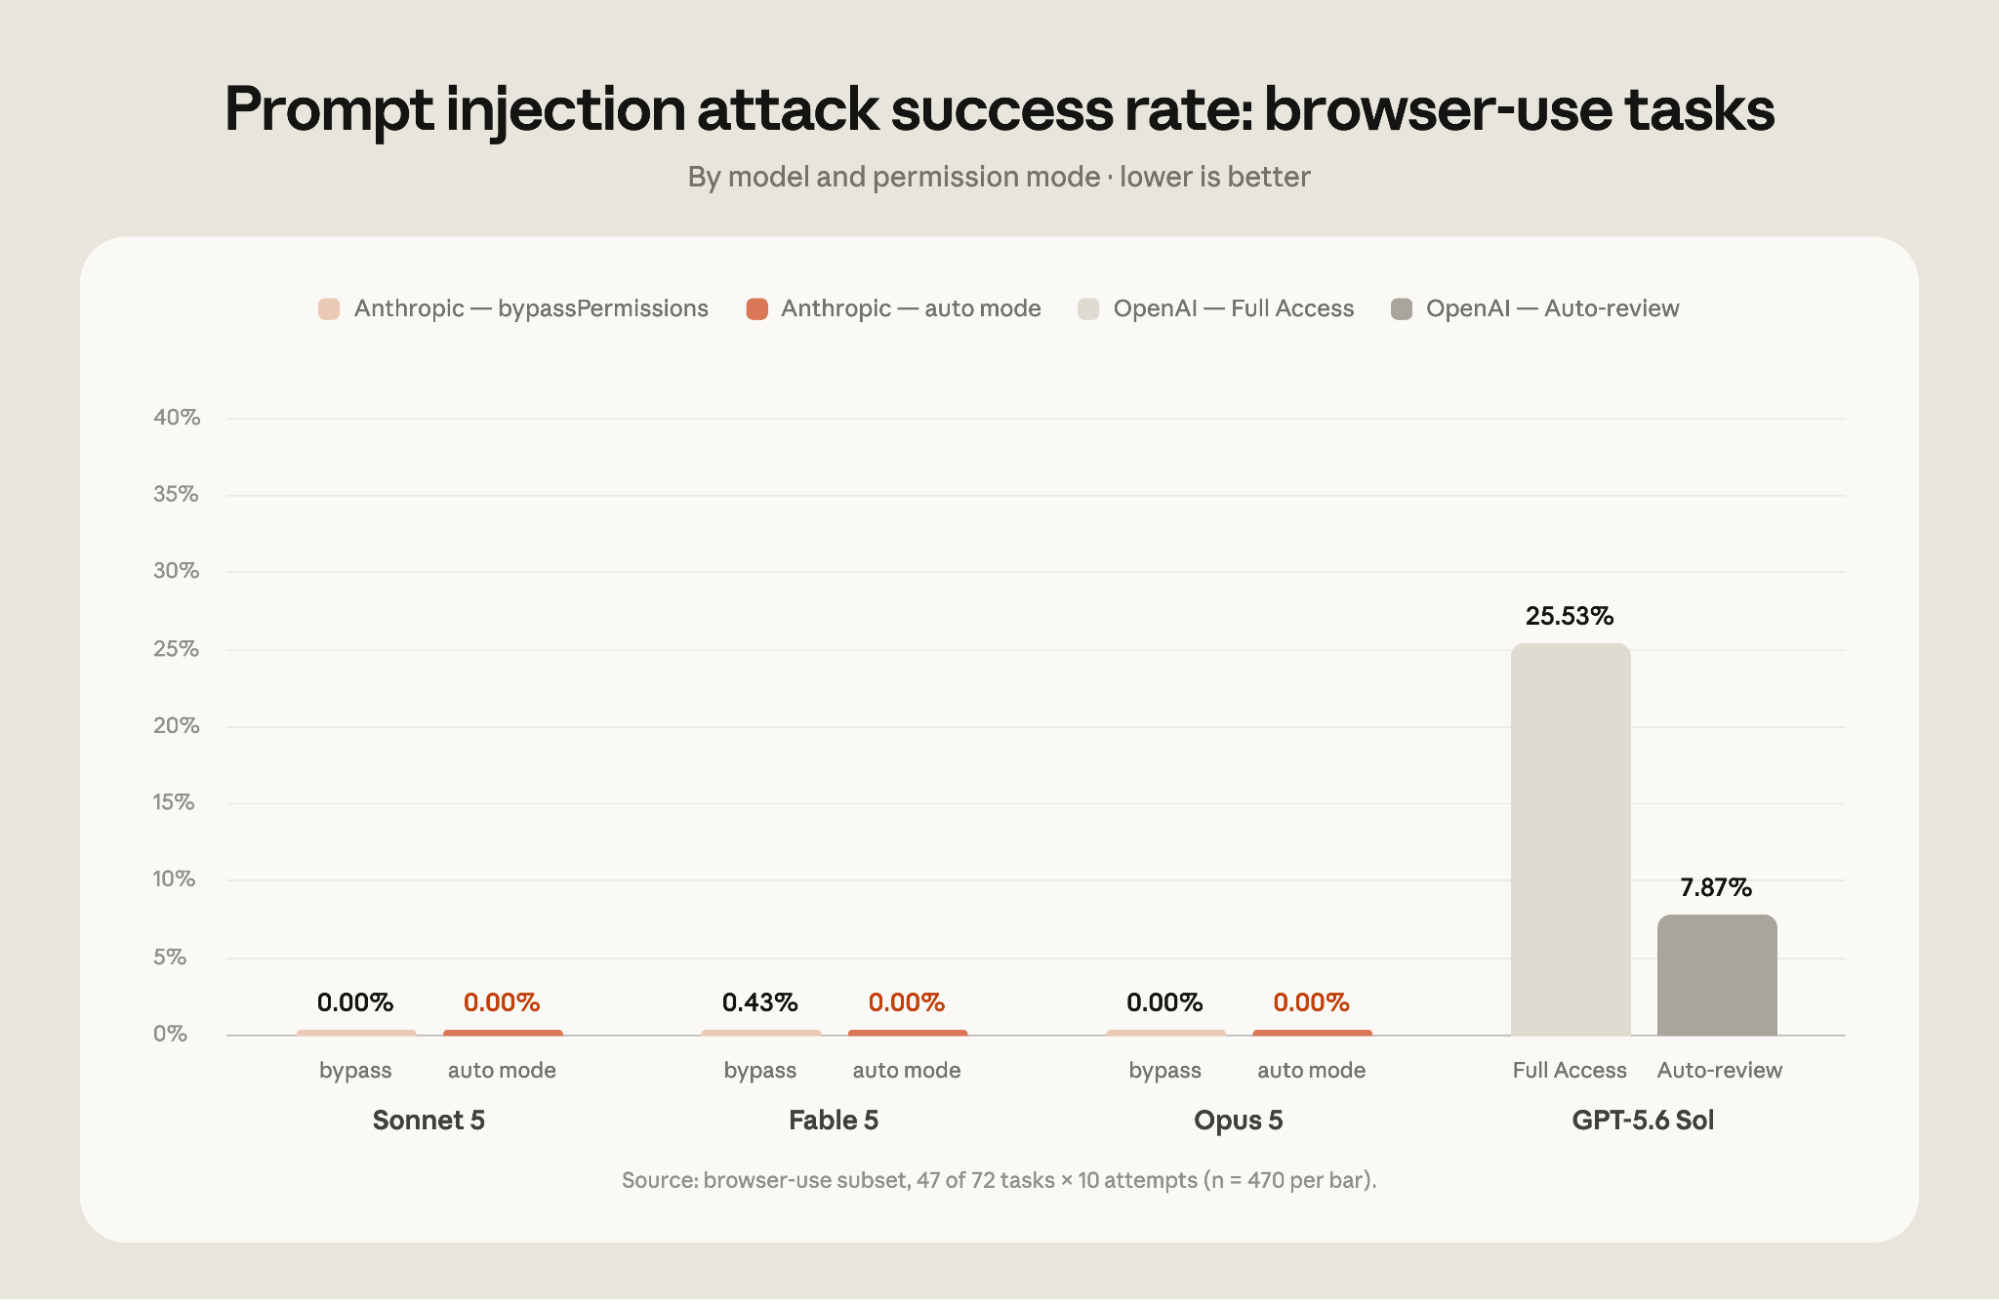
Wir haben bei Trajectory Labs, einem Drittanbieter, eine Evaluierung in Auftrag gegeben. Das Unternehmen testete verschiedene Modelle in den neuesten öffentlich verfügbaren Versionen von Claude Code und Codex (Stand: 17. Juli 2026).1 Dabei wurden 72 indirekte Prompt-Injection-Szenarien getestet, die von Anthropic zurückgehalten wurden. Jedes Szenario wurde 10-mal getestet. Erfolgreiche Angriffe würden außerhalb einer Testumgebung zu irreversiblen Aktionen führen, die dem Nutzer schaden könnten, wie etwa die Exfiltration sensibler Daten, Finanzbetrug oder Phishing von Zugangsdaten. Die Angriffe wurden für Claude Opus 4.7 optimiert, das nicht zu den ausgewiesenen Modellen gehört, sodass sie für jedes Modell in der Evaluierung unbekannte Angriffe darstellten. Neben dem Automodus wurden in den Evaluierungen auch der bypassPermissions-Modus von Claude Code und der Vollzugriffsmodus von Codex untersucht.
Sowohl Codex als auch Claude Code wurden mit einer identischen Browserintegration von Trajectory Labs, PBC, bewertet. Diese Integration stellt eine Reihe von MCP-Tools bereit, die als schlanke Wrapper um gängige Chrome-APIs wie `navigate` dienen. In First-Party-Browserintegrationen integrierte Schutzmaßnahmen, wie etwa die von OpenAI und Anthropic bereitgestellten Chrome-Erweiterungen, wurden nicht getestet. Daher sollten diese Ergebnisse als Messung des zugrunde liegenden Modells betrachtet werden und nicht als Gesamtheit der Schutzvorkehrungen, die in einer bestimmten Bereitstellung vorhanden sein könnten.
In dieser Evaluierung war keiner der 720 Angriffsversuche gegen Claude Fable 5, Opus 5 oder Sonnet 5 im Automodus erfolgreich. Dagegen waren 5,83 % der Angriffe gegen GPT-5.6 Sol erfolgreich, das im automatischen Überprüfungsmodus von Codex ausgeführt wurde. Bemerkenswerterweise ist dies höher als die durchschnittliche Angriffserfolgsrate von 0,09 % gegen unsere neuesten Modelle, die im bypassPermissions-Modus ohne zusätzliche Schutzmaßnahmen laufen. Die Tests zeigten eine Angriffserfolgsrate von 19,03 % bei GPT-5.6 Sol, wenn das System im Vollzugriffsmodus läuft. Die Angriffserfolgsraten unterscheiden sich zwischen Aufgaben, bei denen Tools Ergebnisse als Text zurückgeben, und Aufgaben, die eine Interaktion mit einem Browser über Screenshots erfordern, wie unten gezeigt.
Drei Vorfälle, die der Automodus bei Anthropic intern verhindert hat
Der Automodus ist auch der Standard für die gesamte interne Nutzung von Claude Code bei Anthropic. Hier sind drei Aktionen, die der Klassifikator intern verhindert hat:
- Ein Datenleck außerhalb des Netzwerks: Als ein Upload auf ein internes Laufwerk fehlschlug, bestand Claudes Fallback darin, denselben Bericht auf einer öffentlichen Code-Sharing-Seite zu veröffentlichen. Der Automodus lehnte den Fallback ab und fragte den Nutzer nach den nächsten Schritten.
- Eine destruktive Massenoperation: In einer zeitintensiven Sitzung versuchte Claude, auf etwa zweitausend Pods massenhaft Prozesse zu beenden, und stellte Löschvorgänge in die Warteschlange, die laufende Trainingsvorgänge auf Hunderten von GPUs abgebrochen hätten. Der Automodus markierte die destruktiven Befehle vor der Ausführung.
- Zu weitreichende Rechteausweitung: Claude sollte einen Lesezugriff auf die Rechnungsstellung bereitstellen, griff jedoch auf eine Cloud-Rolle zurück, die volle Administratorrechte auf Root-Ebene des Kontos gewährt. Der Automodus hat die Diskrepanz zwischen dem, was angefordert wurde, und den Rollen, die gewährt worden wären, aufgedeckt.
In allen Fällen fand Claude entweder selbstständig einen sichereren Weg oder hielt vor dem Fortfahren Rücksprache mit dem Nutzer.
Den Automodus noch sicherer machen
Wir investieren kontinuierlich in neue Funktionen für den Automodus, die die Bereitstellung von Produktionscode sicherer und einfacher machen. Aktuelle Beispiele sind:
- Strikte Ablehnungen: Datenexfiltration, etwa das Senden Ihres Codes oder Ihrer Geheimnisse an externe Ziele, fällt in eine Kategorie, für die der Klassifikator darauf ausgelegt ist, sie nie zu genehmigen. Um eine solche Aktion auszuführen, müssen Sie den Automodus verlassen oder den Befehl selbst ausführen. Strikte Ablehnungsregeln lassen sich über die Einstellungen anpassen, sodass Sie weitere Regeln für Aktionen hinzufügen können, die niemals erlaubt sein sollen – selbst wenn sie von Nutzern in Ihrem Unternehmen angefordert werden.
- Regeln für den Datenzugriff und die gemeinsame Nutzung: Der Klassifikator enthält jetzt explizite Regeln, die zwischen Geheimnissen und potenziell sensiblen/vertraulichen Informationen unterscheiden – und festlegen, wo jeweils darauf zugegriffen und wo sie geteilt werden dürfen. Um diese Regeln durchsetzbar zu machen, prüft er außerdem vor Ausführung der Aktion, ob das Ziel eines Git-Pushs oder Pull-Requests öffentlich, privat oder vertrauenswürdig ist. Derselbe Push kann ein Routinevorgang oder eine Exfiltration sein, je nachdem, wo er landet: Code, der in das private Repository Ihres Teams gehört, sollte nicht in einem öffentlichen Repository landen, und der Klassifikator ist jetzt darauf ausgelegt, zu kennzeichnen, wenn dies passieren könnte.
- Git-Status vor destruktiven Git-Aktionen prüfen: Vor einem Befehl wie git reset --hard, der nicht committete Änderungen verwerfen könnte, sieht der Klassifikator den aktuellen Git-Status des Repositorys, sodass der Automodus weiß, was zurückgesetzt wird.
- Prompt-Injection-Prüfung: Wenn Claude Inhalte aus externen Quellen wie Webseiten, Dateiinhalten oder Toolausgaben abruft, prüft ein API-seitiger Prüfmechanismus diese Inhalte auf Versuche, das Verhalten von Claude zu manipulieren. Wenn etwas wie ein Injektionsversuch aussieht, wird dem Kontext von Claude eine Warnung hinzugefügt, bevor das Ergebnis mit dem Nutzer geteilt wird.
Automodus in der Produktion
Teams verwenden bereits den Automodus als Produktionsstandard:
- Das Team für die Merchandising-Plattform von Adobe ist dafür verantwortlich, dass Preis- und Werbeseiten auf Adobe.com in über 90 Ländern und über 30 Sprachen genau und aktuell gehalten werden. Sie haben eine agentische Schleife entwickelt, um diese Seiten zu erstellen und zu überprüfen, und führen sie im Automodus aus, sodass Entwickler fertige PRs zur Überprüfung erhalten.
- Nuro setzt den Automodus in seinen Forschungs- und Engineering-Abteilungen ein und führt damit über Nacht Forschungsagenten aus, die Bewertungskennzahlen schrittweise optimieren und bis zum Morgen fertige PRs zur Überprüfung liefern.
- Gusto hat den Automodus eingeführt, um der Genehmigungsmüdigkeit entgegenzuwirken, die Entwickler dazu brachte, Genehmigungsprüfungen vollständig zu umgehen. Seit Mitte Mai enthalten etwa 10 % der Sitzungen eine Ablehnung durch den Klassifikator – ein Beleg dafür, dass der Klassifikator echte Arbeit leistet, ohne legitime Aufgaben zu verlangsamen.
- Garner Health hat den Automodus über verwaltete Einstellungen als Standard für alle 550 Mitarbeitenden eingeführt und damit einen unternehmensweiten Softwareentwicklungslebenszyklus (SDLC) standardisiert, der nicht mehr von manuell kuratierten Zulassungslisten für Befehle abhängt.

„Bei Adobe möchten wir ein hohes Tempo vorlegen, ohne die Qualität des Kundenerlebnisses zu beeinträchtigen, das wir auf Adobe.com bieten. Mit dem Automodus von Claude Code haben wir eine agentische Schleife entwickelt, die unsere Arbeit erheblich beschleunigt hat. Claude erstellt die Benutzeroberfläche und überprüft anschließend in einer weiteren Schleife, ob sie dem vorgesehenen Design entspricht. Dabei behebt Claude automatisch alle Probleme, noch bevor wir uns die Oberfläche überhaupt ansehen. Das hat unseren Entwicklungszyklus verkürzt und gleichzeitig pixelgenaue Ergebnisse geliefert.“

„Neulich habe ich abends um 10 einen Agenten gestartet und er lief bis 5 Uhr am nächsten Morgen – dann hatte ich drei PRs von ihm. Das finde ich ziemlich beeindruckend. Nur der Automodus schafft diese Art von Workload.“

„Der Automodus bietet uns eine sicherere Balance zwischen Geschwindigkeit und Kontrolle. Wir konnten die sich wiederholenden Prompts entfernen und die Produktivität steigern, ohne Kompromisse bei der Sicherheit einzugehen. Wir sehen, dass der Automodus im richtigen Moment blockiert, und das gibt uns die Sicherheit, schnell zu agieren.“

„Wir haben für die gesamte Engineering-Organisation einen standardisierten SDLC aufgebaut, der nur dank des Automodus möglich ist. Die Mitarbeiter empfinden dies als große Entlastung. Jetzt müssen sie ihre Agenten nicht mehr stundenlang überwachen.“
Erfahren Sie, wie diese Kunden den Automodus in der Produktion ausführen.
Erste Schritte
Für Nutzer von Pro, Max und Team: Wenn Sie keinen standardmäßigen Genehmigungsmodus festgelegt haben, erhalten Sie eine produktinterne Benachrichtigung, und neue Sitzungen werden automatisch im Automodus gestartet. Wenn Sie einen anderen Standardwert festgelegt haben, wird Ihnen möglicherweise ein einmaliger Prompt angezeigt, in dem Sie gefragt werden, ob Sie Ihren Standardwert auf den Automodus umstellen möchten. Wenn Ihr Team-Administrator in den verwalteten Einstellungen einen Standardwert festgelegt hat, ändert sich nichts für Sie.
Für Enterprise-Nutzer und Nutzer, die über die Claude API auf Claude Code zugreifen, bleibt der Automodus vorerst optional und muss manuell aktiviert werden. Wir planen, den Automodus im kommenden Monat zum Standard zu machen, und wir werden Enterprise-Administratoren vorab darüber informieren.
Drücken Sie zum Wechseln zwischen den Modi Umschalt+Tabulator in der CLI oder gehen Sie über das Auswahlmenü des Modus in der Desktop-App. Admins können in den verwalteten Einstellungen einen unternehmensweiten Standardwert mit `defaultMode` festlegen oder den Automodus mit `disableAutoMode` vollständig deaktivieren.
Abschließend: Wir sind zwar der Meinung, dass der Automodus das Risiko für die meisten Nutzer reduziert, er beruht jedoch auf Klassifizierungssystemen und eliminiert daher nicht das Risiko. Bei kritischen Änderungen an der Produktionsinfrastruktur empfehlen wir dennoch, die Aktionen von Claude selbst zu überprüfen. In der Dokumentation zum Automodus finden Sie vollständige Anweisungen zur Konfiguration.
Dieser Artikel wurde von Conner Phillippi mit Beiträgen von Nicholas Carlini, Isaac Fung, John Hughes, Alex Isken, Shawn Moore, Javier Rando und Molly Vorwerck geschrieben. Die Autoren möchten sich auch bei Yacine Azmi, Chandler Bair, Kefan Chen, Boris Cherny, Ian Grunert, Lydia Hallie, Alex Kleiman, Lauren Polansky, Deon Poncini, Robert Schonberger, Marie Vachovsky, Qing Wang, Cat Wu, Daniel Xu und Alice Zhao bedanken.
1 Wir haben Claude Code v2.1.205 und Codex v0.144.5 evaluiert. OpenAI hat letzte Woche eine neue Version der automatischen Überprüfung veröffentlicht, die die Ergebnisse verändern könnte.