Il playbook per l'SDLC nativo IA
Come trasformare il ciclo di vita dello sviluppo software con l'IA, fase dopo fase.
Il codice non è più il collo di bottiglia
Le organizzazioni hanno iniziato a utilizzare l'IA per scrivere codice a una velocità impensabile solo un anno fa, eppure i processi legati al codice non si sono evoluti allo stesso ritmo.
Molti team di sviluppo applicano ancora gli stessi gate di approvazione, le stesse revisioni, gli stessi passaggi di consegne e le stesse policy, che frenano gli incrementi di produttività ottenuti con soluzioni di programmazione agentica come Claude Code.
L'SDLC (Software Development Lifecycle, ciclo di vita dello sviluppo software) è il processo che porta il software dall'idea alla produzione. La maggior parte delle organizzazioni adotta una variante delle stesse sei fasi: pianificazione, progettazione, sviluppo, test, distribuzione e manutenzione del software. Tradizionalmente, ogni fase è un passaggio distinto, affidato a un ruolo diverso. Il team di product management scrive i requisiti, quello responsabile dell'architettura tecnica li traduce in progetti, il team di ingegneria li realizza, i team di QA delle aziende regolamentate verificano il software, i team di rilascio lo distribuiscono e quelli operativi monitorano i sistemi in esecuzione. Il lavoro passa da una fase all'altra attraverso documenti, ticket e approvazioni formali.
Il tradizionale ciclo di vita dello sviluppo software (SDLC) è fortemente incentrato sui processi per garantire responsabilità e controllo a ogni passaggio. Tuttavia, è stato concepito per massimizzare l'efficienza in un'epoca in cui la fase più costosa e dispendiosa in termini di tempo era scrivere e implementare il codice, cosa che oggi non è più vera. PRD, procedure di stima e revisioni della sicurezza del prodotto servivano tutti a imporre l'allineamento durante settimane, mesi o trimestri di lavoro di sviluppo.
L'SDLC tradizionale prevede inoltre controlli che presuppongono che ogni passaggio sia svolto da persone. Le organizzazioni che generano maggior valore hanno ripensato il proprio processo sulla base di ciò che l'IA agentica è oggi in grado di fare, garantendo al contempo la supervisione umana. In questa guida, traendo ispirazione dalla collaborazione con i nostri clienti, esaminiamo diverse best practice del nostro team di IA applicata per integrare Claude internamente in ogni fase dell'SDLC, così da accelerare lo sviluppo e rendere i processi più rapidi.
Quando il codice non è più il collo di bottiglia e la fase di sviluppo procede più velocemente di quanto l'SDLC tradizionale consenta, si verificano tre condizioni:
- Il collo di bottiglia si sposta sui passaggi che precedono e seguono questa fase. Si tratta principalmente di pianificazione, revisione/test e distribuzione, che continuano a procedere a velocità umana.
- I controlli non rispecchiano più la realtà e diventano ingestibili. Rivedere manualmente ogni riga aveva senso quando era una persona a scrivere il codice, ma non è più sostenibile quando gli agenti scrivono la maggior parte del diff.
- I costi di governance aumentano perché le eccezioni continuano a essere gestite tramite riunioni e comitati con cadenza settimanale o mensile.
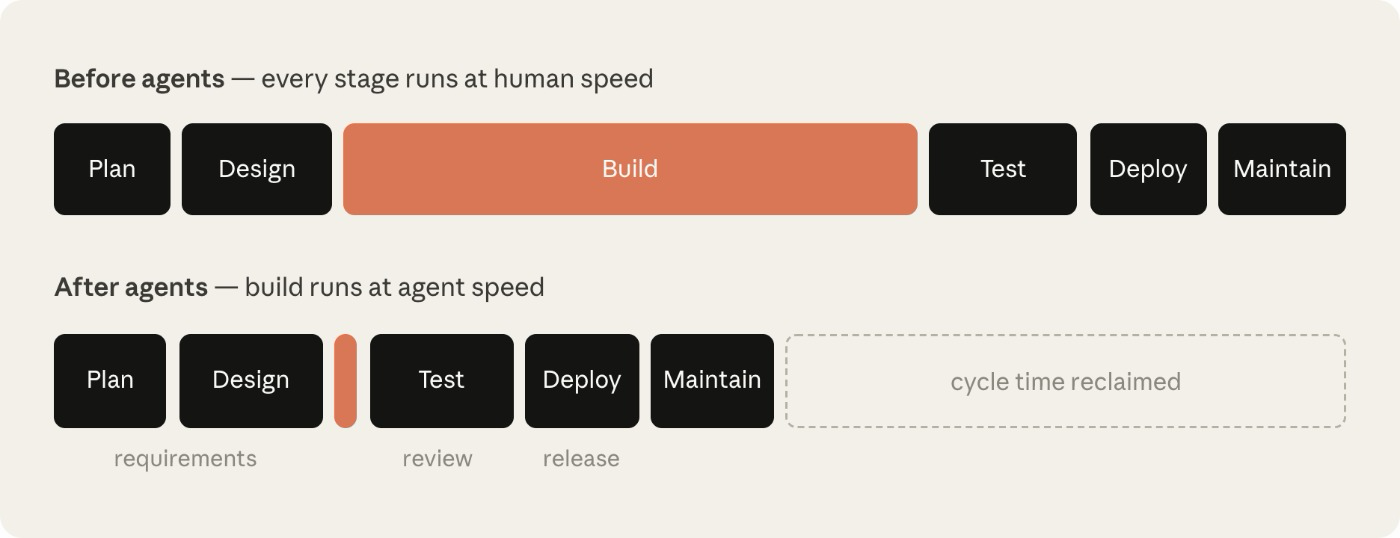
Prendiamo come esempio un collo di bottiglia legato alla sicurezza. I team di sicurezza sono dimensionati sulla produzione umana, quindi quando gli agenti moltiplicano il codice prodotto, o si allunga la coda di revisione oppure il codice viene rilasciato senza revisioni adeguate. Un'organizzazione soggetta a regolamentazione non può accettare nessuno dei due esiti, pertanto i controlli di sicurezza e sulle policy devono tenere il passo con gli agenti.
Per sfruttare appieno gli incrementi di produttività dell'IA agentica e garantirne la sicurezza, l'SDLC tradizionale richiede lo stesso livello di trasformazione affrontato dalla fase di implementazione.
Cos'è un SDLC nativo IA?
L'SDLC nativo IA è un processo ripensato che combina i consueti obiettivi di controllo con nuove modalità di applicazione. Anziché seguire un flusso lineare, il processo diventa un ciclo in cui l'IA è integrata in ogni punto. Il ciclo di vita dello sviluppo software nativo IA favorisce il trasferimento e l'attivazione automatizzati di sequenze operative successive, contribuendo a superare la natura manuale e macchinosa dei passaggi di consegne tra le fasi di un SDLC tradizionale.
Questo cambiamento viene anche definito SDLC agentico, SDLC IA o semplicemente sviluppo software agentico: le denominazioni variano, ma descrivono lo stesso concetto.
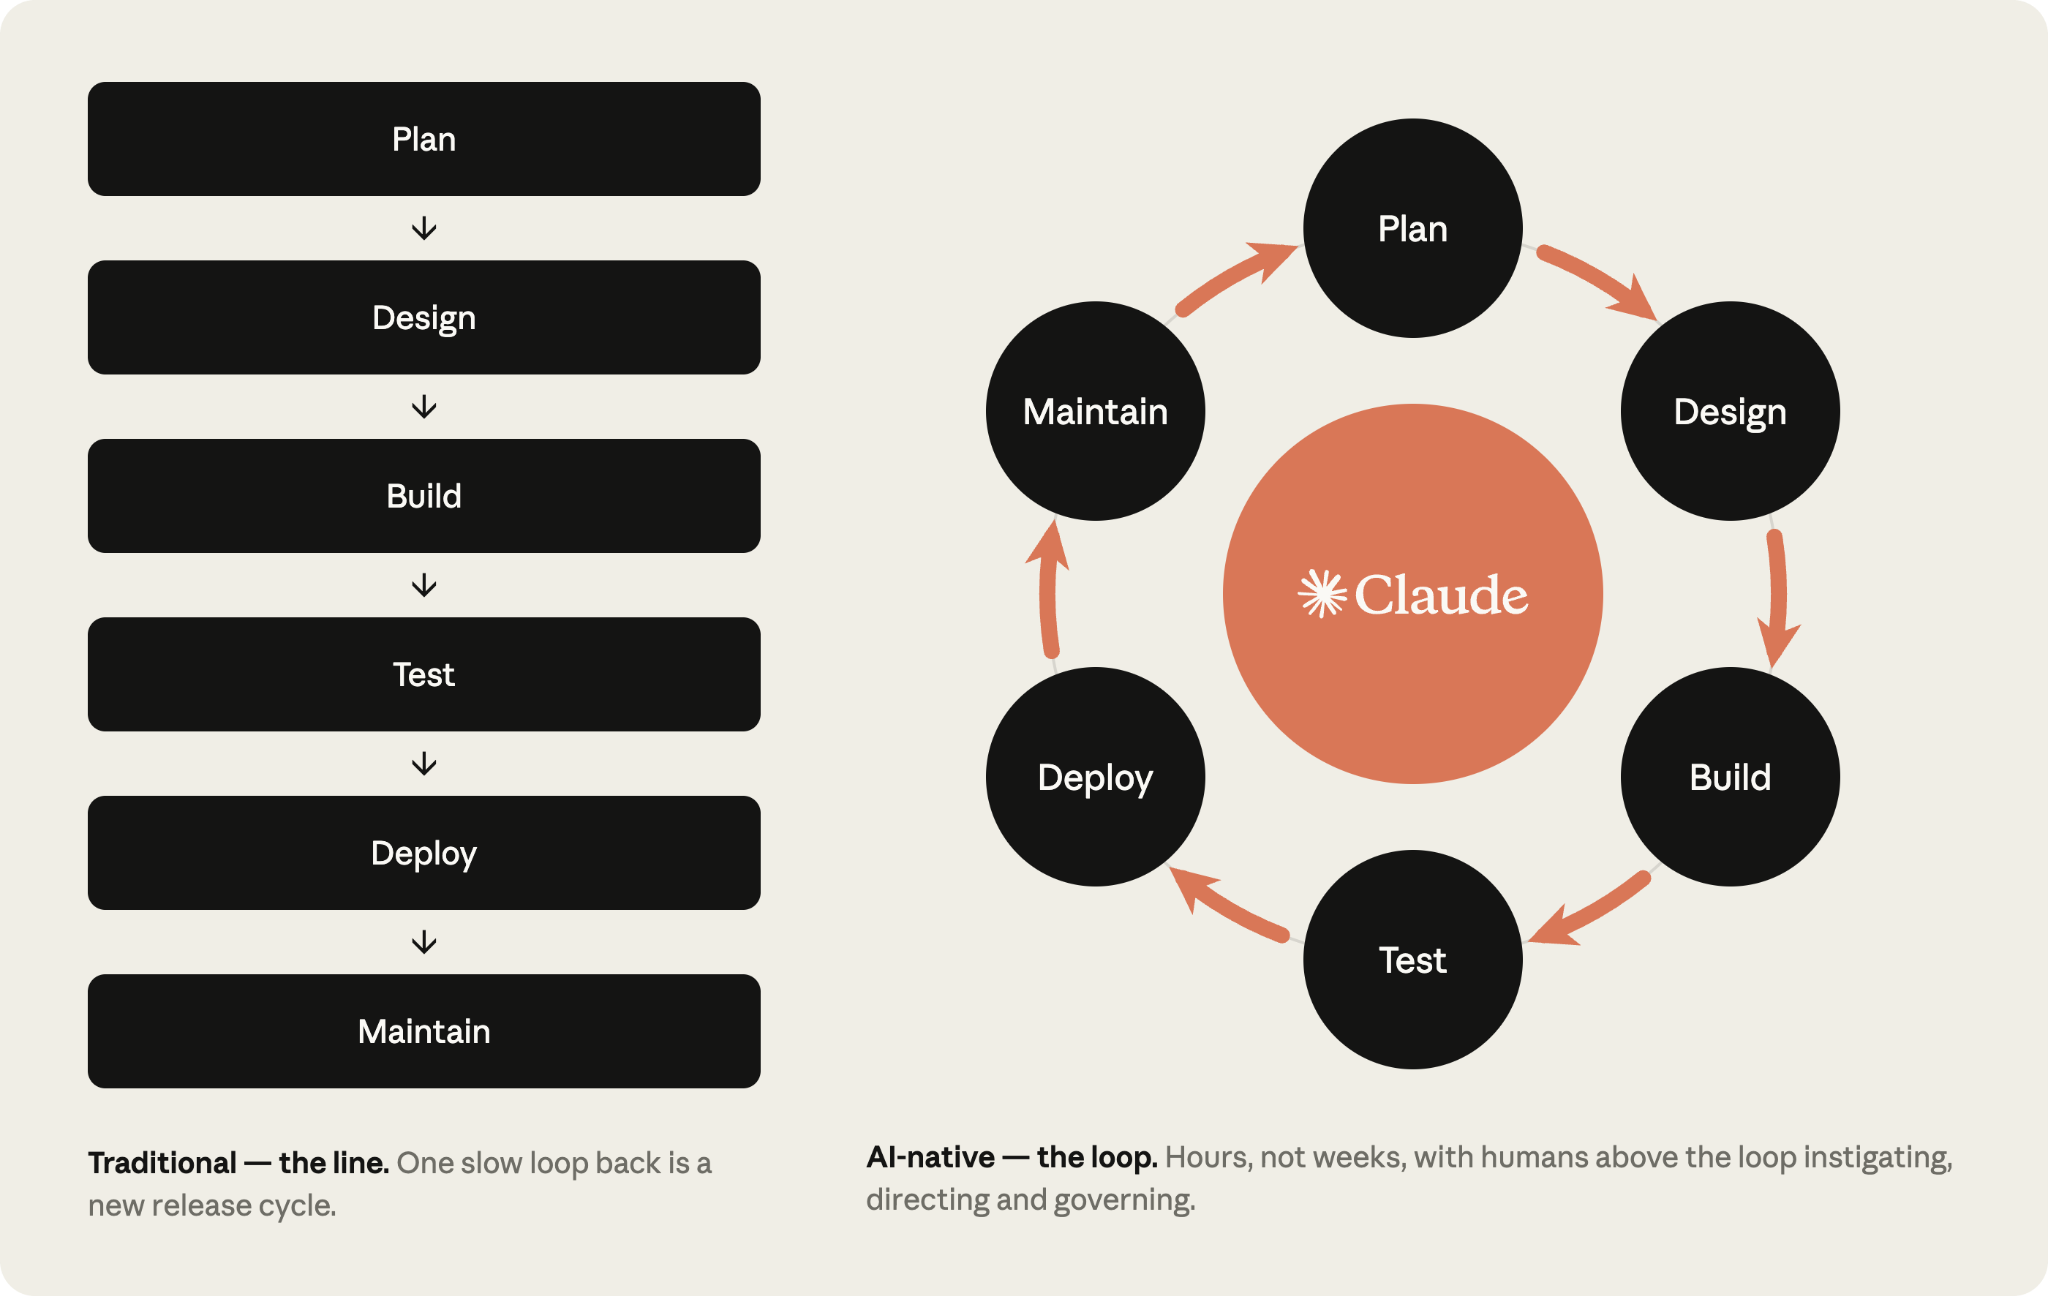
I cambiamenti nelle sei fasi di un SDLC nativo IA
La tabella seguente evidenzia gli estremi dello spettro tra l'SDLC tradizionale e l'SDLC nativo IA, supportato da Claude. La maggior parte delle organizzazioni si colloca in un punto intermedio tra le due colonne.
Il filo conduttore della colonna di destra è l'artefatto sottoposto a commit. Ogni fase termina scrivendone uno nel sistema di controllo di versione (tra cui intent.md, spec.md, plan.md, il diff con i relativi test, la PR con i risultati della revisione e il registro degli incidenti) e la fase successiva inizia leggendolo. Nelle fasi iniziali, i file .md sono l'artefatto prevalente poiché un product owner e un agente possono entrambi leggere e intervenire sullo stesso file. A partire dalla fase di build, l'artefatto è costituito dal codice e dai relativi record. La catena di commit funge anche da traccia di audit: chi ha chiesto cosa, che cosa ha prodotto l'agente e chi lo ha approvato.
Gli esseri umani mantengono la responsabilità di ogni decisione che richiede capacità di giudizio. Nel mondo dell'SDLC agentico, l'attenzione umana si sposta insieme agli artefatti da revisionare.
I play
I play sono il fulcro del playbook e sono raggruppati in sei fasi non lineari (Pianificazione, Progettazione, Sviluppo, Test, Distribuzione, Manutenzione), che insieme coprono l'intero ciclo di vita.
Ogni play comprende:
- cosa cambia;
- come iniziare;
- i passaggi concreti per l'implementazione;
- le considerazioni sulla governance e
- come misurare i risultati ottenuti.
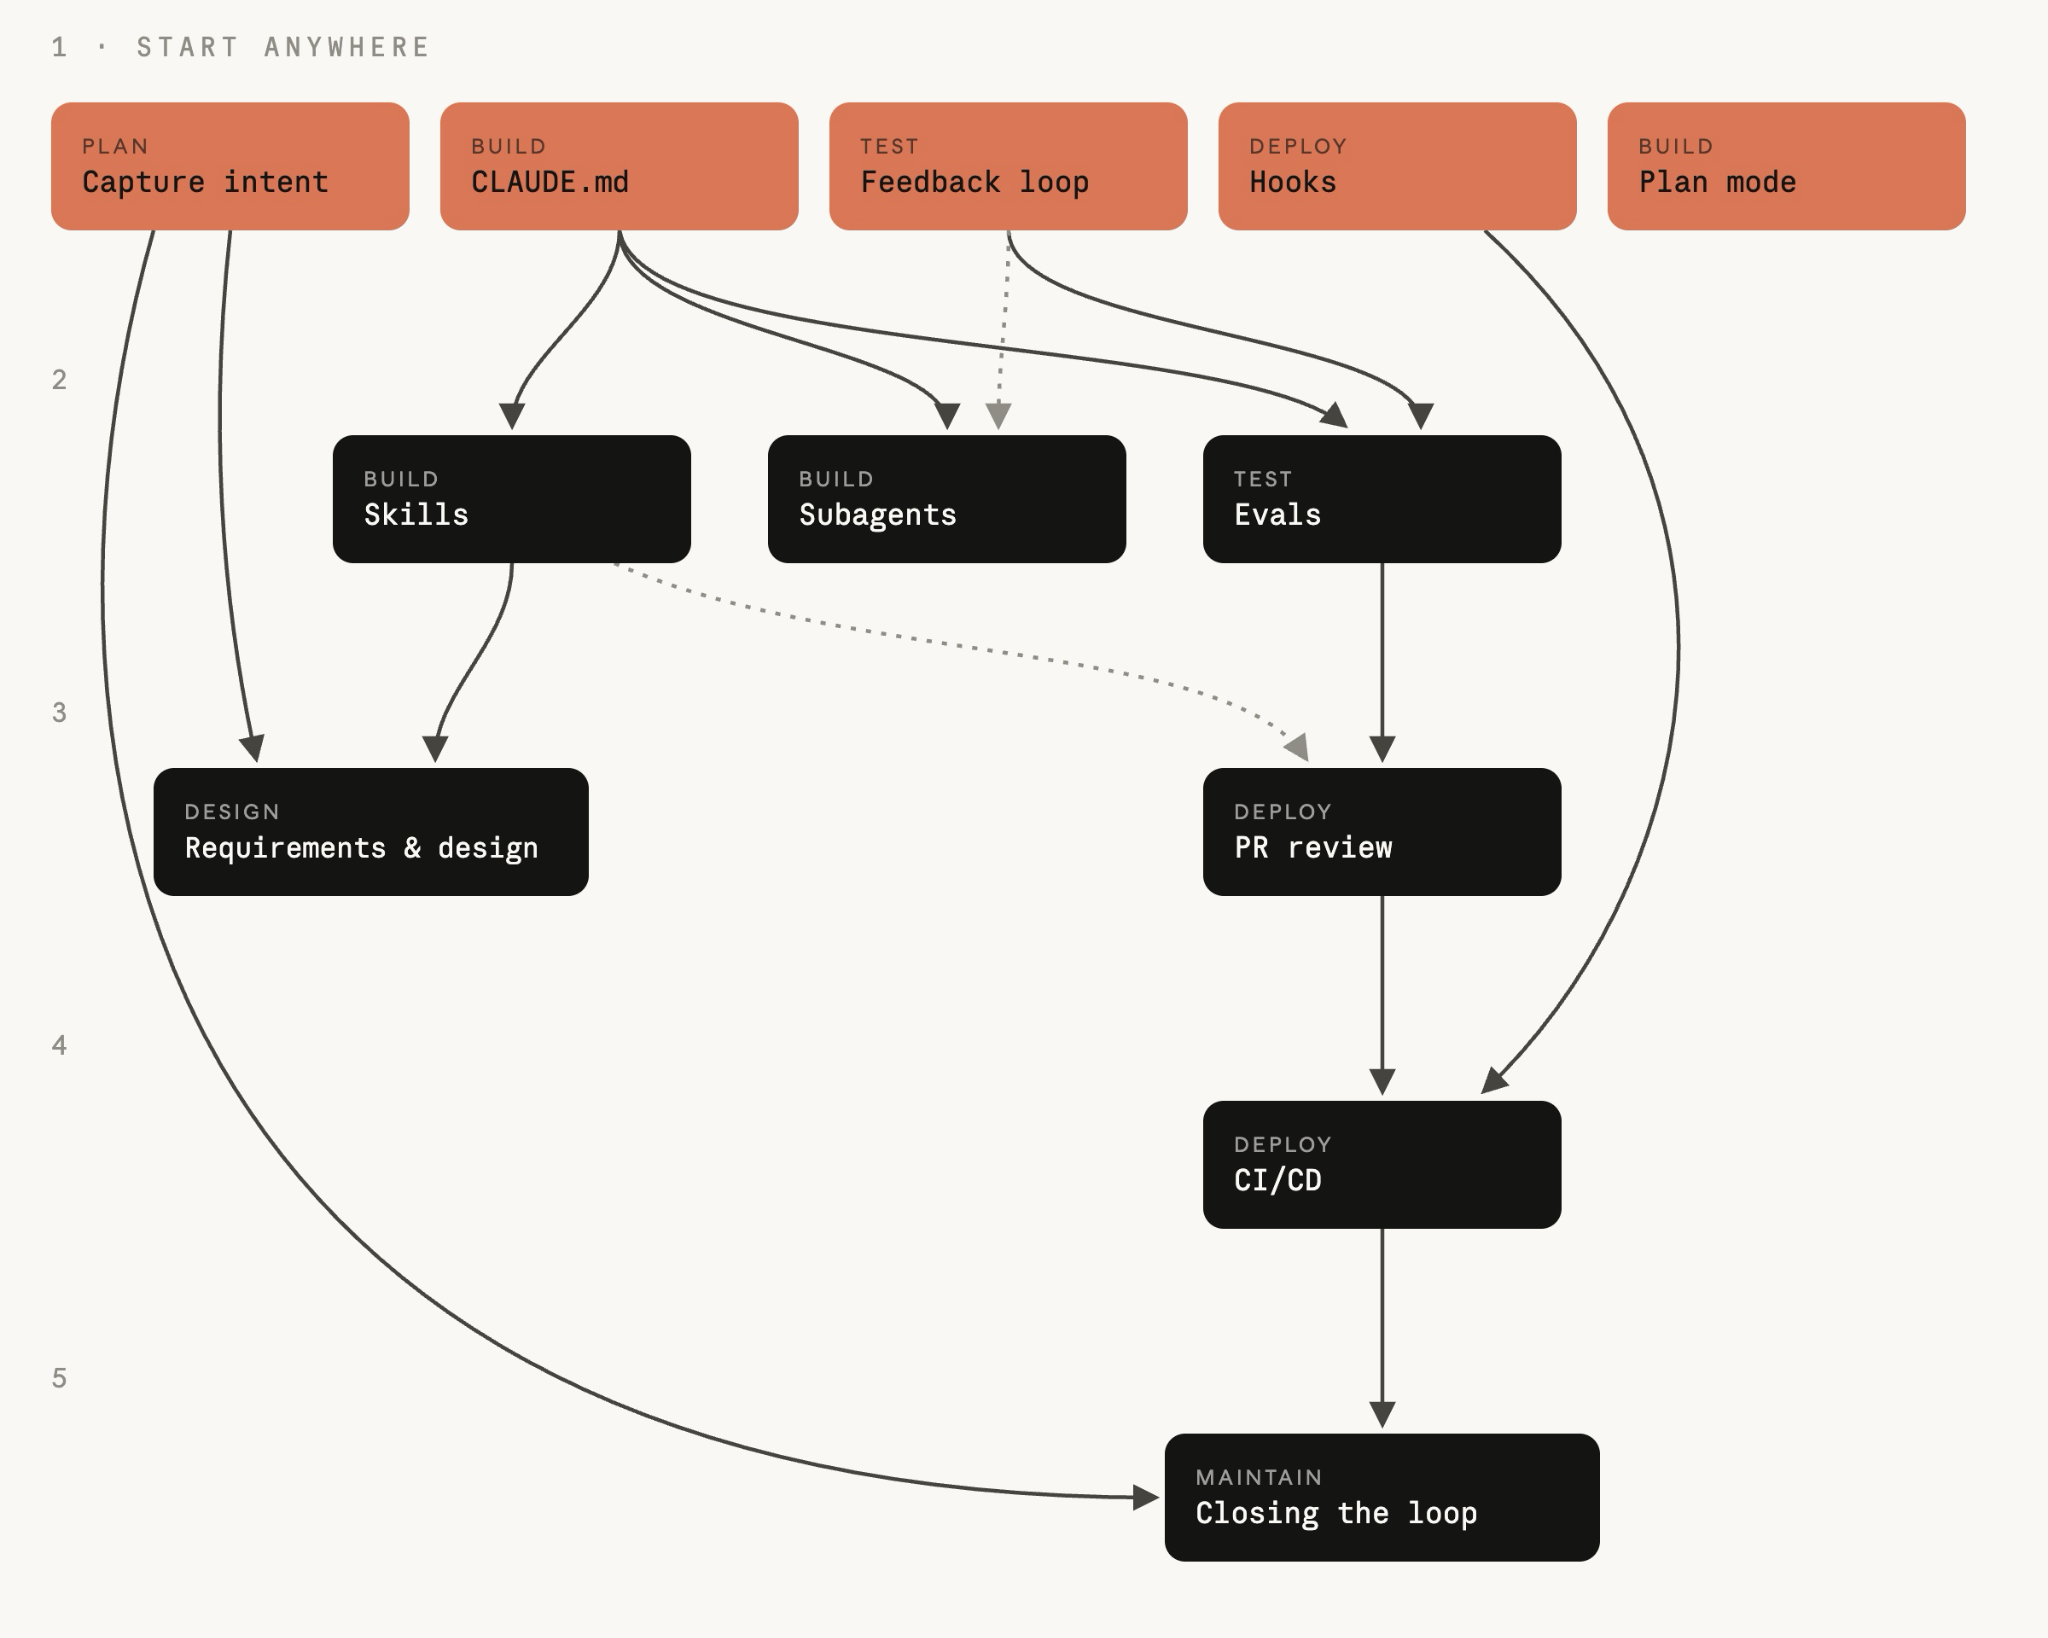
I passaggi sono modulari e le organizzazioni possono scegliere di dare priorità alla trasformazione di fasi differenti in momenti diversi in base alle proprie esigenze specifiche. Ogni play indica le proprie dipendenze nella sezione "Prerequisiti", ulteriormente illustrata dal grafo delle dipendenze.
Una fase si conclude con il commit di un artefatto, e questo commit avvia la fase successiva. L'accettazione di intent.md attiva il passaggio di definizione dei requisiti e di progettazione, l'approvazione di spec.md attiva la modalità di pianificazione, il merge di una PR avvia la pipeline e il superamento di una banda di controllo in produzione genera il successivo intent.md, facendo così proseguire il ciclo.
Inizialmente, ogni passaggio viene eseguito manualmente tramite prompt con l'obiettivo finale di creare un ciclo in cui ogni artefatto accettato attiva il gate successivo. L'attenzione umana si concentra sui punti di controllo per rivedere ciò che l'agente ha segnalato, anziché ricominciare ogni fase da zero.
Acquisizione come intent.md
Il file intent.md, che dà avvio al processo di sviluppo software, può essere generato attraverso percorsi diversi. Una persona ha un'idea, viene aperto un ticket oppure viene segnalato un incidente tramite un alert, come descritto nella Fase 6: Manutenzione.
Quando una persona ha un'idea, inizia un brainstorming con Claude e produce una bozza di specifica in markdown. Nell'SDLC tradizionale, la stessa persona deve poi convincere un membro del team di prodotto a mettere per iscritto l'idea insieme o per suo conto.
La bozza di specifica generata da Claude è leggibile dagli esseri umani, sottoposta a controllo di versione e immediatamente utilizzabile dalla fase successiva. La bozza viene salvata come intent.md.
Indipendentemente dal fatto che l'intento derivi da un evento scatenante o da un agente, i passaggi sono gli stessi: il product owner rivede e corregge l'intent.md scritto dall'agente prima che ne venga eseguito il commit.
La configurazione è un'attività da svolgere una tantum per il team di piattaforma o di ingegneria. Un membro del team tecnico deve configurare la intent home e stabilire chi è autorizzato a scrivervi, poiché i contributi proverranno da tutta l'organizzazione.
Una volta creato il repository, quanti contribuiscono senza esperienza con git non hanno bisogno di utilizzarlo direttamente. Al contrario, un connettore al sistema di controllo di versione, ad esempio GitHub, consente a Claude di eseguire il commit dei file markdown per conto di queste persone da claude.ai o Cowork.
Come si procede con l'esecuzione
- Chi propone l'idea descrive il problema a Claude con parole proprie. Può spiegare cosa non è possibile fare attualmente, chi sarà interessato dall'idea, quale sarebbe una soluzione ideale oppure cosa esula dall'ambito. Non è necessario alcun linguaggio formale.
- Prosegui il brainstorming finché l'idea non diventa concreta. Claude pone le domande che farebbe un analista: ambito, utenti, vincoli e criteri di successo.
- Chiedi a Claude di scrivere il risultato come
intent.mdutilizzando il modello dell'organizzazione, che può essere codificato come Skill, configurata da un membro del team tecnico e validata da un responsabile. Il file può includere il problema, il risultato proposto, gli utenti e i sistemi interessati, i vincoli e le questioni irrisolte. - Chi ha proposto l'idea corregge eventuali fraintendimenti di Claude.
- Esegui il commit di
intent.mdnell'archivio condiviso. Autore e timestamp vengono aggiunti al record e da quel momento il product owner prende in carico l'idea.
# Intent: claims status self-service
Author: J. Ortiz (claims operations). Status: draft.

## Problem
Customers phone the contact center to ask where their claim is.
Handlers spend roughly a third of call time on status-only queries.

## Proposed outcome
Customers see claim status, next step and expected date in the portal.

## Affected users and systems
Claims handlers, portal team, claims-core API.

## Constraints
No new PII in the portal session. Existing authentication only.

## Open questions
Do third-party loss adjusters need access too?
Considerazioni sulla governance
La prova è costituita dall'intent.md sottoposto a commit, che riporta l'autore, il timestamp e la cronologia completa delle revisioni. Viene registrato nella cronologia git della intent home. Il product owner approva e la decisione di accettare o rifiutare, che invia l'intento alla Fase 2: Progettazione, viene registrata come merge o come chiusura della revisione.
Requisiti e progettazione
Dopo l'approvazione del product owner, Claude prende l'intent.md accettato e produce una specifica di requisiti e progettazione. Questa procedura è guidata dalle Skills dell'organizzazione relative a brand, sicurezza, conformità e UX.
Il product owner rivede la specifica, ma non la scrive. L'obiettivo di questo processo è creare una specifica su cui il team di ingegneria possa basare la pianificazione, con le aree critiche già segnalate.
Il lavoro sul front-end ne è l'esempio più lampante. Dopo l'accettazione di intent.md, il product owner realizza il mockup del design in Claude Design (in versione beta) a partire da intent.md, lo perfeziona attraverso iterazioni e poi lo esporta in Claude Code per lo sviluppo.
Come si procede con l'esecuzione
- Il product owner apre una sessione con le Skills dell'organizzazione disponibili e allega il file
intent.md. - Il prompt del product owner fa riferimento al file
intent.md, indica i vincoli ed evidenzia le criticità. Inizialmente l'operazione viene eseguita manualmente, per poi essere codificata come comando slash a livello di organizzazione. A quel punto, l'accettazione dell'intent.mdnell'intent home diventa il trigger: un processo non interattivo si avvia al momento del merge, l'esecuzione avviene caricando le Skills dell'organizzazione e il filespec.mdviene inserito tramite commit come pull request (l'infrastruttura necessaria è trattata nel play CI/CD della Fase 5: Distribuzione). Da quel momento in poi, il primo intervento del product owner è la revisione. - Lo stesso product owner rivede la specifica rispetto all'idea iniziale. La specifica risolve il problema dichiarato? Le questioni irrisolte del file
intent.mdhanno ricevuto risposta o sono state riportate nei passaggi successivi? - Si affrontano prioritariamente le criticità segnalate, poiché corrispondono ai punti che un analista avrebbe inoltrato ai livelli superiori. Il product owner risolve ogni questione con il relativo policy owner prima che il team di ingegneria esamini la specifica.
- Si esegue il commit di
spec.mdinsieme aintent.md. La coppia di file documenta cosa è stato richiesto e cosa è stato deciso. - Il product owner decide se la specifica e l'intento possono procedere alla fase di sviluppo, consultando un responsabile tecnico per qualsiasi elemento classificato dall'organizzazione come a rischio più elevato. Questa decisione spetta sempre a una persona del team e l'accettazione della specifica avvia il play della modalità di pianificazione nella Fase 3: Sviluppo.
Come si presenta (il prompt)
Read the attached intent.md and produce a requirements and design spec for integrating it into our existing codebase. Apply the skills available to you so the plan conforms to our brand guidelines, security policies and UX standards. Document the spec fully as spec.md, ready to hand to the engineering team. Describe clearly any areas of concern, especially where you cannot satisfy contradicting policies.Considerazioni sulla governance
Anziché emergere in una revisione svolta settimane dopo, la policy attiva viene letta e applicata contestualmente alla stesura della specifica. Le Skills dell'organizzazione fungono da vincoli sulla specifica. La specifica, il prompt che l'ha prodotta e le versioni della Skill attive vengono tutti registrati nel controllo di versione. Il product owner approva la specifica e inoltra le criticità segnalate ai responsabili delle policy indicati.
Claude Code in modalità di pianificazione come punto di partenza predefinito
Il team di sviluppo avvia le sessioni di Claude Code in modalità di pianificazione, fornisce a Claude il file spec.md approvato proveniente dalla Fase 2: Progettazione e lascia che il modello ponga delle domande, perfezionando il piano tramite iterazioni finché il membro del team non ne è soddisfatto.
Come si procede con l'esecuzione
- Chi si occupa di sviluppo avvia la sessione con Claude in modalità di pianificazione.
- Fornisce a Claude i file
intent.mdespec.mde richiede un piano di implementazione che specifichi i file da modificare, l'ordine di esecuzione delle attività e i test che ne dimostrano la correttezza. - Metti alla prova il piano chiedendo quali elementi la modifica potrebbe compromettere, quale passaggio è il più rischioso e quali altre opzioni Claude ha scartato.
- Itera finché un membro del team di sviluppo che non ha mai visto la conversazione non è in grado di implementare la modifica basandosi unicamente sul piano.
- Esegui il commit del piano approvato come
plan.md. Il piano entra a far parte della traccia di audit e il play di revisione delle PR (Fase 5: Distribuzione) verifica il diff finale rispetto al piano stesso. - Accetta il piano e lascia che Claude proceda con l'implementazione. Con un piano solido, l'implementazione richiede spesso un unico passaggio.
- Quando l'implementazione si discosta dal piano, aggiorna
plan.mdnello stesso commit. Valuta l'utilizzo di un hook per imporre la sincronizzazione tra i due elementi.
Come si presenta (plan.md)
# Plan: claims status self-service (from intent.md 2026-06-02)

## Files that change
portal/src/claims/StatusPanel.tsx (new), claims-api/routes/status.py,
claims-api/tests/test_status.py

## Order of work
1. Add the status endpoint behind existing auth.
2. Panel against the endpoint.
3. Wire into the portal nav.

## Risks
The claims-core API rate-limits at 50 rps; the panel must cache.

## Proof
test_status.py covers the four claim states; screenshot matches the
approved mock.
Considerazioni sulla governance
La revisione della progettazione avviene prima della generazione di qualsiasi codice, quando un cambio di rotta consiste ancora nella modifica di un documento. La modalità di pianificazione lo impone di per sé, poiché Claude non può modificare i file finché chi sviluppa non accetta il piano. Il piano e le relative revisioni vengono registrati insieme a chi li ha accettati. Le modifiche di routine vengono approvate dal membro del team di sviluppo, mentre tutti gli aspetti che l'organizzazione classifica come a rischio più elevato vengono affidati a un responsabile tecnico o a un architetto.
Claude Code in modalità automatica
Claude Code può essere eseguito anche in modalità automatica: chi sviluppa approva il piano e, una volta soddisfatto e dopo le iterazioni necessarie, Claude applica ogni modifica senza richiedere conferma per ciascun intervento. Man mano che si sviluppano meccanismi di protezione previsti dai play successivi, ovvero un file CLAUDE.md ottimizzato, Skills che codificano le policy, hook che bloccano le azioni non sicure e una suite di test eseguibile da Claude, l'accettazione automatica diventa l'impostazione predefinita per le attività di routine: un file spec.md ben definito, un raggio d'azione limitato e codice già coperto dai test.
Il baricentro si sposta dall'utente che osserva l'agente effettuare le modifiche e ne rivede le azioni, alla revisione degli artefatti al termine di sessioni autonome più lunghe. La modalità di accettazione automatica favorisce ulteriormente il lavoro in parallelo tra persone e team, se utilizzata con i worktree, risultando fondamentale per eseguire l'SDLC in autonomia e chiudere il ciclo, come descritto nella Fase 6: Manutenzione.
Il file CLAUDE.md
Il file CLAUDE.md fornisce a Claude il contesto di cui un nuovo membro del team avrebbe bisogno: convenzioni, comandi, architettura e gli errori riscontrati più frequentemente. Le conoscenze in precedenza custodite nella memoria delle persone e su wiki diventano un file letto dall'agente all'inizio di ogni sessione, mantenuto dall'intero team e perfezionato ogni volta che si verifica un errore.
Come si procede con l'esecuzione
- Esegui
/initnel repository. Claude genera un fileCLAUDE.mdiniziale in base a ciò che trova. - Riduci il file generato inserendo solo le informazioni essenziali per il primo giorno di un nuovo membro del team. Mantieni i comandi di build, test e lint, le convenzioni importanti e i punti su cui Claude continua a sbagliare.
- Aggiungi
CLAUDE.mda git nella radice del repository, in modo che l'intero team ne condivida un'unica versione e le modifiche vengano riviste come codice. - In questo caso è utile una regola pratica. Quando Claude commette lo stesso errore due volte, la correzione viene inserita in
CLAUDE.md. - Mantieni il file entro una pagina, perché Claude lo legge per intero all'inizio della sessione e qualsiasi contenuto obsoleto occupa contesto senza offrire alcun vantaggio.
Come si presenta (CLAUDE.md)
# Payments service

## Commands
- Build: make build
- Test: make test (unit), make itest (integration, needs docker)
- Lint: make lint (runs in CI; fix before pushing)

## Conventions
- Java 21, Spring Boot 3. No new Lombok.
- Money is always BigDecimal, never double.
- Every endpoint needs an integration test in src/itest.

## Architecture
- api/ holds REST controllers, core/ holds domain logic,
  adapters/ talks to external systems.
- Kafka events are defined in schemas/; never edit generated classes.

## Things Claude gets wrong
- Do not bump dependency versions; the platform team owns them.
- The legacy v1/ package is frozen; changes go in v2/.
Considerazioni sulla governance
CLAUDE.md è sottoposto a controllo di versione, pertanto le istruzioni seguite dall'agente sono revisionabili e verificabili. Le convenzioni del team vengono applicate tramite questo file, le relative modifiche sono registrate nella cronologia di git e i code owner le approvano durante la revisione delle PR.
Le Skills come conoscenza istituzionale
Le Skills rappresentano lo strumento con cui un'organizzazione rende operativa la propria conoscenza istituzionale. Le istruzioni sono esplicite, sottoposte a controllo di versione, applicate in modo esteso e aggiornate centralmente in caso di modifiche alla policy. Una regola generale: scrivi una Skill per la conoscenza istituzionale che deve essere applicata in modo coerente; non scriverne una per elementi che appartengono a CLAUDE.md o a un prompt.
Come si procede con l'esecuzione
- Scegli un elemento di conoscenza che attualmente viene applicato in modo incoerente. Potrebbe trattarsi di uno standard di sicurezza, una convenzione di progettazione delle API o una regola di brand.
- Scrivilo come una Skill, ovvero una cartella contenente un file
SKILL.mdil cui frontmatter definisce le condizioni di attivazione e il cui corpo specifica le azioni da compiere. Un membro del team di sviluppo la scrive partendo dalla fonte di verità del responsabile della policy, con l'aiuto di Claude. - Inserisci la Skill nel repository in
.claude/skills/<name>/in modo che venga distribuita insieme al codice, oppure distribuiscila a livello di organizzazione tramite un plugin. - Verifica l'attivazione della Skill. Chiedi a Claude di eseguire l'attività pertinente in modi diversi e controlla che la Skill venga caricata ogni volta.
- In caso di cambiamenti della policy, aggiorna la Skill e fai approvare la modifica dal responsabile della policy.
- Il team di sviluppo riceverà automaticamente la nuova versione nella sessione successiva.
Come si presenta (.claude/skills/secure-api-review/SKILL.md)
---
name: secure-api-review
description: Apply the API security standard. Use whenever creating or
  modifying an external-facing endpoint, reviewing API code, or
  generating an OpenAPI spec.
---
# Secure API review

When you create or change an API endpoint:
1. Authentication: every endpoint requires the gateway JWT;
   no anonymous routes outside /health.
2. Input validation: validate request bodies against the OpenAPI
   schema and reject unknown fields.
3. Audit: every state-changing endpoint emits an audit event with
   actor, action, entity and timestamp.
4. Data classification: fields tagged pii in the schema must never
   appear in logs or error messages.

Run scripts/check-endpoints.sh and include its output in your summary.
Considerazioni sulla governance
Una Skill è un controllo, seppur di tipo consultivo. Rende probabile che Claude applichi la policy durante la scrittura del codice, ma nulla obbliga una sessione a conformarvisi. Una policy che deve essere sempre rispettata richiede un meccanismo deterministico a supporto della Skill, come un hook che blocca l'azione o un passaggio di revisione che ricontrolla la policy al momento della PR. La Skill rende le violazioni rare mentre l'hook le rende quasi impossibili. Le invocazioni della Skill vengono registrate nelle tracce di sessione e il responsabile della policy rivede le modifiche alla Skill come codice.
Gli hook come barriere di protezione in fase di build
Una Skill rappresenta un controllo consultivo, mentre un hook costituisce il livello deterministico sottostante. La maggior parte delle azioni di Claude durante l'implementazione consiste in modifiche ai file e comandi di shell, quindi la fase di build è quella in cui gli hook tendono ad attivarsi più frequentemente.
Gli hook della fase di build possono:
- bloccare le modifiche a percorsi protetti, come classi generate o un pacchetto congelato;
- eseguire il formatter e il linter dopo le modifiche ai file per evitare l'accumulo di incoerenze;
- impedire l'inclusione di credenziali nel diff.
Affianca un hook a qualsiasi Skill la cui policy debba essere rispettata senza eccezioni. Un hook viene eseguito per ogni azione corrispondente, quindi gli hook della fase di build devono essere rapidi e limitati al file modificato. I controlli più complessi, come l'intera suite di test, vanno collocati al momento del commit o della PR.
Un hook che richiede l'approvazione umana deve essere associato ai gate della Fase 5: Distribuzione, perché un prompt di approvazione durante la build reinserisce una persona nel percorso critico di tutte le sessioni in esecuzione in parallelo.
Sessioni parallele e subagenti
Un solo membro del team di sviluppo può gestire più flussi di lavoro contemporaneamente.
Una sessione parallela è un'altra istanza completa di Claude Code, che elabora un'attività distinta nel proprio git worktree. Ogni sessione indipendente ignora l'esistenza delle altre e l'unico elemento condiviso è la persona del team di sviluppo che le coordina.
Un subagente viene eseguito all'interno di una singola sessione come assistente con un ambito definito e dotato di una propria finestra di contesto e limiti sugli strumenti, ed è adatto a compiti ricorrenti in più attività, come la verifica del corretto funzionamento dell'app.
Le sessioni parallele aumentano il numero di attività che un membro del team di sviluppo può avere in corso, mentre i subagenti mantengono ogni sessione concentrata sulla propria attività. Il compito di chi sviluppa consiste nel coordinarle e revisionarle tutte.
Come si procede con l'esecuzione
- Chi sviluppa suddivide il lavoro in attività che riguardano file diversi, utilizzando il piano definito nel play relativo alla modalità di pianificazione (Fase 3: Sviluppo) per individuare le aree di indipendenza operativa. Le attività che prevedono la condivisione di file vengono eseguite in un'unica sessione, una dopo l'altra.
- Ogni attività parallela ha il proprio worktree, ad esempio
claude --worktree feature-authin un terminale eclaude --worktree fix-rate-limitin un altro. Un worktree è una copia locale separata basata su un proprio branch, che impedisce alle sessioni di entrare in conflitto sui file. - Due o tre sessioni sono un punto di partenza ragionevole. Il limite pratico è determinato dal numero di flussi che una persona riesce a rivedere adeguatamente, quindi conviene aggiungere sessioni solo fintanto che la capacità di revisione tiene il passo.
- Trasforma i compiti ripetitivi in subagenti, definiti all'interno di file markdown in
.claude/agents/, ciascuno dotato di un nome, di una descrizione del contesto d'uso e degli strumenti ai quali può accedere. Gli esempi includono un code simplifier che rimuove complessità superflue dopo il completamento del lavoro dell'agente principale, un verifier che esegue l'app e ne controlla il comportamento, un researcher che esplora la codebase e restituisce i risultati senza sovraccaricare il contesto principale. Le definizioni devono essere inserite in git in modo che l'intero team le condivida.
Come si presenta (.claude/agents/verifier.md)
---
name: verifier
description: Runs the app and checks the change works before the session
  reports done
tools: Bash, Read
---
Start the app with make run. Exercise the changed behavior and the two
nearest neighboring flows. Report what you ran, what you saw, and any
behavior that does not match plan.md. Do not fix anything; report only.
Considerazioni sulla governance
Un numero maggiore di sessioni genera più output, quindi i controlli devono derivare dalla configurazione nel repository. Gli hook e le impostazioni di autorizzazione lì definiti si applicano a tutte le sessioni e le azioni di una sessione vengono registrate e attribuite al membro del team di sviluppo che l'ha avviata.
Fornire a Claude un ciclo di feedback
Fornisci sempre a Claude un modo per verificare il proprio lavoro, che si tratti di test, di una build o di un confronto tra screenshot. Una sessione verifica il proprio operato e corregge gli errori prima che se ne accorga un membro del team di sviluppo.
Il ciclo di feedback non deve essere confuso con un subagente verificatore (Fase 3: Sviluppo). Il ciclo di feedback viene eseguito sull'intera attività tante volte quante ne richiede il lavoro. Il subagente verificatore, d'altro canto, rappresenta un modo per racchiudere il controllo finale avviando una nuova finestra di contesto quando la sessione ritiene concluso il lavoro. In questo modo, il giudizio non è influenzato dalle ipotesi che hanno generato il codice.
Come si procede con l'esecuzione
- Se la verifica del lavoro richiede attualmente una sequenza di comandi e una certa conoscenza dell'ambiente, racchiudila in un unico target, ad esempio "make test" o "npm test", che restituisca un codice di uscita diverso da zero in caso di errore.
- Nella sezione Commands del file
CLAUDE.md, elenca ogni comando accompagnato da un esempio di output corretto. - Definisci un obiettivo e rendilo quantificabile in modo che Claude possa verificare il lavoro senza doverti porre domande, ad esempio: "Tutti i test in test_status.py hanno un esito positivo", "lo screenshot corrisponde al mockup allegato" o "l'endpoint restituisce 200 con il nuovo campo".
- Per la correzione dei bug, scrivi prima il test che fallisce. Chiedi a Claude di riprodurre il bug sotto forma di test, eseguirlo e confermare che fallisca per il motivo previsto. Esegui il commit di quel test. Solo a quel punto chiedi a Claude di farlo passare senza modificare il test, lasciando che sia l'hook sul file di test del passaggio finale a far rispettare questa restrizione. Un test esistente prima della correzione e che l'agente non ha potuto riscrivere rappresenta la prova che il bug è stato eliminato.
- Per il lavoro sull'interfaccia utente, completa il ciclo con una verifica visiva. Fornisci a Claude un browser o uno strumento per gli screenshot, insieme al mockup, e lascia che proceda per iterazioni. Implementa, acquisisci uno screenshot, confronta e regola. Due o tre cicli rappresentano la norma e il risultato dovrebbe migliorare a ogni passaggio.
- Rendi la verifica parte della definizione di "completato". Le istruzioni risiedono in
CLAUDE.md. Esegui i test prima di dichiarare completata un'attività e mostrarne l'output. - Infine, il ciclo stesso deve essere protetto, perché un agente che corregge il codice non deve avere la possibilità di indebolire il controllo su quel codice. Un hook che blocca le modifiche ai file di test durante un'attività di correzione ottiene questo risultato. In alternativa, è possibile verificare il diff in fase di revisione e rifiutare qualsiasi modifica che riguardi un test.
Come si presenta (il blocco di verifica in CLAUDE.md)
## Verifying your work

- Build: make build (must finish with "Build succeeded")
- Test: make test (all green; never skip or delete a failing test)
- Lint: make lint (zero warnings)

Run all three before reporting any task complete, and paste the output.
If a test fails, fix the code, not the test.Eval continue nella CI
Le eval sono l'equivalente nativo IA del controllo qualità stage-gate. In pratica, si tratta di una suite che viene eseguita ogni volta che cambia la configurazione dell'agente. Quando viene introdotto un nuovo modello o riscritto un prompt, la suite di valutazione indica se l'agente continua a svolgere il lavoro con lo stesso livello qualitativo.
Le eval dovrebbero essere considerate come una suite dinamica. Con il miglioramento dei modelli, i casi che un tempo discriminavano smettono di farlo e occorre aggiungerne di nuovi, derivanti dal monitoraggio continuo.
A seconda del caso d'uso, alcuni team potrebbero preferire l'esecuzione offline di queste eval secondo una cadenza prestabilita, anziché a ogni modifica. I passaggi seguenti riguardano le valutazioni continue.
Come si procede con l'esecuzione
- Il membro del team di ingegneria della piattaforma raccoglie dalle 20 alle 50 attività reali tratte dal lavoro recente, ciascuna con il relativo risultato atteso o accettato.
- Scrivi ogni attività come un'eval, ovvero il prompt associato ai controlli che definiscono ciò che è accettabile (superamento dei test, nessun errore di linting, comportamento inalterato, rispetto delle policy).
- La suite viene eseguita in modalità non interattiva nella CI con cadenza programmata e a ogni modifica a
CLAUDE.md, alle Skills o agli hook, poiché questa configurazione guida l'agente e merita lo stesso test di regressione riservato al codice. - Vincola le modifiche della configurazione ai risultati. La modifica a una Skill che comporta una riduzione della percentuale di superamento viene rivista prima del merge.
- Ogni incidente di produzione prevede un'eval, redatta dal team responsabile dell'incidente, e rimane nella suite come test di regressione.
Come si presenta (.github/workflows/agent-evals.yml)
name: Agent evals
on:
  pull_request:
    paths: ['CLAUDE.md', '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: Run eval suite
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
Considerazioni sulla governance
Le eval offrono al QA un gate che sta al passo con l'output dell'agente. La soglia di superamento viene imposta come controllo di merge, le esecuzioni vengono registrate per consentire il confronto dei risultati nel tempo e il team responsabile della modifica alla configurazione l'approva.
L'IA nel ciclo di revisione delle PR
Claude fornisce e riceve revisioni. Esamina le PR in arrivo verificandone la conformità alle policy dell'organizzazione e gestisce i commenti di revisione sulle proprie PR. In questo modo, il team di sviluppo può concentrarsi sul comportamento durante la revisione delle PR, riducendo l'attività alla valutazione dell'intento e del rischio.
Come si procede con l'esecuzione
- Il servizio gestito di Code Review è il modo più rapido per iniziare. Un amministratore lo abilita e seleziona i repository. Esegui la revisione nella CI interna tramite claude-code-action quando hai bisogno di controllare la pipeline o vuoi instradare le chiamate API attraverso il tuo contratto cloud (il play CI/CD descrive questa infrastruttura).
- Il responsabile tecnico redige la policy di revisione sotto forma di file
REVIEW.mdnella radice del repository, suddivisa nei passaggi di interesse per l'organizzazione: bug ed errori logici, sicurezza e vulnerabilità, conformità rispetto alle specifiche (spec.mddel play dei requisiti), al piano di implementazione (plan.mddel play relativo alla modalità di pianificazione) e ai principi di progettazione.Il file REVIEW.mddefinisce inoltre ciò che rientra tra gli aspetti importanti rispetto alle osservazioni minori e gli elementi da ignorare. - Il responsabile tecnico stabilisce la soglia di intervento umano. I risultati non approvano né bloccano autonomamente una PR e la protezione dei branch richiede comunque l'approvazione di un code owner. Un membro del team di ingegneria della piattaforma che desideri vincolare i merge ai risultati può leggere i conteggi di gravità pubblicati dall'esecuzione del controllo sotto forma di riepilogo leggibile da una macchina.
- Quando il revisore o l'autore tagga
@claudein un commento di revisione, Claude prende in carico il commento ed esegue il push della correzione. Il thread della PR registra sia la richiesta che la modifica. Questo ciclo di correzione viene eseguito utilizzando claude-code-action. Nel servizio gestito, l'inserimento di un commento con@claude reviewrichiede invece una nuova revisione. Per le PR aperte da Claude, è possibile spingersi oltre e lasciare che Claude se ne occupi fino al merge. I team racchiudono il ciclo in un comando slash personalizzato che passa in rassegna i commenti di revisione non risolti e i controlli falliti sulla PR, li gestisce e invia le correzioni, finché la PR non risulta verde e in attesa della sola approvazione del code owner. - I risultati delle revisioni alimentano il file
CLAUDE.md. Quando una revisione segnala un errore per la seconda volta, la correzione viene inserita inCLAUDE.mdnell'ambito di quella stessa revisione e, poiché la revisione leggeCLAUDE.md, l'errore viene rilevato a partire dalla PR successiva. La revisione segnala inoltre quando una modifica ha reso obsoletoCLAUDE.md. - Una volta al mese, il responsabile tecnico ottimizza la configurazione valutando i risultati, in modo che il revisore migliori, e limitando la quantità delle osservazioni minori nel file
REVIEW.md. I percorsi generati e tutto ciò che viene già verificato dalla CI sono esclusi.
Come si presenta (REVIEW.md)
# Review instructions

## Passes
Run three passes and tag each finding with its pass:
- Bugs: logic errors, broken edge cases, subtle regressions
- Security: injection risks, authentication gaps, PII in logs
- Compliance: the change matches spec.md, plan.md and our design principles

## What Important means here
Reserve Important for findings that would break behavior, leak data
or breach a policy. Style and naming are nits.

## Cap the nits
Report at most five nits per review; summarize the rest as a count.

## Do not report
Generated files under src/gen/ and anything CI already enforces.
Considerazioni sulla governance
La separazione dei compiti è mantenuta, poiché l'agente che ha scritto il codice non ha modo di approvarlo. La policy di revisione definita in REVIEW.md si applica a tutte le PR, e risultati, correzioni, valutazioni e approvazioni vengono registrati nella cronologia della PR, che funge così da registro di audit. L'approvazione è prerogativa di un essere umano attraverso la protezione dei branch, sulla base dei risultati emersi.
Per scoprire come questi controlli si combinano su scala di produzione, consulta come mettere in sicurezza un SDLC nativo IA in Anthropic.
Gli hook come gate di approvazione
La fase di build ha utilizzato gli hook come barriere di protezione per consentire o bloccare le azioni senza intervento umano (Fase 3: Sviluppo). Un hook può anche formulare una richiesta, sospendendo l'azione finché una persona specifica non fornisce l'approvazione, meccanismo necessario per la gestione dei rilasci.
Questo play si colloca nella Fase 5: Distribuzione perché il punto di controllo dei rilasci ne è l'esempio più evidente, ma gli hook non sono specifici della distribuzione: operano ovunque Claude interviene. Ad esempio, possono bloccare le modifiche alle migrazioni e all'infrastruttura in assenza di un ticket di modifica durante la Fase 3: Sviluppo e impedire all'agente di modificare i file di test durante un'attività di correzione nella Fase 4: Test.
Come si procede con l'esecuzione
- La direzione tecnica, insieme ai team di gestione del cambiamento e conformità, definisce i punti di approvazione umana che devono essere mantenuti, come la validazione della gestione del cambiamento, l'autorizzazione al rilascio e le modifiche ai percorsi protetti.
- Il membro del team di ingegneria della piattaforma esprime ogni gate sotto forma di hook, ossia uno script eseguito prima che Claude intervenga, in grado di consentire, richiedere o bloccare l'operazione.
- Gli hook di team vengono inseriti in
.claude/settings.jsonall'interno di git, mentre quelli non negoziabili risiedono nelle impostazioni gestite, di competenza dell'amministratore di piattaforma o IT, dove i singoli membri del team di sviluppo non possono disattivarli. - Un blocco dovrebbe essere autoesplicativo, quindi quando un hook interrompe un'azione, il motivo e la procedura per ottenere l'approvazione compaiono nell'output di Claude.
Come si presenta (.claude/settings.json)
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "Bash",
          "hooks": [
            { "type": "command",
              "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
          ]
        }
      ]
    }
}
E il gate vero e proprio (.claude/hooks/production-gate.sh)
#!/bin/bash
# Production deploys require a named release authorization
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
   if [ -z "$RELEASE_APPROVAL" ]; then
     echo "Production deploys need a release authorization." >&2
     exit 2 # exit 2 blocks the action; the message goes to Claude
   fi
fi
exit 0
Considerazioni sulla governance
Gli hook fungono da gate di approvazione. La condizione di controllo viene applicata ogni volta, per chiunque. Le decisioni di autorizzazione e blocco vengono registrate con un timestamp. Il gate definisce inoltre cosa costituisce approvazione, che si tratti della convalida di un ticket di modifica o dell'autorizzazione di chi gestisce i rilasci.
Integrazione CI/CD e distribuzione
Esegui Claude Code in modalità non interattiva all'interno della pipeline CI/CD, isola l'esecuzione in una sandbox per garantire la sicurezza degli agenti di lunga durata, esponi la distribuzione tramite integrazioni MCP e collauda i percorsi di rollback prima ancora che l'agente ne abbia necessità.
Come si procede con l'esecuzione
- Il membro del team di ingegneria della piattaforma inizia con passaggi di valutazione in sola lettura. Utilizza
claude -pin un job della pipeline per effettuare il triage di una build non riuscita, riassumere un test instabile o redigere il registro delle modifiche. - Aggiungi operazioni di scrittura a valle dei gate esistenti per attività come la risoluzione dei problemi di linting, l'aggiornamento della documentazione generata o la gestione dei commenti di revisione tramite le menzioni
@claude. Qualsiasi contenuto scritto dall'agente arriva sotto forma di PR attraverso la protezione dei branch e l'agente non ha un percorso diretto per effettuare il push su main. - L'esecuzione viene isolata in una sandbox. I job dell'agente vengono eseguiti in container soggetti a una policy di rete, con token di breve durata e ambito limitato e per impostazione predefinita non dispongono di credenziali di produzione.
- Esponi la distribuzione tramite MCP. Le operazioni di distribuzione, verifica dello stato e rollback diventano degli strumenti, circoscritti per singolo ambiente, in modo che le capacità di distribuzione dell'agente si basino su un elenco consentito anziché su uno script di shell dotato di credenziali.
- L'autonomia viene suddivisa in livelli in base all'ambiente. In fase di sviluppo, l'agente viene distribuito liberamente. In fase di produzione, l'agente prepara il rilascio e chi è responsabile dei rilasci lo autorizza, mentre un hook impone il rispetto del gate di produzione. Lo staging si colloca in una posizione intermedia.
- Il rollback dovrebbe rappresentare il percorso più collaudato della pipeline: un singolo comando eseguibile dall'agente e testato regolarmente nell'ambiente di staging. Il play di chiusura del ciclo (Fase 6: Manutenzione) richiama questa procedura di rollback in caso di violazione di una banda di controllo, pertanto deve essere dimostrata in anticipo.
Come si presenta (passaggio della pipeline)
- name: Triage failed build
  if: failure()
  run: >
    claude -p "Read the build log at out/build.log. Identify the most
    likely cause, say whether the failure looks flaky or real, and write a
    three-line summary for the PR thread." >> triage.md
Considerazioni sulla governance
Il principio guida prevede che l'agente possa operare fino al gate di produzione senza poterlo superare. I controlli descritti di seguito applicano questo principio.
- La protezione dei branch trasforma qualsiasi contenuto scritto dall'agente in una PR, escludendo percorsi diretti verso main.
- L'hook di distribuzione in produzione blocca il rilascio fino all'autorizzazione esplicita da parte di chi ha la responsabilità dei rilasci. Ogni esecuzione non interattiva opera sotto l'identità specifica dell'agente, consentendo al log della pipeline di distinguere le azioni compiute dall'agente da quelle eseguite dal membro del team di sviluppo che l'ha attivato.
- I livelli di autorizzazione per ambiente definiscono le azioni consentite all'agente lungo il percorso verso il gate.
Manutenzione e chiusura del ciclo
Finora abbiamo esaminato come integrare Claude in ogni passaggio del processo SDLC, in cui ogni fase richiede l'intervento umano per l'avvio dei passaggi iniziali. Questa fase, invece, sposta l'attenzione sull'esecuzione autonoma di Claude per chiudere il ciclo.
Ad esempio, un agente di monitoraggio in esecuzione continua potrebbe, in seguito all'apertura di un ticket di bug, generare un file intent.md e attraversare le fasi dei requisiti, pianificazione, sviluppo, test e revisione. La Fase 6: Manutenzione viene eseguita in modalità headless, avvalendosi di un gate di affidabilità indipendente tra una fase e l'altra, un controllo deterministico o un agente di revisione avversario, per stabilire se l'output della fase precedente debba proseguire o venire inoltrato a un essere umano.
Completamento del ciclo
Uno script deterministico monitora la produzione e richiama Claude quando viene violata una banda di controllo. Il monitoraggio di una violazione è un utile esempio del modello di funzionamento autonomo del ciclo, mentre la sezione dedicata a Claude Tag, in versione beta pubblica, al termine della fase descrive la gestione del lavoro proveniente da canali diversi.
Come si procede con l'esecuzione
- Il proprietario del servizio o il membro del team di ingegneria della piattaforma sceglie una metrica con una baseline stabile basata su una finestra temporale mobile, come la percentuale di insuccesso dei test di CI, il tasso di errori 5xx post-distribuzione o il tempo di ciclo delle PR.
- Viene scritto lo script di rilevamento, basato in genere su media e deviazione standard su una finestra mobile con regole specifiche, come il metodo Western Electric o analoghi, affinché le bande intercettino sia le derive progressive che i picchi. Lo script è sottoposto a controllo di versione e a unit test; il rilevamento rimane completamente deterministico, senza il coinvolgimento di alcun modello.
- I livelli di risposta sono definiti in una configurazione soggetta a controllo di versione (il file
bands.yamldi seguito). In corrispondenza di 1σ, lo script si limita a registrare l'evento, a 2σ richiama Claude in sola lettura per effettuare una diagnosi e a 3σ Claude è autorizzato ad agire, sebbene esclusivamente aprendo una PR nel gate di revisione o attivando un runbook preapprovato. - Il livello di trigger può consistere in un flusso di lavoro pianificato in GitHub o GitLab, in un webhook proveniente dallo stack di monitoraggio esistente o in un Cron Job interno alla rete. Claude viene eseguito in modalità stateless, come passaggio non interattivo su un runner di CI o come servizio Agent SDK all'interno di un container in sandbox. Il play CI/CD descrive le opzioni di distribuzione e di accesso ai modelli. Dato che l'esecuzione è stateless e non interattiva, un ciclo può iniziare e concludersi senza che nessuno lo avvii.
- L'agente redige la propria diagnosi come file
intent.mdnel formato della Fase 1: Pianificazione, descrivendo l'anomalia e le relative evidenze, un esito proposto, i sistemi interessati ed eventuali questioni aperte. Da quel momento, il risultato attraversa la pipeline come qualsiasi altro elemento. - Il proprietario del servizio o il membro del team di sviluppo di turno effettua il triage della coda, inoltrando al product owner le conclusioni relative al prodotto. Correggi immediatamente, pianifica o ignora. Le azioni di scarto calibrano le bande e contribuiscono a ridurre il rumore.
- Quando viene rilasciata una correzione, aggiungi un'eval per l'incidente (il play delle valutazioni continue) per prevenire adeguatamente problematiche simili in futuro.
Come si presenta (ad esempio, un file bands.yaml per il monitoraggio della percentuale di insuccesso dei test di CI)
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: { action: log }
  2sigma: { action: diagnose,
            tools: "Read,Grep,Bash(gh run view *)" }
  3sigma: { action: propose,
            routes: [pull_request, runbook:rollback-deploy] }
Considerazioni sulla governance
I limiti dei livelli sono imposti da una configurazione soggetta a controllo di versione, in cui le autorizzazioni e le impostazioni gestite inibiscono l'accesso alla produzione. Invocazioni, risultati e decisioni di triage vengono registrati con un timestamp. Il proprietario del servizio effettua il triage e approva i risultati, le modifiche che ne derivano passano attraverso il normale gate di revisione delle PR e i runbook attivabili dall'agente sono stati preventivamente approvati.
Esempi
- Quando la percentuale di insuccesso dei test di CI supera la soglia di 3σ, l'agente mette in quarantena il test instabile o apre una PR di ripristino e il gate di revisione decide.
- Quando il tasso di errori 5xx post-distribuzione supera 3σ con una distribuzione nella finestra temporale, l'agente attiva la pipeline di rollback esistente.
- Quando il tempo di ciclo delle PR fa scattare una regola di deriva, l'agente redige un report per la direzione tecnica, dimostrando l'efficacia dell'harness sia per le metriche di processo che per quelle di produzione.
Scansioni periodiche della codebase
Una scansione di sicurezza è un'istantanea valida in un determinato momento su una codebase analizzata da un modello specifico, soggetta a obsolescenza per una duplice ragione: il codice cambia ogni settimana e ogni generazione di modelli individua vulnerabilità sfuggite a quella precedente. La risposta nativa IA consiste nell'eseguire la scansione secondo una pianificazione prestabilita, senza alcun intervento umano nel percorso di invocazione, incanalando i risultati attraverso gli stessi gate previsti per qualsiasi altra modifica alla codebase.
Claude Security è la versione in hosting della scansione pianificata. Collegando un repository GitHub, le scansioni vengono eseguite su Claude Mythos 5 nell'infrastruttura di Anthropic; ciascun risultato viene convalidato prima di essere notificato e viene associato a una valutazione di affidabilità. Le patch suggerite vengono riviste e applicate in Claude Code sul web. L'organizzazione ottiene i risultati senza dover accedere al modello.
Come si procede con l'esecuzione
- Chi è responsabile della sicurezza collega i repository organizzandoli in progetti suddivisi per repository, servizio o team, in modo che la titolarità dei risultati risulti chiara fin dall'inizio.
- Esegui una prima scansione completa dei repository più critici, compresi quelli già analizzati in precedenza da altri strumenti o modelli antecedenti. Considera la prima scansione come base di riferimento. Probabilmente farà emergere criticità in porzioni di codice prima ritenute pulite.
- Definisci una pianificazione per progetto. Una cadenza settimanale è un'impostazione predefinita ragionevole per i servizi in fase di sviluppo attivo; per repository di grandi dimensioni o eterogenei, circoscrivi le scansioni a una specifica directory o a un branch.
- Effettua il triage dei risultati avvalendoti della valutazione di affidabilità. Scarta indicando un motivo, in modo che l'esclusione venga registrata e lo stesso risultato non venga riproposto come nuovo alla scansione successiva.
- Per le criticità circoscritte, apri la patch suggerita in Claude Code sul web, revisionala e inviala attraverso il gate di revisione delle PR al pari di qualsiasi altra modifica. L'agente che ha proposto la correzione non dispone di alcun percorso per approvarla.
- Per problematiche di portata superiore a una singola patch, come una vulnerabilità architetturale o un pattern ripetuto tra diversi servizi, scrivile in un file
intent.mdnel formato della Fase 1 per avviarne la gestione dalla Pianificazione. - Quando una correzione viene rilasciata in produzione, aggiungi alla suite del play delle valutazioni continue un'eval relativa a quella classe di vulnerabilità, in modo che da quel momento in poi la configurazione che guida l'agente venga testata rispetto a quella classe.
- Esporta i risultati in formato CSV o Markdown oppure utilizza i webhook, per mantenere i sistemi di tracciamento e audit esistenti dell'organizzazione come sistema di riferimento nel punto in cui gli auditor si aspettano già di trovarli.
Considerazioni sulla governance
La scansione viene eseguita secondo i controlli amministrativi dell'organizzazione, il che significa che il collegamento dei repository, l'assegnazione delle postazioni di scansione e il limite di spesa sono tutti definiti a livello centrale. Ogni riscontro ha un risultato di convalida e una valutazione di affidabilità e ogni elemento ignorato ha una motivazione, quindi la cronologia delle scansioni costituisce una traccia di audit di ciò che è stato rilevato, corretto e consapevolmente accettato.
Le correzioni raggiungono la produzione attraverso il gate di revisione delle PR e la protezione dei branch, anziché direttamente dalla scansione stessa. Claude Security potenzia le analisi statiche esistenti e la scansione delle dipendenze. I controlli deterministici rimangono attivi nella CI, mentre la scansione guidata dal modello gestisce le vulnerabilità dipendenti dal contesto che questi controlli non sono progettati per individuare.
Claude disponibile con Claude Tag
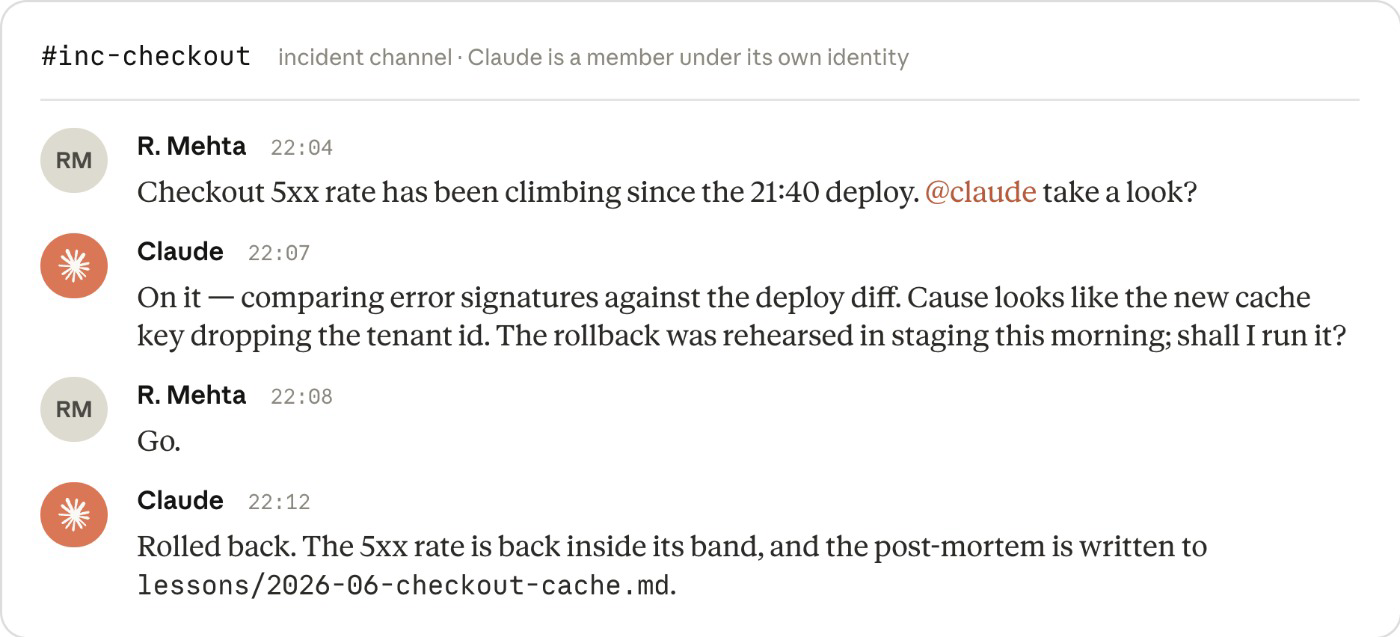
Gli incidenti possono presentarsi anche attraverso canali differenti, come le app di comunicazione aziendale, ad esempio Slack o Teams. Un incidente può manifestarsi sotto forma di messaggio su Slack inviato alle 22:00 per richiedere una correzione urgente in un canale dedicato, rendendo ora possibile un intervento immediato. Claude Tag (in versione beta pubblica attualmente disponibile in Slack) integra Claude come membro di quei canali sotto la propria identità; in tal modo, ogni nuovo incidente dispone di un addetto alla prima risposta e la risposta stessa diventa parte del ciclo e della memoria per futuri incidenti.
La conversazione e la conoscenza istituzionale rimangono all'interno del canale, consentendo a chiunque vi partecipi di guidare la risposta e metterla in atto. Qualsiasi membro del team può verificare ipotesi, esplorare nuove opzioni e svolgere indagini in tempo reale, beneficiando della cronologia del canale a supporto della verificabilità. Tramite l'accesso a MCP, Claude verifica il ripristino della metrica al valore di riferimento confermandolo nel thread, quindi redige il post-mortem in un file di lezioni apprese sottoposto a controllo di versione, consultabile in occasione di future indagini.
Gli incidenti non sono l'unico ambito di intervento di Claude Tag. Se viene taggato su un ticket tramite MCP o se viene interpellato nel canale, Claude esegue il triage del lavoro con le medesime modalità. Una correzione di dimensioni ridotte e ben circoscritta giunge come PR attraverso il gate di revisione, mentre le attività di portata superiore vengono formalizzate in un file intent.md per la Fase 1: Pianificazione, momento in cui il ciclo inizia ad autoalimentarsi. Consulta: come Claude Tag gestisce l'on-call per la CI/CD presso Anthropic.
Considerazioni finali
Modelli e harness si sono evoluti, consentendo alle organizzazioni di trasformare non soltanto le modalità di produzione del codice, ma l'intero ciclo di vita dello sviluppo software.
Questa trasformazione mantiene il giudizio umano al centro del processo e tiene conto dei requisiti di governance e di conformità normativa delle grandi organizzazioni aziendali.
Questa guida ha raccolto molte delle best practice reali che il nostro team di IA applicata mette in atto ogni giorno per i nostri clienti; ci auguriamo di averti fornito una risorsa pratica e immediatamente utilizzabile.
Risorse e ringraziamenti
La documentazione seguente fornisce al team di piattaforma le informazioni necessarie per configurare questi controlli, indicativamente secondo l'ordine di implementazione ottimale.
Un ringraziamento a Jim Blackhurst, Will Steuk e Jamal Arif per aver contribuito a questa guida, ispirata e basata su gran parte del loro lavoro precedente.