Manual de estrategias de SDLC nativo de IA
Cómo transformar el ciclo de vida de desarrollo de software con la IA, etapa por etapa.
El código ya no es el cuello de botella
Las organizaciones han empezado a usar la IA para escribir código a una velocidad impensable hace un año, pero los procesos relacionados con él no han cambiado al mismo ritmo.
Muchos equipos de ingeniería siguen con las mismas puertas de aprobación, revisiones, traspasos y políticas, lo que retrasa las ganancias de productividad logradas mediante el uso de soluciones de agentic coding como Claude Code.
El ciclo de vida de desarrollo de software (SDLC) es el proceso que lleva el software de la idea a la producción. La mayoría de las organizaciones ejecutan alguna versión de las mismas seis etapas, que abarcan la planificación, el diseño, la creación, las pruebas, la implementación y el mantenimiento del software. Tradicionalmente, cada etapa es una fase independiente y pertenece a un rol diferente. Los responsables de producto escriben los requisitos, los arquitectos técnicos los convierten en diseños, los ingenieros crean los diseños, los equipos de control de calidad de las empresas reguladas lo verifican, los equipos de lanzamientos lo envían y el departamento de operaciones supervisa lo que se ejecuta. El trabajo se mueve de una fase a otra a través de documentos, tickets y aprobaciones.
El ciclo de vida de desarrollo de software tradicional (SDLC) requiere muchos procesos, lo que garantiza la responsabilidad y el control en cada paso. Sin embargo, el SDLC tradicional se diseñó para maximizar la eficiencia en una era en la que la etapa más lenta y costosa era escribir e implementar código, lo cual ya no es el caso. Los PRD, los rituales de estimación y las revisiones de seguridad de los productos existían para forzar la alineación durante lo que podían ser semanas, meses o trimestres de trabajo de desarrollo.
El SDLC tradicional también cuenta con controles que suponen que cada paso es realizado por humanos. Las organizaciones que generan más valor han rediseñado su proceso en torno a lo que la IA agéntica puede hacer ahora, asegurándose de que los humanos se mantengan al día. En esta guía, repasamos varias de las mejores prácticas de nuestro equipo de IA aplicada para integrar a Claude internamente en cada etapa del SDLC para acelerar el desarrollo y agilizar los procesos, inspiradas en el trabajo con nuestros clientes.
Cuando el código ya no es el cuello de botella y la fase de creación se ejecuta más rápido de lo que permite el SDLC tradicional, tres cosas se hacen realidad:
- El cuello de botella se traslada a los pasos situados a la izquierda y a la derecha de la fase de compilación. Consisten principalmente en planificar, revisar/probar y desplegar, que todavía se ejecutan a velocidad humana.
- Los controles dejan de corresponder a la realidad y se vuelven insolubles. Revisar cada línea a mano tenía sentido cuando una persona la había escrito, pero no puede mantenerse una vez que los agentes escriben la mayor parte de la diferencia.
- Los costes de gobernanza aumentan porque las excepciones siguen derivándose de reuniones y comités que se reúnen semanal o mensualmente.
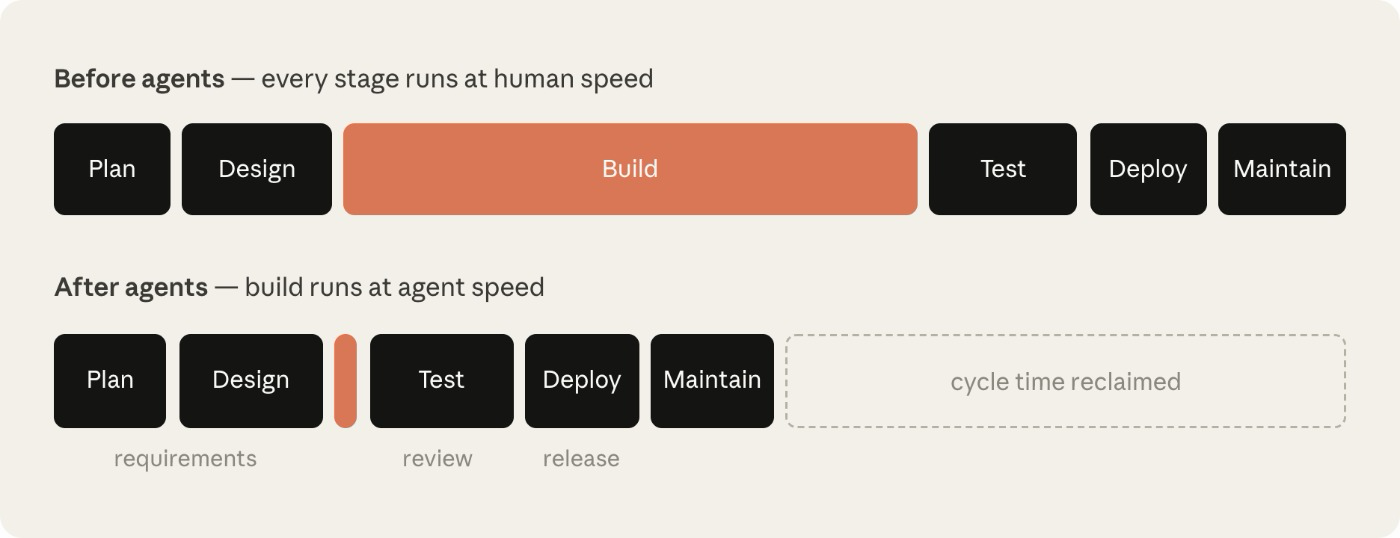
Tomemos un cuello de botella de seguridad como ejemplo. Los equipos de seguridad están diseñados para el trabajo humano, así que cuando los agentes multiplican el trabajo de código, la cola de revisión se crea o el código se envía infrarrevisado. Una organización regulada no puede aceptar ninguno de los dos resultados, por lo que sus verificaciones de seguridad y políticas deben mantenerse al ritmo de las de los agentes.
Para aprovechar mejor las ganancias de productividad y proteger la IA agéntica, el ciclo de vida tradicional de SDLC requiere el mismo nivel de transformación que el que ha sufrido la fase de implementación.
¿Qué es un SDLC nativo de IA?
El SDLC nativo de IA es un proceso reinventado que combina los antiguos objetivos de control con la nueva aplicación. En lugar de ser un flujo lineal, el proceso se convierte en un bucle, y la IA se integra en cada punto. El SDLC nativo de IA promueve la transferencia automatizada y la activación de las siguientes versiones, lo que ayuda a abordar la naturaleza manual y torpe de la transferencia entre las fases del SDLC tradicional.
También se oirá que este cambio se denomina SDLC agéntico, SDLC de IA o simplemente desarrollo de software agéntico; las etiquetas difieren, pero describen lo mismo.
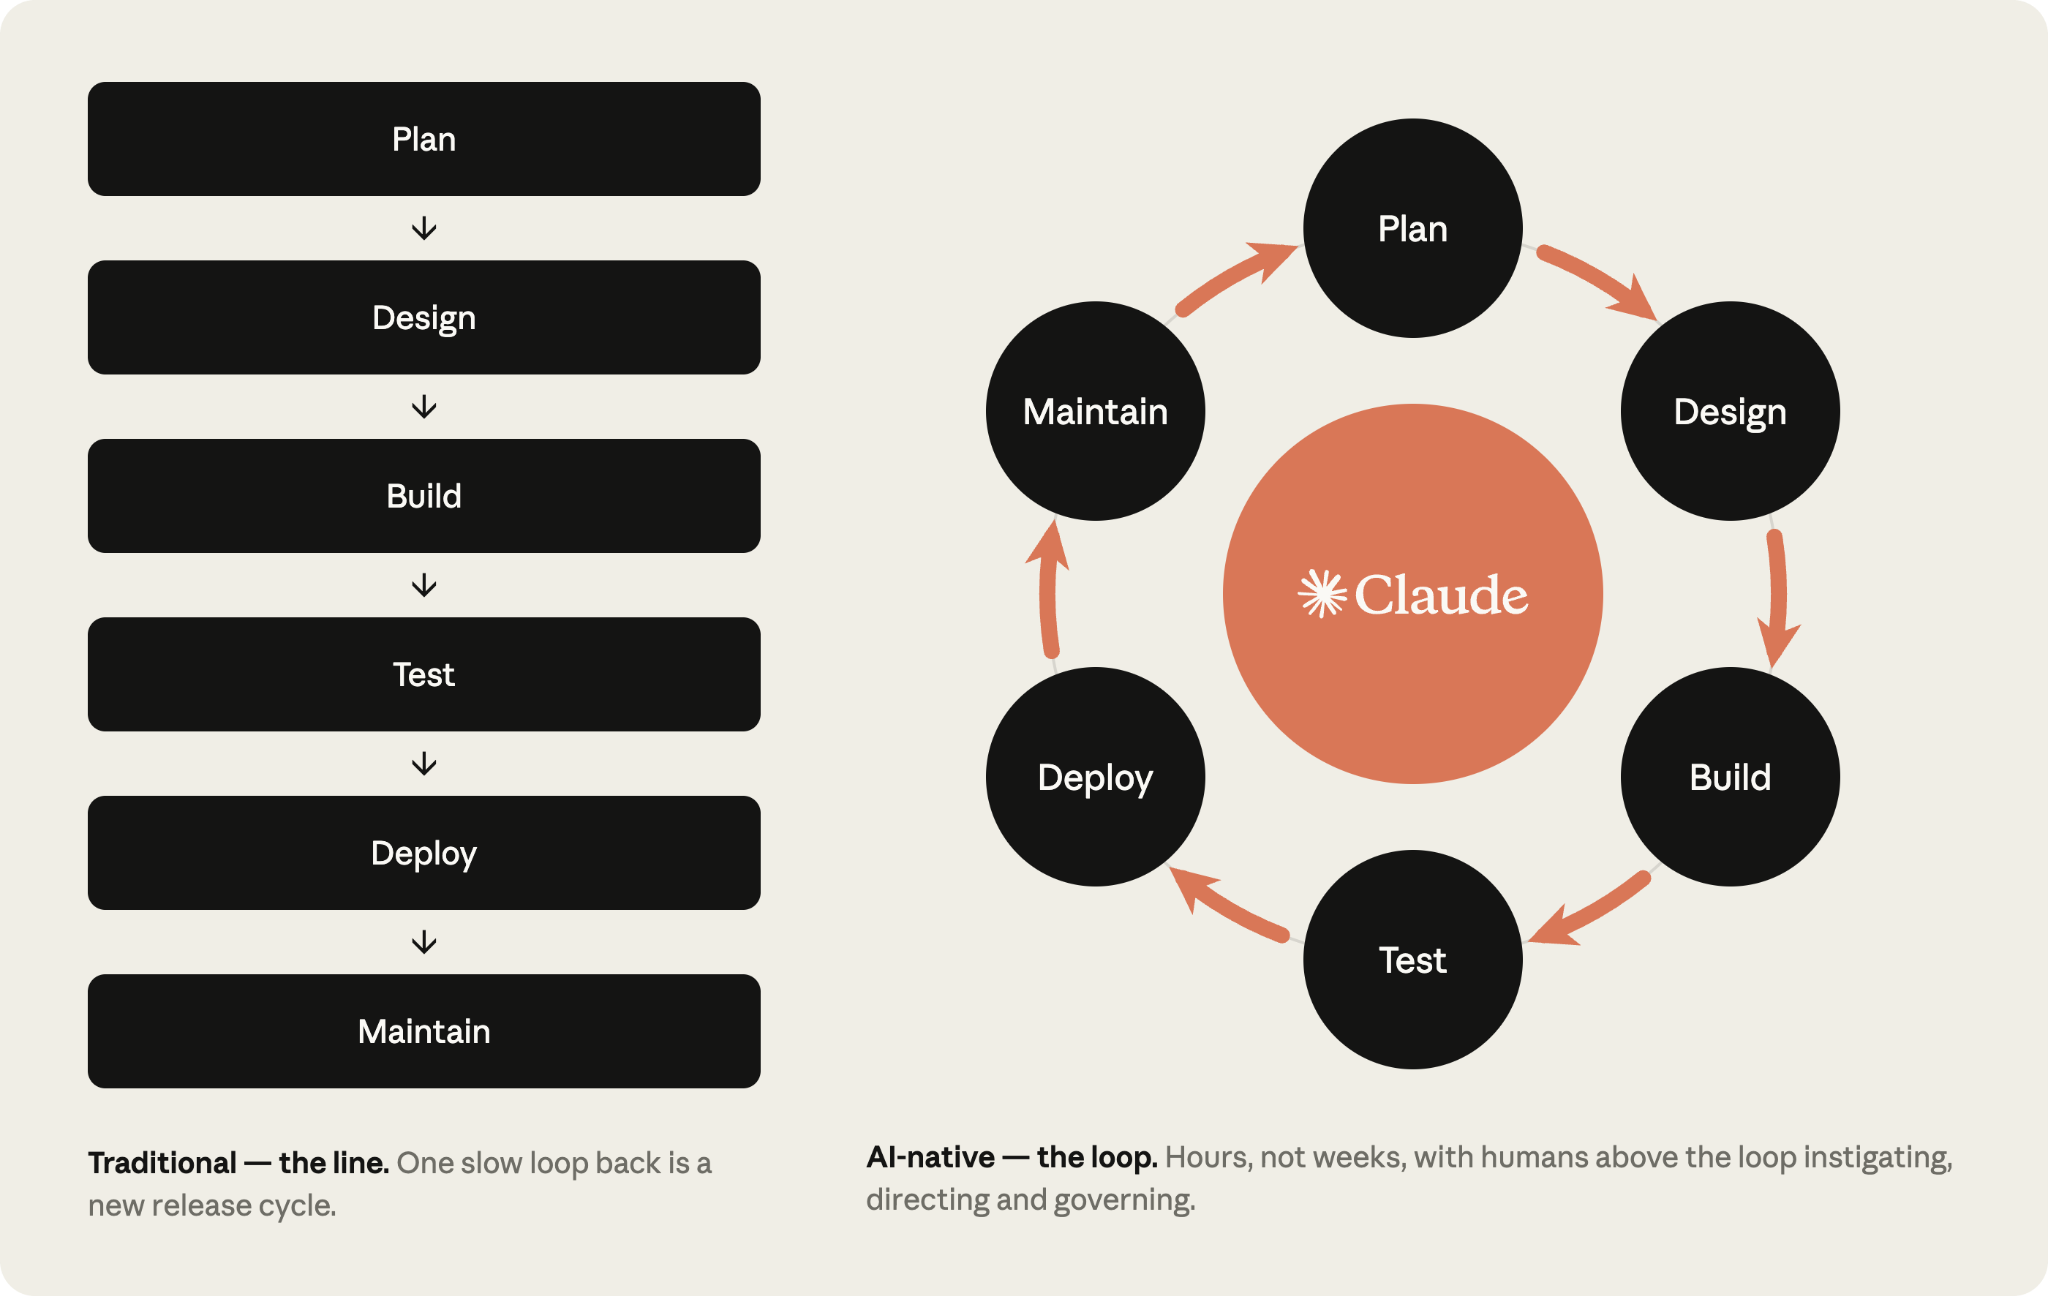
Los cambios en las seis etapas de un SDLC nativo de IA
La tabla siguiente destaca los extremos del espectro entre SDLC tradicional y SDLC nativo de IA, apoyado por Claude. La mayoría de las organizaciones se sitúan en algún lugar entre ambas columnas.
El hilo que pasa por la columna de la derecha es el artefacto comprometido. Cada etapa finaliza escribiendo uno para el control de versiones (incluidos intent.md, spec.md, plan.md, el cambio y sus pruebas, el PR con sus conclusiones de la revisión y el registro de incidentes) y la siguiente etapa comienza con su lectura. Para las primeras etapas, los archivos .md son el artefacto predominante, porque un propietario de producto y un agente pueden leer el mismo archivo y actuar sobre él. Desde Build en adelante, el artefacto es el código y sus registros. La cadena de commits es también la pista de auditoría: quién pidió qué, qué produjo el agente y quién lo aprobó.
Los humanos siguen siendo responsables de cada decisión que requiera un juicio personal. En el mundo del SDLC agéntico, la atención humana cambia junto con los artefactos que deben revisarse.
Piezas
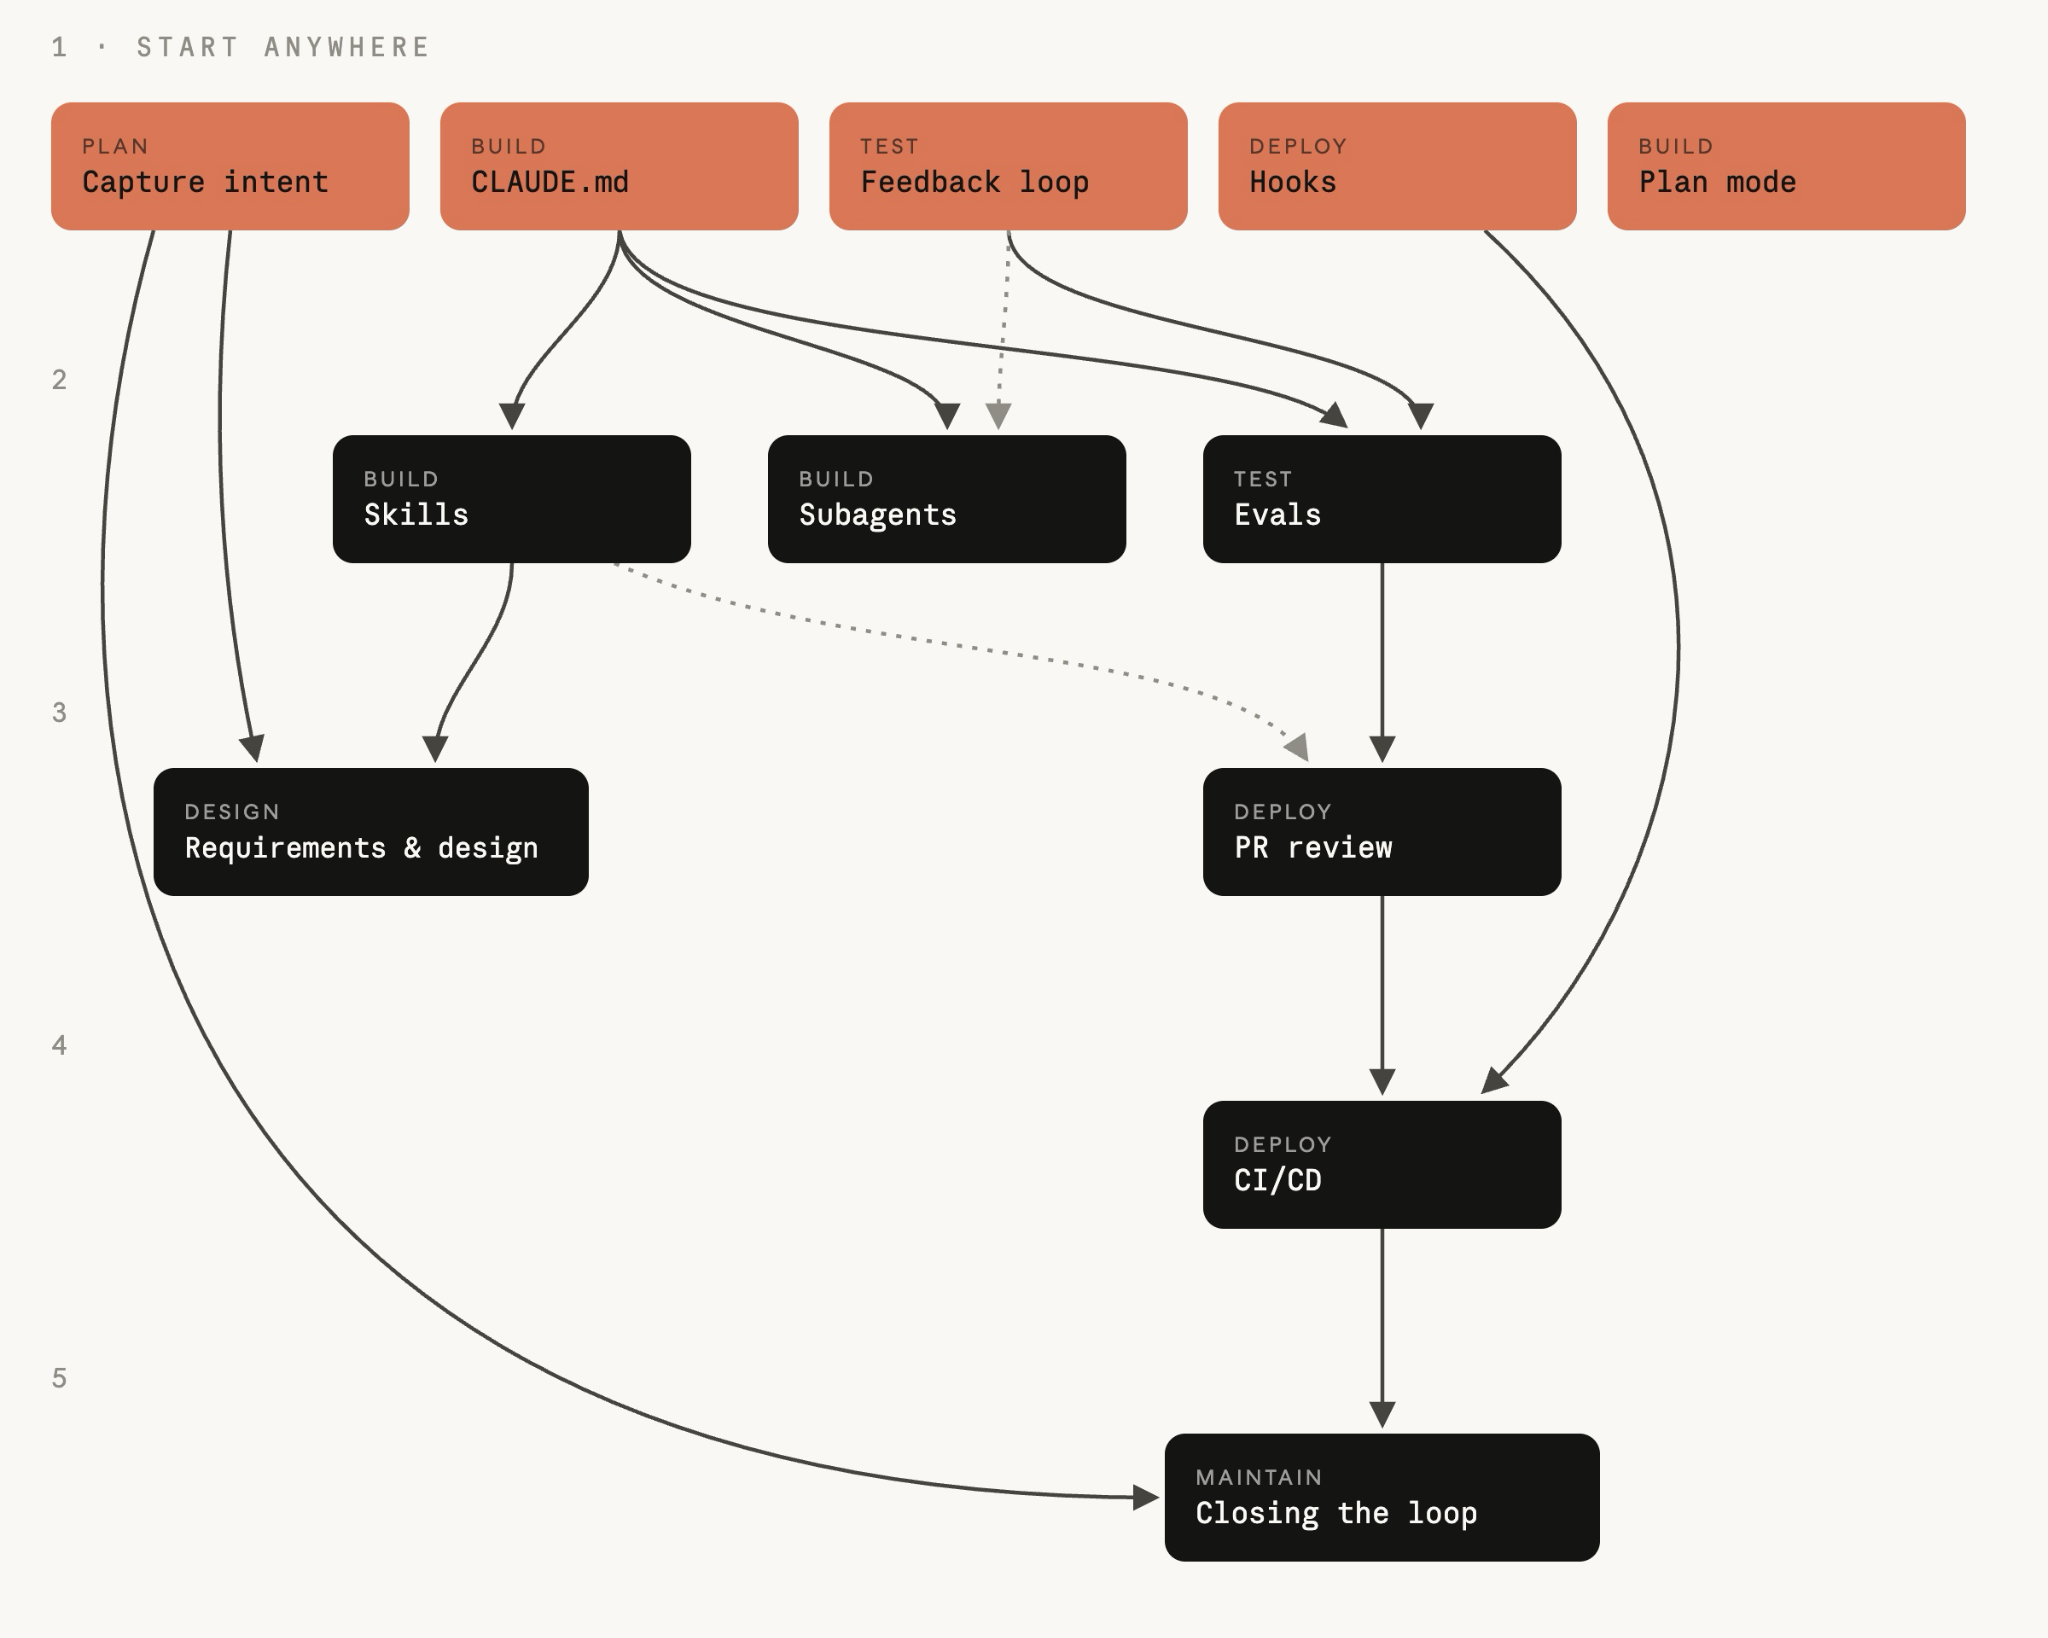
Las piezas constituyen el núcleo del manual de estrategias y se agrupan en seis etapas no lineales (Planificación, Diseño, Creación, Pruebas, Implementación, Mantenimiento), que en conjunto cubren el ciclo de vida completo.
Cada pieza cubre:
- Qué cambia;
- Primeros pasos;
- Pasos concretos para la implementación;
- Consideraciones de gobernanza y
- Cómo medir si funcionó.
Los pasos son modulares y las organizaciones pueden optar por priorizar la transformación de diferentes etapas en diferentes momentos en función de sus necesidades específicas. Cada juego enumera sus dependencias en “Requisitos previos”, que el gráfico de dependencias ilustra con más detalle.
Una etapa finaliza con la confirmación de un artefacto y el commit inicia la siguiente fase. Un intent.md aceptado activa los requisitos y el diseño se aprueba, un spec.md aprobado activa el modo plan, un PR fusionado activa el pipeline y una banda de control violada en producción escribe el siguiente intent.md y así el bucle continúa.
Primero, se solicita cada paso a mano y el estado final es un bucle en el que cada artefacto aceptado activa la siguiente puerta. La atención humana se concentra en las puertas, revisando lo que el agente ha señalado en lugar de empezar cada etapa de cero.
Captura como intent.md
El intent.md, que da el inicio al proceso de desarrollo de software, puede entrar por diferentes vías. Una persona tiene una idea, se presenta un ticket o se denuncia un incidente a través de una alerta (véase Etapa 6: Mantenimiento).
Cuando alguien tiene una idea, intercambia ideas con Claude y produce un prototipo de markdown. En el SDLC tradicional, la misma persona debe convencer a un miembro del equipo de producto para que escriba la idea con ellos o en su nombre.
La protoespecificación generada por Claude es legible para humanos, está sujeta a control de versiones y puede utilizarse de inmediato para la siguiente fase. La protoespecificación se guarda como intent.md.
Independientemente de si el intent se origina en un desencadenador de evento o en un agente, se aplican los mismos pasos: el propietario del producto revisa y corrige el intent.md escrito por el agente antes de que se confirme.
Configurar esto es una tarea única para la plataforma o el equipo de ingeniería. Un miembro del equipo técnico debe declarar el intent y decidir quién puede responder, ya que muchos colaboradores procederán de toda la organización.
Una vez que el repositorio existe, los colaboradores sin experiencia en git no necesitan usar git directamente. En su lugar, un conector al sistema de control de versiones (por ejemplo, GitHub) permite a Claude hacer commit de archivos de markdown en su nombre desde claude.ai o Cowork.
Cómo ejecutarlo
- El creador describe el problema a Claude con sus propias palabras. El creador puede describir lo que no puede hacer hoy, a quién afecta la idea, qué sería mejor o qué está fuera de alcance. No hace falta lenguaje formal.
- Lluvia de ideas hasta concretar la idea. Claude hace las preguntas que un analista haría: alcance, usuarios, restricciones y qué significa el éxito.
- Pide a Claude que escriba el resultado como
intent.mdutilizando la plantilla de la organización, que puede codificarse como una habilidad configurada por un miembro del equipo técnico y firmada por un líder. Puede cubrir el problema, el resultado propuesto, los usuarios y sistemas afectados, las restricciones y las preguntas abiertas. - El autor corrige cualquier cosa que Claude haya malinterpretado.
- Haz commit de
intent.mdal espacio de trabajo común. El autor y la marca de tiempo y hora se añaden al registro, y el propietario del producto retoma la idea a partir de ahí.
# Intent: claims status self-service
Author: J. Ortiz (claims operations). Status: draft.

## Problem
Customers phone the contact center to ask where their claim is.
Handlers spend roughly a third of call time on status-only queries.

## Proposed outcome
Customers see claim status, next step and expected date in the portal.

## Affected users and systems
Claims handlers, portal team, claims-core API.

## Constraints
No new PII in the portal session. Existing authentication only.

## Open questions
Do third-party loss adjusters need access too?
Consideraciones de gobernanza
La prueba es el intent.md comprometido, que enumera el autor, la marca de tiempo y el historial completo de revisiones. Está registrado en el historial de git de la página del intent. El propietario del producto lo aprueba y la decisión de aceptar o rechazar envía el intent a la Etapa 2: Diseño se registra como la fusión o la revisión de cierre.
Requisitos y diseño
Una vez aprobado por el propietario del producto, Claude toma el intent.md aceptado y elabora un resumen de requisitos y especificaciones de diseño. Esto se basa en las habilidades de la organización en materia de marca, seguridad, cumplimiento y UX.
El propietario del producto revisa esa especificación, pero no la escribe. El objetivo de este proceso es crear una especificación en la que el equipo de ingeniería pueda basarse para planificar, señalando las áreas de preocupación.
El trabajo de frontend es el ejemplo más claro. Una vez aceptado el intent.md, el propietario del producto crea una simulación del diseño en Claude Design (beta) a partir del intent.md, itera en la simulación y luego la exporta a Claude Code para su creación.
Cómo ejecutarlo
- El propietario del producto abre una sesión con las habilidades disponibles de la organización y adjunta el
intent.md. - El prompt de los propietarios de producto señala el
intent.md, menciona las restricciones y exige las preocupaciones señaladas. Se ejecuta manualmente al principio y luego se codifica como un comando de slash a nivel de organización. A partir de ahí, la aceptación deintent.mden la página del intent es el desencadenante, un trabajo no interactivo que se active en la fusión, ejecuta la versión con las habilidades de la organización cargadas y comprometespec.mdcomo una solicitud de extracción (la parte de CI/CD en la Etapa 5: Implementación cubre la fase de implementación). A partir de ese momento, la primera participación del propietario del producto es la revisión. - El mismo propietario del producto revisa la especificación y la idea. ¿Resuelve la especificación el problema planteado y se han respondido o llevado adelante las preguntas abiertas de
intent.md? - Revisa primero las preocupaciones señaladas, ya que son los puntos que un analista habría escalado. El propietario del producto resuelve cada uno de ellos con el propietario de la política antes de que el departamento de ingeniería vea la especificación.
- Haz commit de
spec.mdjunto conintent.md. El par de archivos registra lo que se pidió y lo que se decidió. - El propietario del producto decide si la especificación y la intención avanzan en la compilación, consultando a un líder técnico para cualquier cosa que la organización clasifique como de mayor riesgo. Un compañero humano del equipo siempre toma esta decisión, y aceptar la especificación es lo que inicia el modo plan en la Etapa 3: Creación.
Qué aspecto tiene (el prompt)
Read the attached intent.md and produce a requirements and design spec for integrating it into our existing codebase. Apply the skills available to you so the plan conforms to our brand guidelines, security policies and UX standards. Document the spec fully as spec.md, ready to hand to the engineering team. Describe clearly any areas of concern, especially where you cannot satisfy contradicting policies.Consideraciones de gobernanza
En lugar de descubrirse en una revisión semanas después, la política en vigor se lee y se aplica mientras se redacta la especificación. Las habilidades de la organización se aplican como restricciones en la especificación. La especificación, el prompt que la produjo y las versiones de la habilidad vigentes se registran en el control de versiones. El propietario del producto firma la especificación y remite las preoucpaciones señaladas a los propietarios de la política designados.
Modo de plan de Claude Code como punto de partida por defecto
Los ingenieros inician las sesiones de Claude Code en modo plan, le dan a Claude el spec.md aprobado de la Etapa 2: Diseño y dejan que se entreviste con ellos, iterando en el plan hasta que el ingeniero esté satisfecho con él.
Cómo ejecutarlo
- El ingeniero comienza la sesión en modo plan con Claude.
- El ingeniero le proporciona a Claude los datos
intent.mdyspec.mdy le pide un plan de implementación que indique los archivos que cambian, el orden del trabajo y las pruebas que lo demuestran. - Cuestiona el plan preguntando qué podría romper el cambio, qué paso tiene más riesgos y qué otras opciones decidió no hacer.
- Itera hasta que un ingeniero que nunca haya visto la conversación pueda implementar el cambio solo desde el plan.
- Confirma el plan aprobado como
plan.md. El plan se une al registro de auditoría, y la revisión de PR (Etapa 5: Implementación) compara la posible diferencia con él. - Acepta el plan y deja que Claude lo implemente. Con un plan sólido, la implementación suele hacerse en una sola pasada.
- Cuando la implementación se aparta del plan, actualiza
plan.mden el mismo commit. Considera la posibilidad de usar un hook para forzar la sincronización entre los dos.
Qué aspecto tiene (plan.md)
# Plan: claims status self-service (from intent.md 2026-06-02)

## Files that change
portal/src/claims/StatusPanel.tsx (new), claims-api/routes/status.py,
claims-api/tests/test_status.py

## Order of work
1. Add the status endpoint behind existing auth.
2. Panel against the endpoint.
3. Wire into the portal nav.

## Risks
The claims-core API rate-limits at 50 rps; the panel must cache.

## Proof
test_status.py covers the four claim states; screenshot matches the
approved mock.
Consideraciones de gobernanza
La revisión del diseño se produce antes de que se genere cualquier código, cuando cambiar de rumbo sigue siendo cuestión de editar un documento. El modo plan impone esto por sí solo, ya que Claude no puede editar archivos hasta que el ingeniero acepte el plan. El plan y sus revisiones se registran junto con quién lo aceptó. Los cambios rutinarios los aprueba el ingeniero y cualquier cosa que la organización clasifique como de mayor riesgo la aprueba un responsable técnico o arquitecto.
Claude Code en modo automático
Claude Code también puede ejecutarse en modo automático, donde el ingeniero aprueba el plan y, una vez satisfecho e iterado, Claude aplica cada cambio sin un prompt por edición. A medida que maduran las barreras de protección de este último (un CLAUDE.md afinado, habilidades que codifican la política, hooks que bloquean acciones no seguras y un conjunto de pruebas que Claude puede ejecutar), la aceptación automática se convierte en predeterminada para el trabajo rutinario: un spec.md ajustado, un radio de explosión pequeño y código que las pruebas ya cubren.
El cambio ahora es que el usuario deja de ver al agente hacer las ediciones y revisar las acciones y pasa a revisar los artefactos después de sesiones autónomas más largas. El modo de aceptación automática permite además el paralelismo entre individuos y el equipo cuando se utiliza con árboles de trabajo y es fundamental para ejecutar el SDLC de forma autónoma y cerrar el ciclo, como se describe en la Etapa 6: Mantenimiento.
El CLAUDE.md
CLAUDE.md proporciona a Claude el contexto que un nuevo colaborador necesitaría, abarcando convenciones, comandos, arquitectura y los errores que el equipo ve con más frecuencia. El conocimiento que solía estar en el cerebro de las personas y en wikis se convierte en un archivo que el agente lee al principio de cada sesión, mantenido por todo el equipo e iterado cada vez que se comete un error.
Cómo ejecutarlo
- Ejecuta
/initen el repositorio. Claude genera unCLAUDE.mdinicial a partir de lo que encuentra. - Reduce el archivo generado a lo que un nuevo empleado necesitaría el primer día. Mantén los comandos de compilación, prueba y lint, las convenciones que importan y las cosas en las que Claude se equivoca una y otra vez.
- Revisa
CLAUDE.mden git en la raíz del repositorio para que todo el equipo comparta una versión y los cambios se revisen como código. - Aquí ayuda una regla de trabajo. Cuando Claude comete un error dos veces, la corrección se registra en
CLAUDE.md. - Mantén el informe en menos de una página, porque Claude lo lee todo al principio de una sesión y cualquier cosa obsoleta ocupa contexto sin ningún beneficio.
Qué aspecto tiene (CLAUDE.md)
# Payments service

## Commands
- Build: make build
- Test: make test (unit), make itest (integration, needs docker)
- Lint: make lint (runs in CI; fix before pushing)

## Conventions
- Java 21, Spring Boot 3. No new Lombok.
- Money is always BigDecimal, never double.
- Every endpoint needs an integration test in src/itest.

## Architecture
- api/ holds REST controllers, core/ holds domain logic,
  adapters/ talks to external systems.
- Kafka events are defined in schemas/; never edit generated classes.

## Things Claude gets wrong
- Do not bump dependency versions; the platform team owns them.
- The legacy v1/ package is frozen; changes go in v2/.
Consideraciones de gobernanza
CLAUDE.md tiene control de versiones, por lo que las instrucciones que sigue el agente son revisables y auditables. Las convenciones del equipo se aplican a través del archivo, los cambios se registran en el historial de git y los propietarios del código aprueban esos cambios en la revisión de PR.
Skills como conocimiento institucional
Las skills son la forma en que una organización hace operativo su conocimiento institucional. Las instrucciones son explícitas, controladas por versiones, de amplia aplicación y se actualizan de forma centralizada cuando cambia la política. La regla general: escribe una skill para conocimiento institucional que deba aplicarse de manera coherente; no escribas una skill para componentes que pertenezcan a CLAUDE.md o un prompt.
Cómo ejecutarlo
- Elige un conocimiento que hoy en día se aplique de forma inconsistente. Podría tratarse de un estándar de seguridad, de una convención de diseño de API o de una regla de marca.
- Escríbelo como una skill, una carpeta que contenga un
SKILL.mdcuyo encabezamiento indique cuándo se activa y cuyo cuerpo indique qué hacer. Un ingeniero lo redacta partiendo de la fuente de verdad del titular de la política, con la ayuda de Claude. - Pon la skill en el repositorio de
.claude/skills/<name>/para que se incluya con el código, o distribuyela en toda la organización a través de un plugin. - Comprueba que la skill se activa. Pide a Claude que realice la tarea relevante de diferentes formas y confirma las cargas de skill en cada ocasión.
- Cuando la política cambie, cambia la skill y pide al propietario de la política que apruebe el cambio.
- Los ingenieros acceden a la nueva versión automáticamente en su próxima sesión.
Qué aspecto tiene (.claude/skills/secure-api-review/SKILL.md)
---
name: secure-api-review
description: Apply the API security standard. Use whenever creating or
  modifying an external-facing endpoint, reviewing API code, or
  generating an OpenAPI spec.
---
# Secure API review

When you create or change an API endpoint:
1. Authentication: every endpoint requires the gateway JWT;
   no anonymous routes outside /health.
2. Input validation: validate request bodies against the OpenAPI
   schema and reject unknown fields.
3. Audit: every state-changing endpoint emits an audit event with
   actor, action, entity and timestamp.
4. Data classification: fields tagged pii in the schema must never
   appear in logs or error messages.

Run scripts/check-endpoints.sh and include its output in your summary.
Consideraciones de gobernanza
Una skill es un control, aunque solo de carácter consultivo. Es probable que Claude aplique la política mientras se escribe el código, y nada obliga a una sesión a cumplirla. Una política que debe mantenerse siempre necesita algo determinista detrás de la skill, como un hook que bloquee la acción o un pase de revisión que vuelva a verificar la política en el PR. La skill hace que las violaciones sean poco frecuentes y el hook las hace casi imposibles. Las invocaciones de skill se registran en los registros de sesión y el propietario de la política revisa los cambios de skill como el código.
Hooks como barreras de protección en tiempo de construcción
Una skill es un control de asesoramiento, mientras que un hook es la capa determinística que hay detrás de ella. La mayoría de las acciones de Claude son ediciones de archivos y comandos de shell durante la implementación, por lo que la fase de creación es donde los problemas pueden terminar activándose con más frecuencia.
Los hooks de la fase de creación pueden:
- Bloquear ediciones a rutas protegidas, como clases generadas o un paquete congelado;
- Ejecutar el formateador y el linter después de editar el archivo para que nunca se acumule desviación;
- Mantener las credenciales fuera de la diferencia.
Respaldar cualquier skill cuya política se deba mantener sin excepción. Un hook se ejecuta en cada acción que coincida con él, por lo que los hooks de la fase de compilación deben ser rápidos y limitarse al archivo que ha cambiado. Las verificaciones más complejas, como el conjunto de pruebas completo, se realizan en el commit o en el PR.
Un hook que solicita la aprobación de un humano pertenece a la Etapa 5: Implementación, porque un prompt de aprobación durante la compilación devuelve a una persona la trayectoria crítica de todas las sesiones ejecutándose en paralelo.
Sesiones paralelas y subagentes
Un ingeniero puede gestionar varios flujos de trabajo a la vez.
Una sesión paralela es otra instancia completa de Claude Code, trabajando en una tarea independiente en su propio árbol de trabajo de git. Cada sesión independiente no sabe nada de las demás y el ingeniero que las dirige es lo único que comparten.
Un subagente se ejecuta en una sola sesión como un ayudante definido con su propia ventana de contexto y límites de herramientas y se adapta a trabajos que se repiten en múltiples tareas, como verificar que la aplicación se ejecute según lo previsto.
Las sesiones paralelas aumentan el número de tareas que un ingeniero puede realizar sobre la marcha, mientras que los subagentes mantienen cada sesión centrada en su propia tarea. El trabajo del ingeniero es dirigir y revisar todas ellas.
Cómo ejecutarlo
- El ingeniero divide el trabajo en tareas que afectan a diferentes archivos, utilizando el plan de la pieza en modo plan (Etapa 3: Crear) para ver dónde es independiente el trabajo. Las tareas que comparten archivos se ejecutan en una sola sesión, una tras otra.
- Cada tarea paralela tiene su propio árbol de trabajo, por ejemplo,
claude --worktree feature-authen un terminal yclaude --worktree fix-rate-limiten otro. Un árbol de trabajo es un checkout independiente en su propia rama, lo que evita que las sesiones colisionen en archivos. - Dos o tres sesiones son un punto de partida razonable. El límite práctico es cuántos flujos puede revisar correctamente una persona, así que añade sesiones solamente mientras la revisión vaya al día.
- Convierte los trabajos repetitivos en subagentes, tal y como se define en los archivos markdown de
.claude/agents/, con un nombre, una descripción de cuándo usarlo y las herramientas que puede incluir. Por ejemplo, un simplificador de código que elimina la complejidad innecesaria cuando el agente principal ha terminado, un verificador que ejecuta la aplicación y comprueba el comportamiento, un investigador que explora la base de código y presenta un informe sin desbordar el contexto principal. Revisa las definiciones en git para que todo el equipo las comparta.
Qué aspecto tiene (.claude/agents/verifier.md)
---
name: verifier
description: Runs the app and checks the change works before the session
  reports done
tools: Bash, Read
---
Start the app with make run. Exercise the changed behavior and the two
nearest neighboring flows. Report what you ran, what you saw, and any
behavior that does not match plan.md. Do not fix anything; report only.
Consideraciones de gobernanza
Más sesiones significan más producción, por lo que los controles tienen que provenir de la configuración en el repositorio. Los hooks y la configuración de permisos se aplican a todas las sesiones y lo que una sesión hace se registra y se atribuye al ingeniero que la ejecutó.
Dale a Claude un bucle de retroalimentación
Dale siempre a Claude una forma de verificar su propio trabajo, ya sea pruebas, una compilación o una captura de pantalla. Una sesión verifica su propio trabajo y corrige sus propios errores antes de que un ingeniero los vea.
El bucle de retroalimentación no debe confundirse con un subagente verificador (Etapa 3: Creación). El bucle de retroalimentación se extiende a lo largo de toda la tarea tantas veces como el trabajo. El subagente verificador, por otro lado, es una forma de empaquetar la comprobación final ejecutando una nueva ventana de contexto una vez que la sesión cree que el trabajo está hecho. De esta forma, el veredicto no está condicionado por los supuestos que dieron origen al código.
Cómo ejecutarlo
- Si comprobar el trabajo hoy requiere una secuencia de comandos y algo de conocimiento del entorno, envuelve el proceso en un solo objetivo, como “make test” o “npm test”, que salga de cero en caso de error.
- En la sección Comandos de
CLAUDE.md, enumera cada comando con un ejemplo de un resultado correcto. - Establece un objetivo y hazlo cuantificable para que Claude pueda verificar el trabajo sin preguntarte, por ejemplo: “Todas las pruebas de test_status.py se aprobaron”, “la captura de pantalla coincide con la simulación adjunta” o “el punto final devuelve 200 con el nuevo campo”.
- Para corregir errores, escribe primero la prueba que no ha dado resultados. Pide a Claude que reproduzca el error como prueba, lo ejecute y confirme que falla por la razón que esperas. Haz commit de esa prueba. Solo entonces pide a Claude que la apruebe sin editar la prueba, y el hook test-file del paso final hará cumplir la restricción. Una prueba que existía antes de la corrección y que el agente no podía volver a escribir es la prueba de que el error ha desaparecido.
- Para el trabajo de IU, cierra el ciclo con una revisión visual. Dale a Claude un navegador o una herramienta de captura de pantalla, hazle la simulación y déjale iterar. Implementa, captura la pantalla, compara y ajusta. Dos o tres rondas es normal, el resultado debería mejorar con cada una.
- Haz de la verificación parte del “terminado”. La instrucción reside en
CLAUDE.md. Ejecuta las pruebas antes de informar de que una tarea se ha completado y muestra el resultado. - Por último, el bucle en sí necesita protección, porque un agente que corrige código no debe ser capaz de debilitar el control de ese código. Un hook que bloquea ediciones para probar archivos durante una tarea de corrección hace esto. La alternativa es verificar el cambio en la revisión y rechazar cualquier cambio que afecte a una prueba.
Qué aspecto tiene (bloque de verificación CLAUDE.md)
## Verifying your work

- Build: make build (must finish with "Build succeeded")
- Test: make test (all green; never skip or delete a failing test)
- Lint: make lint (zero warnings)

Run all three before reporting any task complete, and paste the output.
If a test fails, fix the code, not the test.Evaluaciones continuas en CI
Las evaluaciones son el equivalente nativo de IA del control de calidad de stage-gate. En la práctica, eso implica una suite que se ejecuta cada vez que cambia la configuración del agente. Cuando se intercambia un nuevo modelo o se vuelve a escribir un prompt, la suite de evaluaciones indica si el agente sigue realizando el trabajo con el mismo estándar.
Las evaluaciones deben verse como una suite en vivo. A medida que los modelos mejoran, los casos que antes eran discriminatorios dejan de serlo y deben añadirse otros nuevos que surjan de la supervisión continua.
Dependiendo del caso de uso, algunos equipos pueden preferir ejecutar estas evaluaciones offline con una cadencia establecida en lugar de con cada cambio. Los pasos que se indican a continuación son para evaluaciones continuas.
Cómo ejecutarlo
- El ingeniero de plataforma recopila de 20 a 50 tareas reales de trabajos recientes con su resultado esperado o aceptado.
- Escribe cada tarea como una evaluación, es decir, el prompt más las verificaciones que definen lo aceptable (pruebas aprobadas, limpieza de la tarea, comportamiento sin cambios, política cumplida).
- La suite se ejecuta de forma no interactiva en CI, de acuerdo con un calendario y con cualquier cambio en
CLAUDE.md, habilidades o hooks, ya que esa configuración dirige al agente y merece las pruebas de regresión que se le otorgan al código. - La configuración de puerta cambia en función de los resultados. Un cambio de skill que reduce la tasa de aprobación se revisa antes de fusionarse.
- Cada incidente de producción recibe una evaluación, redactada por el equipo responsable del incidente, y permanece en la suite como una prueba de regresión.
Qué aspecto tiene (.github/workflows/agent-evals.yml)
name: Agent evals
on:
  pull_request:
    paths: ['CLAUDE.md', '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: Run eval suite
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
Consideraciones de gobernanza
Las evaluaciones dan al control de calidad una puerta que se mantiene al día con el rendimiento de los agentes. El umbral de tasa de aprobación se aplica como una verificación de fusión, las ejecuciones se registran para que los resultados puedan compararse a lo largo del tiempo y el equipo responsable del cambio de configuración lo aprueba.
La IA en el ciclo de revisión de PR
Claude da y recibe reseñas. Revisa las PR entrantes en función de las políticas de la organización y aborda los comentarios de revisión de sus propias PR. Esto permite a los ingenieros centrarse en el comportamiento en su revisión de PR, lo que se reduce a juzgar la intención y el riesgo.
Cómo ejecutarlo
- El servicio gestionado de Revisión de Código es la forma más rápida de empezar. Un administrador lo activa y selecciona los repositorios. Ejecuta la revisión en tu propio CI con el claude-code-action cuando necesites controlar el pipeline o quieras que las llamadas de API se enruten a través de tu propio acuerdo en la nube (el juego CI/CD cubre esa instalación).
- El responsable técnico escribe la política de revisión como
REVIEW.mden la raíz del repositorio, dividida en las fases que más importan a la organización: bugs y errores lógicos; seguridad y vulnerabilidades; cumplimiento de la especificación (spec.mdde la versión de requisitos), el plan de implementación (plan.mdde la versión de plan) y los principios de diseño.REVIEW.mdtambién define qué se considera importante y qué se puede omitir. - El líder técnico establece el umbral humano. Los hallazgos no aprueban ni bloquean una PR por sí solos, y la protección de ramificaciones sigue requiriendo la aprobación de un propietario del código. Un ingeniero de plataforma que quiera fusionar los hallazgos puede leer los recuentos de gravedad que publica la comprobación como un recuento legible por máquina.
- Cuando un revisor o el autor etiquetan a
@claudeen un comentario de revisión, Claude aborda el comentario y envía la corrección. El hilo de PR registra tanto la solicitud como el cambio. Este bucle de corrección se ejecuta en el claude-code-action. En el servicio gestionado, comentar@claude reviewsolicita una nueva revisión. Para las PR que Claude abrió, da un paso más y deja que Claude supervise la PR para fusionar. Los equipos cierran el ciclo con un comando de slash personalizado que borra los comentarios de revisión sin resolver y las verificaciones fallidas de la PR, los aborda y envía las correcciones, hasta que la PR tenga luz verde y solo espere la aprobación del propietario del código. - Los resultados de la revisión se reflejan en
CLAUDE.md. Cuando una revisión señala un error por segunda vez, la corrección se registra enCLAUDE.mdcomo parte de esa revisión, y como la revisión leeCLAUDE.md, el error se detecta a partir de la siguiente PR. La revisión también señala cuándo un cambio ha hecho queCLAUDE.mdquede obsoleto. - Una vez al mes, el responsable técnico afina la configuración calificando los resultados para que el revisor mejore y limitando el volumen de Nit en
REVIEW.md. Se excluyen las rutas generadas y cualquier cosa que CI ya haya aplicado.
Qué aspecto tiene (REVIEW.md)
# Review instructions

## Passes
Run three passes and tag each finding with its pass:
- Bugs: logic errors, broken edge cases, subtle regressions
- Security: injection risks, authentication gaps, PII in logs
- Compliance: the change matches spec.md, plan.md and our design principles

## What Important means here
Reserve Important for findings that would break behavior, leak data
or breach a policy. Style and naming are nits.

## Cap the nits
Report at most five nits per review; summarize the rest as a count.

## Do not report
Generated files under src/gen/ and anything CI already enforces.
Consideraciones de gobernanza
La separación de tareas se mantiene, porque el agente que escribió el código no tiene forma de aprobarlo. La política de revisión de REVIEW.md se aplica a todos los PR y los resultados, correcciones, calificaciones y aprobaciones se registran en el historial de PR, por lo que el PR es el registro de auditoría. La aprobación procede de un ser humano a través de la protección de una rama, informada por los resultados.
Para saber cómo se componen estos controles a escala de producción, consulta Asegurar un SDLC nativo de IA en Anthropic.
Hooks como puertas de aprobación
La fase de creación utilizaba hooks como barreras de protección, permitiendo o bloqueando acciones sin la intervención de un humano (Etapa 3: Creación). Un hook también puede pedir, pausando la acción hasta que una persona específica lo apruebe, que es lo que necesita el release gating.
La pieza se sitúa en la Etapa 5: Implementación, porque la fecha de lanzamiento es el caso más claro, pero los hooks no son específicos de una implementación: se ejecutan dondequiera que actúe Claude. Por ejemplo, los hooks pueden bloquear ediciones a migraciones e infra sin un ticket de cambio durante la Etapa 3: Creación y detener la edición de archivos de prueba por parte del agente durante una tarea de corrección en la Etapa 4: Prueba.
Cómo ejecutarlo
- El liderazgo de ingeniería, con gestión de cambios y cumplimiento, enumera las barreras de aprobación humana que deben sobrevivir, como la aprobación de la gestión de cambios, la autorización de versiones y las modificaciones de rutas protegidas.
- El ingeniero de plataforma expresa cada puerta como un hook, un script que se ejecuta antes de que Claude actúe para permitir, preguntar o bloquear.
- Los hooks de equipo van en
.claude/settings.jsonen git y los hooks no negociables van en configuraciones gestionadas propiedad de la plataforma o del administrador de TI, donde los ingenieros individuales no pueden desactivarlos. - Un bloqueo debería explicarse por sí solo, así que cuando un hook detiene una acción, el motivo y la ruta para la aprobación aparecen en el resultado de Claude.
Qué aspecto tiene (.claude/settings.json)
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "Bash",
          "hooks": [
            { "type": "command",
              "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" }
          ]
        }
      ]
    }
}
Y la puerta en sí (.claude/hooks/production-gate.sh)
#!/bin/bash
# Production deploys require a named release authorization
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
   if [ -z "$RELEASE_APPROVAL" ]; then
     echo "Production deploys need a release authorization." >&2
     exit 2 # exit 2 blocks the action; the message goes to Claude
   fi
fi
exit 0
Consideraciones de gobernanza
Los hooks son las puertas de aprobación. La condición de puerta se aplica en todo momento y para todos. Las decisiones de permitir y bloquear se registran con una marca de tiempo. La puerta también define lo que cuenta como aprobación, ya sea un ticket de cambio aprobado o la aprobación del responsable de la versión.
Integración e implementación de CI/CD
Ejecuta Claude Code de forma no interactiva dentro del pipeline CI/CD, realiza un sandbox de la ejecución para que los agentes de larga ejecución se ejecuten de forma segura, expone la implementación a través de integraciones MCP y prueba las rutas de rollback antes de que el agente las necesite.
Cómo ejecutarlo
- El ingeniero de plataforma comienza con pasos de evaluación de solo lectura. Usa
claude -pen un trabajo de pipeline para evaluar una compilación fallida, resumir una prueba inestable o redactar el registro de cambios. - Añade pasos de escritura fuera de las puertas existentes para tareas como corregir lint, actualizar documentos generados o abordar comentarios de revisión a través de las menciones de
@claude. Cualquier cosa que escriba el agente llega como PR a través de la protección de rama y el agente no tiene ninguna ruta para enviar a la principal. - La ejecución se hace en un entorno aislado. Los trabajos de agente se ejecutan en contenedores bajo una política de red con tokens de alcance de corta duración, y no contienen credenciales de producción por defecto.
- Expón la implementación a través de MCP. La implementación, el estado y la reversión se convierten en herramientas, según el entorno, por lo que las capacidades de implementación del agente son una lista de permisos y no un script de shell con credenciales.
- Clasifica la autonomía por entorno. En el desarrollo, el agente implementa libremente. En producción, el agente prepara la versión y el responsable de versiones la autoriza, y un hook aplica la puerta de producción. La puesta en escena se sitúa en algún punto intermedio.
- El rollback debe ser la ruta más ensayada del pipeline, un solo comando que el agente pueda ejecutar y que se ejerza regularmente en la fase de prueba. El cierre del ciclo de pieza (Etapa 6: Mantenimiento) requiere esta reversión cuando se rompe una banda de control, por lo que debe probarse de antemano.
Qué aspecto tiene (paso del pipeline)
- name: Triage failed build
  if: failure()
  run: >
    claude -p "Read the build log at out/build.log. Identify the most
    likely cause, say whether the failure looks flaky or real, and write a
    three-line summary for the PR thread." >> triage.md
Consideraciones de gobernanza
El principio rector es que el agente puede actuar hasta la puerta de producción y no puede atravesarla. Los controles siguientes hacen cumplir este principio.
- La protección de rama convierte cualquier cosa que escriba el agente en una PR, sin que haya una ruta directa a la principal.
- El hook de implementación de producción bloquea la versión hasta que un responsable de versiones designado la autorice. Cada ejecución no interactiva actúa con la identidad propia del agente, por lo que el registro del pipeline separa lo que hizo el agente de lo que hizo el ingeniero que lo activó.
- Los niveles de permisos por entorno establecen cuánto puede hacer el agente en el camino hacia la puerta.
Mantenimiento y cierre del ciclo
Hasta ahora, hemos hablado de cómo añadir Claude a cada etapa del proceso SDLC y en cada etapa se requiere la intervención de un humano para comenzar con los pasos iniciales. Sin embargo, esta fase cambia el enfoque a la ejecución autónoma de Claude para cerrar el ciclo.
Por ejemplo, un agente de monitorización que se ejecuta continuamente podría, tras la presentación de un ticket de error, crear un intent.md y pasar por las fases de requisitos, planificación, compilación, prueba y revisión. Etapa 6: el mantenimiento se ejecuta en modo headless, con una puerta de confianza independiente entre las etapas, una comprobación determinista o un agente de revisión contradictoria que decide si el resultado de la etapa anterior continúa o se envía a un humano.
Cierre del ciclo
Un script determinista supervisa la producción e invoca a Claude cuando se rompe una banda de control. La supervisión de una violación es un ejemplo útil del patrón para que el ciclo se ejecute de forma autónoma, mientras que la sección Claude Tag (beta pública) al final de la etapa cubre el trabajo que llega a través de diferentes canales.
Cómo ejecutarlo
- El propietario del servicio o el ingeniero de la plataforma eligen una métrica con una línea de base estable, como la tasa de fallos de las pruebas de CI, la tasa de 5xx posdespliegue o el tiempo del ciclo de PR.
- Escriben el guion de detección, normalmente la desviación media y estándar en un marco móvil con reglas (Western Electric o similares) para que las bandas detecten tanto la deriva lenta como los picos. El script está controlado por versiones y se somete a pruebas unitarias y la detección sigue siendo completamente determinista, sin que intervenga ningún modelo.
- Los niveles de respuesta se definen en la configuración controlada por versiones (
bands.yamlmás adelante). En 1σ el script solo registra, en 2σ invoca a Claude en modo de solo lectura para diagnosticar y en 3σ Claude puede actuar, aunque solo abriendo un PR en la puerta de revisión o activando un runbook preaprobado. - La capa de activación puede ser un flujo de trabajo programado en GitHub o GitLab, un webhook de la pila de monitorización existente o un Cron Job dentro de la red. Claude se ejecuta sin estado, ya sea como paso no interactivo en un CI runner o como servicio Agent SDK en un contenedor sandbox, y la versión CI/CD cubre las opciones de implementación y acceso al modelo. Como la ejecución no tiene estado ni es interactiva, un bucle puede comenzar y terminar sin que nadie lo inicie.
- El agente redacta su diagnóstico como
intent.mden el formato de Etapa 1: Planificación, que abarca la anomalía y sus evidencias, un resultado propuesto, los sistemas afectados y cualquier pregunta pendiente. A partir de ahí, el hallazgo pasa por el pipeline como cualquier otra cosa. - El responsable del servicio o el ingeniero de guardia clasifican la cola y remiten los hallazgos relacionados con el producto al responsable del producto. Arreglar ahora, programar o descartar. Las descargas afinan las bandas y ayudan a reducir el ruido.
- Cuando se lance una solución, añade una evaluación para el incidente (la pieza de evaluaciones continuas) para asegurarte de que dichos problemas estén protegidos contra continuidad.
Qué aspecto tiene (por ejemplo, un bands.yaml que monitoriza la tasa de fallos de las pruebas de CI)
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: { action: log }
  2sigma: { action: diagnose,
            tools: "Read,Grep,Bash(gh run view *)" }
  3sigma: { action: propose,
            routes: [pull_request, runbook:rollback-deploy] }
Consideraciones de gobernanza
Los límites de nivel se aplican desde la configuración controlada por versiones, con permisos y configuraciones gestionadas que deniegan el acceso a producción. Las invocaciones, hallazgos y decisiones de clasificación se registran con una marca de tiempo. Un responsable del servicio evalúa y aprueba los resultados, los cambios resultantes pasan por la puerta normal de revisión de PR y los runbooks que el agente puede activar se aprobaron de antemano.
Ejemplos
- Cuando la tasa de fallos de la prueba de CI supera 3σ, el agente pone en cuarentena la prueba inestable o abre una solicitud de reversión y la puerta de revisión decide.
- Cuando la tasa de 5xx posterior a la implementación supera 3σ y hay una implementación en la ventana, el agente activa el pipeline de rollback existente.
- Cuando el tiempo del ciclo de PR incumple una regla de desviación, el agente escribe un informe para los responsables de ingeniería, que muestra que el enfoque funciona tanto para las métricas de proceso como para las de producción.
Análisis recurrentes de la base de código
Un análisis de seguridad es una declaración puntual sobre una base de código en un modelo en particular y ambas mitades quedan obsoletas: el código cambia cada semana y cada generación de modelos encuentra vulnerabilidades que la anterior no tenía. La respuesta nativa de IA es ejecutar el análisis según un cronograma, sin que intervenga un humano en la ruta de invocación y enviar lo que encuentre a través de las mismas puertas que cualquier otro cambio en la base de código.
Claude Security es la forma alojada de análisis programado. Conecta un repositorio de GitHub y los análisis se ejecutan en Claude Mythos 5 en la infraestructura de Anthropic, con cada hallazgo validado antes de ser reportado y con un índice de confianza adjunto. Los parches sugeridos se revisan y se aplican en Claude Code en la web. La organización obtiene los hallazgos sin necesidad de acceder al modelo en sí.
Cómo ejecutarlo
- El responsable de seguridad conecta los repositorios y los organiza en proyectos por repositorio, servicio o equipo, para que la titularidad de los hallazgos quede clara desde el principio.
- Ejecuta un primer análisis completo de los repositorios más críticos, incluidos los que ya han sido analizados antes por otras herramientas o por modelos anteriores. Considera el primer escaneo como la línea de base. El primer análisis probablemente revelará hallazgos en código que se consideraba limpio.
- Establece una programación por proyecto. Semanal es un valor predeterminado razonable para servicios desarrollados activamente; análisis de alcance de un directorio o rama donde el repositorio es grande o mixto.
- Clasifica los hallazgos con el índice de confianza en la mano. Descarta con un motivo, de modo que se registre el descarte y el mismo hallazgo no vuelva a aparecer como nuevo en la siguiente ejecución.
- Para un hallazgo limitado, abre el parche sugerido en Claude Code en la web, revisalo y envíalo a través de la puerta de revisión de PR como cualquier otro cambio. El agente que propuso la corrección no tiene ninguna ruta para aprobarla.
- Para cualquier cosa mayor que un parche, como una debilidad arquitectónica o un patrón que se repite en todos los servicios, escríbelo como
intent.mden el formato de la Etapa 1 y empieza a trabajar en Planificación. - Cuando se lance una solución a producción, añade una evaluación para la clase de vulnerabilidad a la suite de las evaluaciones continuas, de modo que la configuración que controla al agente se pruebe en comparación con esa clase a partir de ese momento.
- Exporta los hallazgos como CSV o Markdown, o usa webhooks, para mantener el tracker y los sistemas de auditoría existentes de la organización como el sistema de registro donde los auditores ya los esperan.
Consideraciones de gobernanza
El análisis se ejecuta bajo los controles de administración de la organización, lo que significa que los repositorios que están conectados, quién tiene el control de análisis y el límite de gasto se establecen de forma centralizada. Cada hallazgo tiene un resultado de validación y una calificación de confianza y cada descarte tiene un motivo, por lo que el historial de análisis es un registro de auditoría de lo que se encontró, corrigió y aceptó conscientemente.
Las correcciones llegan a producción a través de la protección de la puerta de revisión de PR y de sus ramas, en lugar de a partir del propio análisis. Claude Security mejora el análisis estático y el escaneo de dependencias existentes. Las comprobaciones determinísticas se mantienen en CI y el análisis basado en modelos cubre las vulnerabilidades dependientes del contexto para las que esas comprobaciones no están diseñadas.
Llamadas a Claude con Claude Tag
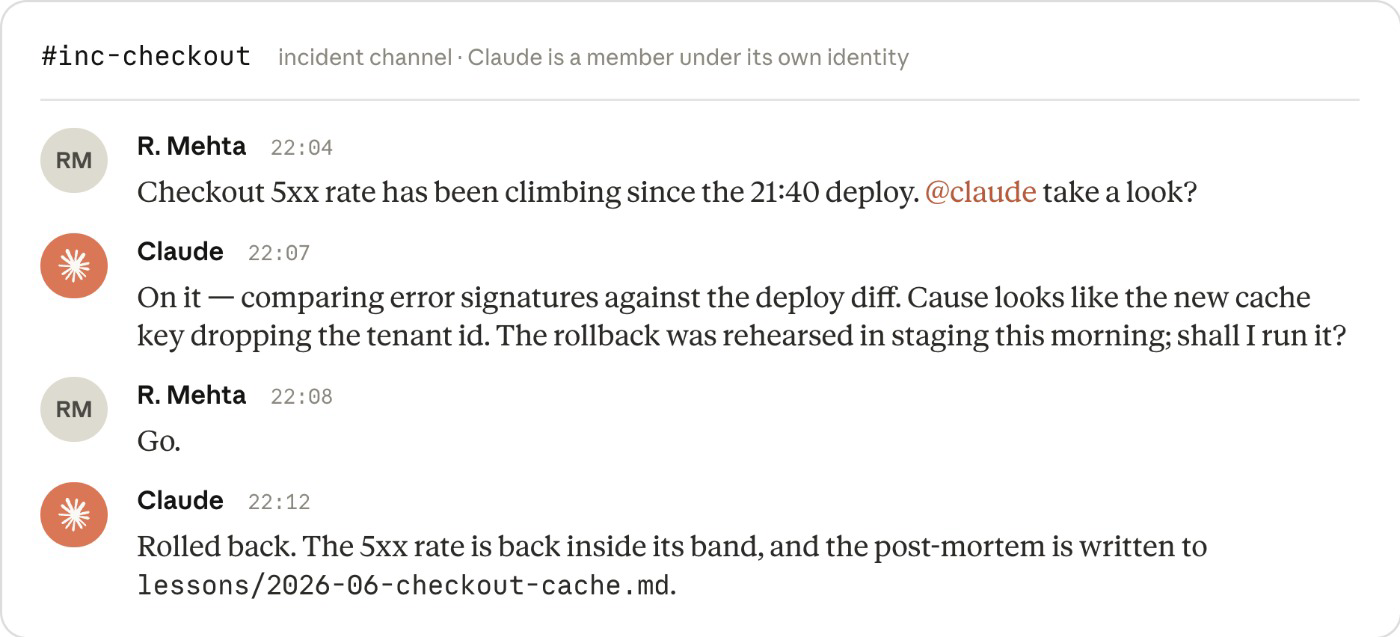
Los incidentes también pueden llegar a través de otros medios, como aplicaciones de comunicación en el lugar de trabajo, como Slack o Teams. Los incidentes pueden tener el aspecto de un mensaje de Slack a las 10:00 horas para una solución urgente en un canal de incidentes y ahora se puede actuar sobre ellos de inmediato. Claude Tag (beta pública actualmente disponible en Slack) convierte a Claude en miembro de esos canales con su propia identidad, de modo que cada nuevo incidente recibe un primer respondedor y la respuesta en sí misma se convierte en parte del ciclo y de la memoria para futuros incidentes.
La conversación y el conocimiento institucional permanecen en el canal, y cualquiera de los integrantes del canal puede guiar y actuar en consecuencia. Cualquier miembro del equipo puede probar hipótesis, explorar nuevas opciones e investigar en tiempo real con el historial del canal se añade a la capacidad de auditoría. A través del acceso a MCP, Claude verifica que la métrica vuelva a la línea de base y lo confirma en el hilo, escribe la autopsia en un archivo de lecciones con control de versiones que puedan leer futuras investigaciones.
Los incidentes no son el único trabajo que Claude Tag realiza. Etiquetado en un ticket a través de MCP o solicitado en el canal, Claude clasifica el trabajo de la misma manera. Una corrección pequeña y bien definida llega como PR a través de la puerta de revisión, y cualquier cosa mayor se registra como intent.md para la Etapa 1: Planificaciónj, momento en el que el bucle comienza a alimentarse por sí solo. Consulta: cómo Claude Tag trabaja por llamada para CI/CD en Anthropic.
Pensamientos finales
Los modelos y los arneses se han vuelto más avanzados, lo que permite a las organizaciones no solo transformar la forma en que producen código, sino todo el ciclo de vida de desarrollo de software.
Esta transformación mantiene el juicio humano en el centro del proceso y tiene en cuenta los requisitos de gobernanza y regulación de las grandes organizaciones.
Esta guía consolidó muchas de las mejores prácticas reales que nuestro equipo de IA aplicada ejecuta a diario para nuestros clientes, y esperamos que la hayas encontrado un recurso práctico y procesable.
Recursos y reconocimientos
La documentación que aparece a continuación es lo que un equipo de plataforma necesita para configurar esos controles, aproximadamente en el orden en que se implementarían.
Gracias a Jim Blackhurst, Will Steuk y Jamal Arif por sus contribuciones a esta guía, que se inspiró en gran parte de su trabajo anterior y se basó en él.