Come Anthropic consente l'analisi self-service dei dati con Claude
Tradizionalmente, è stato problematico definire come molti team di data science e data engineering possono attestare e abilitare l'analisi self-service dei dati.
Rendere il modello di dati più accessibile ai colleghi meno tecnici tramite tabelle ampie e denormalizzate porta spesso a una sovrapposizione di visioni con definizioni incoerenti man mano che l'azienda cresce (e contribuisce ben poco a colmare il divario per i dipendenti poco propensi ad apprendere l'SQL). In alternativa, la creazione di ambienti più chiusi spesso trascura le vere domande di business e porta a un sovraccarico di metriche e dashboard, poiché i team lavorano in modo isolato.
L'ascesa degli LLM offre un ulteriore percorso per l'analisi self-service che consente di evitare queste sfide. Tuttavia, indirizzare Claude su un data warehouse e lasciare che siano gli agenti a fare tutto può creare un falso senso di precisione.
Il sollievo iniziale di non essere più soggetti alle richieste ad hoc si trasforma presto in preoccupazione quando si scopre che questa configurazione separa gli stakeholder dall'infrastruttura, dalla documentazione e dalle competenze che in precedenza li hanno guidati verso set di dati accuratamente curati.
In Anthropic, il 95% delle query di analisi aziendale viene automatizzato tramite Claude, con un'accuratezza complessiva del 95%. Affidando a Claude questo lavoro spesso ripetitivo, il nostro team di data science può concentrarsi su attività più strategiche come la modellazione causale, le previsioni e il machine learning.
Dopo aver incontrato decine di persone tra i migliori utilizzatori di Claude Code di Anthropic e aver visto una miriade di modelli di design per gli agenti di analisi, abbiamo redatto alcune best practice per altri data team che lavorano con gli LLM. In questo post, condivideremo questi suggerimenti e approcci per massimizzare la capacità di Claude di generare informazioni aziendali in autonomia, ad esempio, approfondiremo:
- Perché l'accuratezza delle analisi è un problema di contesto e verifica e non un problema di generazione del codice;
- Le tre modalità di fallimento che causano la maggior parte degli errori;
- Lo stack di analisi agentiche che abbiamo creato per affrontare questi errori;
- Come misuriamo l'efficacia;
- Il modello di base per la creazione della maggior parte delle nostre competenze (vedi l'appendice)
I dati non sono software
Le capacità generative degli LLM sono un'arma a doppio taglio: i meccanismi che consentono soluzioni creative a problemi complessi possono anche avere allucinazioni producendo risultati errati. Per comprendere appieno le sfide degli agenti di analisi, è utile confrontarli con gli agenti di programmazione.
La programmazione è uno spazio di soluzioni aperte che premia la creatività dei modelli, mentre la documentazione e i test forniscono misure di tutela naturali contro le allucinazioni. Al contrario, per i casi d'uso di analisi, spesso c'è solo una risposta corretta visto l'uso di un'unica fonte corretta in cui non esiste un modo deterministico di dimostrare la correttezza.
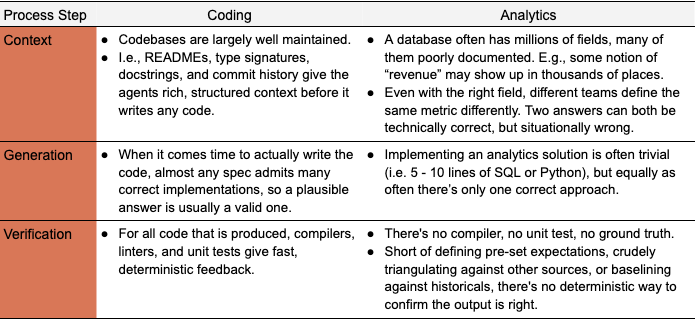
Per l'analisi aziendale agentica self-service, la complessità risiede principalmente nell'ambiguità dei dati. Il problema principale si riduce alla nostra capacità di mappare la domanda dell'utente a entità specifiche e aggiornate nel nostro modello di dati e conoscere il modo corretto di lavorare con esse. Se riusciamo a farlo, l'esecuzione risultante e l'SQL diventano banali.
Abbiamo identificato tre attributi del problema che rappresentano la stragrande maggioranza delle risposte inesatte:
- Ambiguità del concetto <> dell'entità: con centinaia di opzioni valide in un modello di dati (con potenzialmente milioni di campi), l'agente non è in grado di scegliere i campi corretti che rispondono meglio alla domanda di un utente. Ad esempio, nella misurazione del numero di utenti attivi: quali azioni costituiscono l'essere “attivi”? Occorre includere gli utenti fraudolenti? Quale finestra di lookback è meglio usare?
- Obsolescenza dei dati: le fonti di dati, le definizioni di business e gli schemi cambiano costantemente, per questo, le risorse e le conoscenze degli agenti diventano stantie e iniziano a restituire risposte leggermente sbagliate.
- Errori di recupero: le informazioni giuste potrebbero trovarsi nel modello di dati ed essere correttamente annotate, ma, vista la vastità dello spazio di ricerca, l'agente semplicemente potrebbe non riuscire a trovarle.
Il nostro stack di analisi self-service agentiche
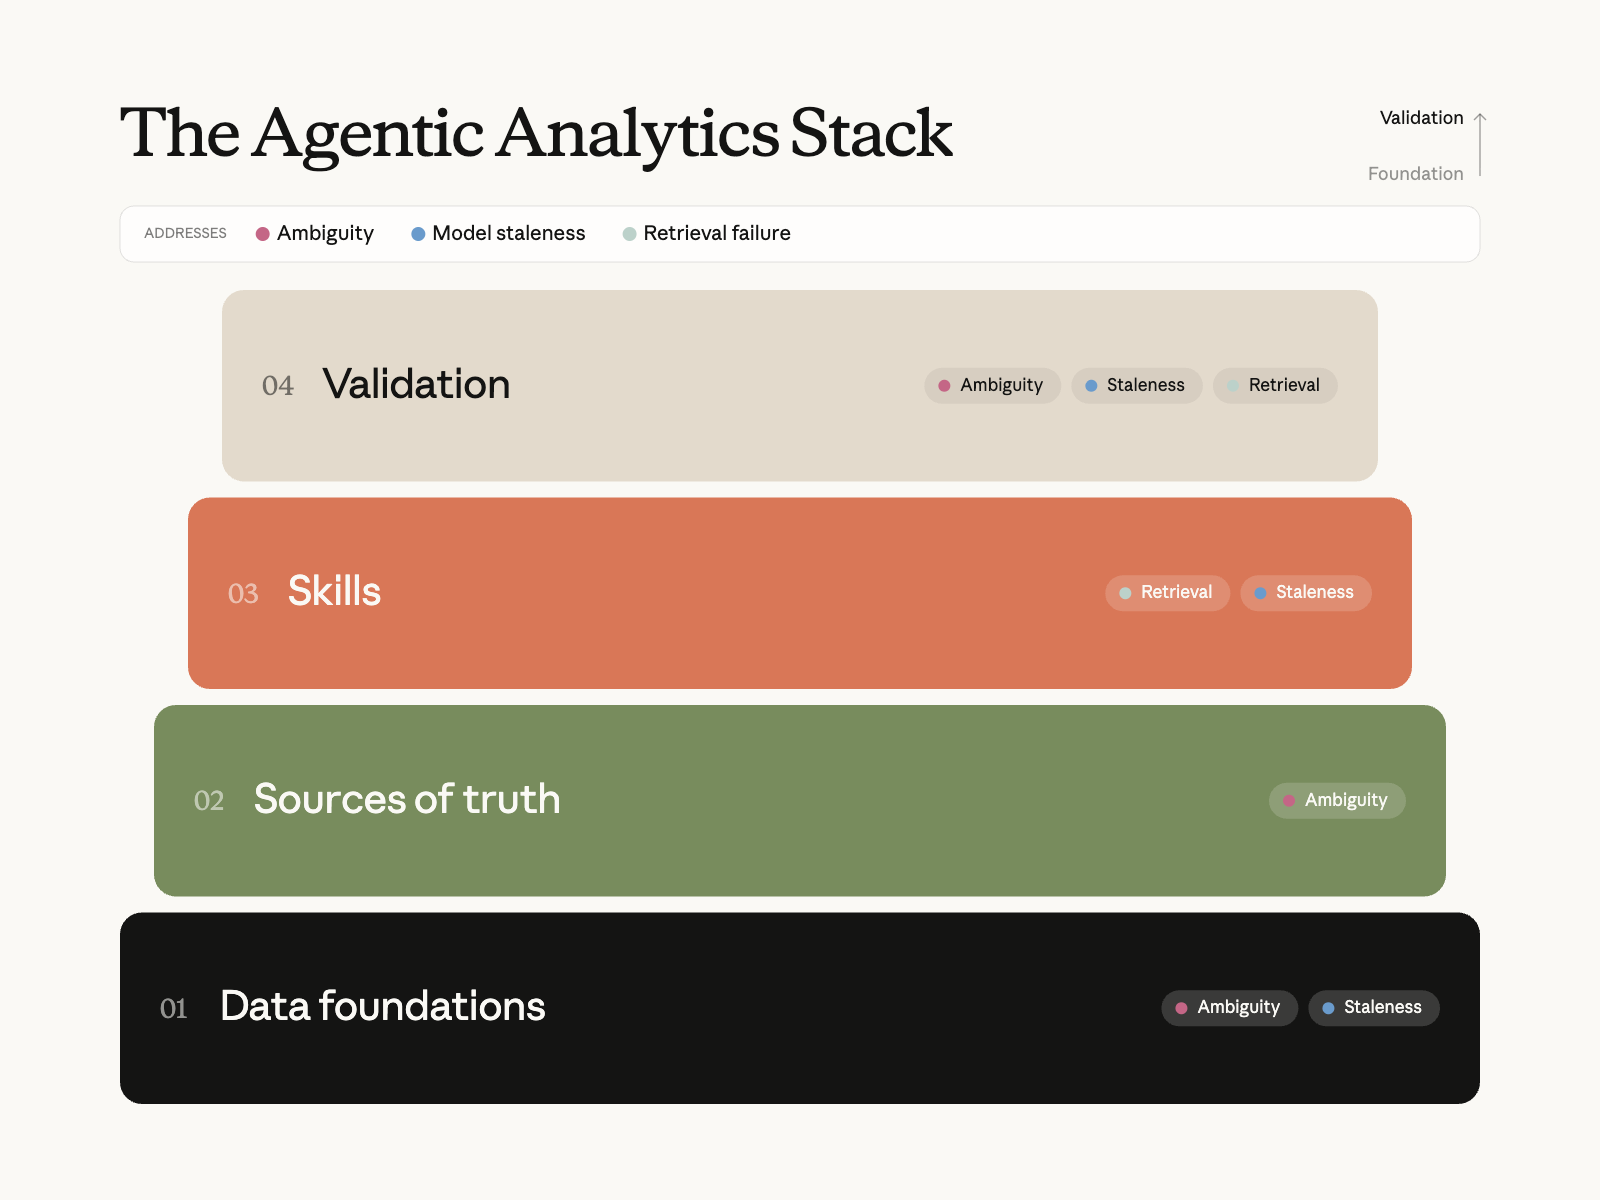
In Anthropic, la soluzione principale per ridurre questi tre errori è tramite il nostro stack di dati agentici. Ogni livello esiste principalmente per affrontare uno o più di questi problemi:
- Ambiguità delle entità: i fondamenti dei dati e le fonti di verità riducono lo spazio delle entità plausibili fino a quando non vi è un'unica risposta governata.
- Stabilità: i processi di manutenzione e convalida impediscono l'obsolescenza man mano che il business cambia.
- Errore di recupero: le competenze garantiscono che l'agente trovi in modo affidabile e utilizzi correttamente la risposta.
In questa sezione, vedremo meglio come abbiamo creato ogni livello.
“Per domande ad hoc direttamente su Slack, scopri come il nostro data team distribuisce un agente di analisi dei dati con Claude Tag.”
Fondamenti dei dati
L'aspetto più importante per garantire l'accuratezza degli agenti di analisi è la presenza di solide basi di dati, che includono i modelli di dati, le trasformazioni, i test e le tabelle in un data warehouse, insieme ai metadati che li descrivono. Le pratiche standard di data engineering e qualità dei dati, come la modellazione dimensionale, i test shift-left, i controlli di attualità e completezza sulle pipeline critiche, sono tutte ancora valide (e non verranno messe in discussione).
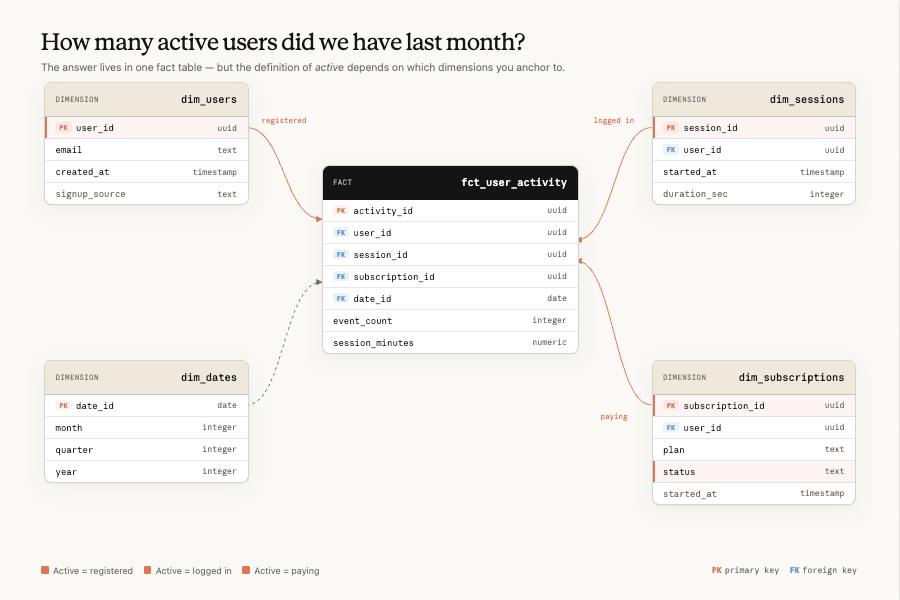
Ciò che cambia è che l'utente finale del tuo modello di dati non è più un esperto di dati (ad esempio un data scientist), ma piuttosto un agente che agisce per conto degli utenti con vari gradi di competenza in materia di dati o di comprensione dell'infrastruttura sottostante. Questo cambiamento presenta una sfida, in quanto i risultati non possono richiedere all'utente di convalidare la correttezza semplicemente perché l'utente finale non la conosce.
Il livello delle basi dei dati è finalizzato principalmente all'eliminazione dell'ambiguità: se le entrate, ad esempio, si risolvono in un unico set di dati governato anziché in quaranta candidati plausibili, il problema scompare prima ancora che l'agente debba effettuare una ricerca. Questo è anche il luogo in cui si trova la prima difesa contro l'obsolescenza, poiché lo stesso repository che definisce i modelli canonici è il luogo naturale per garantire che siano sempre aggiornati.
Abbiamo visto che alcune pratiche funzionano particolarmente bene:
- Creare set di dati canonici: l'errore di gran lunga più comune è che l'agente non è in grado di mappare un concetto (“ricavi per il prodotto X”) all'unica definizione corretta di tabella, colonna e metrica, solitamente questo accade perché sono disponibili più candidati plausibili, con implementazioni leggermente diverse. La soluzione risiede nell'adottare un minor numero di modelli logici più rigorosi e controllati: è importante selezionare un piccolo insieme di dataset canonici e provenienti da una singola fonte di verità che sono chiaramente di proprietà, pronti per il consumo e reperibili, quindi deprecare in modo aggressivo i quasi-duplicati. I rollup fisici e le cache hanno ancora un impatto sui costi e sulle prestazioni, ma dovrebbero derivare meccanicamente dai modelli canonici anziché convivervi accanto come alternative. L'obiettivo è avere agente che cerca un concetto e trova un'unica risposta governata.
- Rendere solidi gli standard: abbiamo scoperto che le buone basi possono essere mantenute solo se i modelli canonici e le definizioni delle metriche vengono applicate dagli strumenti (l'agente viene strutturalmente indirizzato prima a loro; ne parleremo meglio di seguito), dalla CI (modifiche che ignorano la revisione) e dal mandato (i team a valle sviluppano sul livello governato o spiegano perché non lo sono). La governance senza enforcement riporta rapidamente al problema dei candidati multipli.
- Collocare artefatti: la nostra principale difesa contro i modelli di dati e la logica di business in continua evoluzione è la colocation. Quasi tutto il codice di dati (modellazione, livello semantico, documenti di riferimento, definizioni canoniche della dashboard) risiede in un unico repository, con controlli di CI che ne proteggono l'integrità tra i diversi livelli. Se una modifica alla modellazione potrebbe compromettere una dashboard a valle o invalidare una metrica documentata, CI lo segnala e la correzione verrà distribuita nella stessa PR. (Torneremo su questi meccanismi nella sezione Skills di seguito.)
- Trattare i metadati come un prodotto di prima classe: gli agenti di programmazione hanno buone prestazioni in parte perché le codebase sono leggibili: README, firme di tipo, documentazioni, ecc. I data warehouse possono essere altrettanto leggibili, ma solo se le descrizioni delle colonne e delle tabelle, le definizioni delle metriche canoniche, la documentazione granulare, gli intervalli di valori validi, il lignaggio, la proprietà e il tiering del modello vengono gestiti con lo stesso rigore delle trasformazioni stesse. Pur non essendo una novità, una buona governance fornisce un contesto critico che aiuta l'agente a scegliere il set di dati giusto.
Fonti di verità
Se le basi dei dati sono il data warehouse stesso, le fonti di verità sono le superfici di riferimento che l'agente consulta per navigarvi. Questo livello riduce l'ambiguità del concetto <> entità e trasforma gli “utenti attivi ogni settimana” citati nella domanda di uno stakeholder in un'entità specifica e governata nel modello di dati. Approssimativamente in ordine decrescente di fiducia:
- Livello semantico: le definizioni delle metriche e delle dimensioni compilate. Se una domanda si correla chiaramente a una metrica definita, l'agente richiama una funzione e ottiene un numero, lo stesso numero prodotto da ogni altro contesto aziendale. Ai nostri agenti viene strutturalmente richiesto (in base alle istruzioni sulle competenze) di sfruttare innanzitutto il livello semantico (vedi l'appendice). Un'idea che abbiamo provato ma che non ha funzionato: avviare il livello semantico facendo generare automaticamente le definizioni delle metriche da tabelle grezze e log delle query, grazie a un LLM. Ha prodotto definizioni dall'aspetto plausibile che hanno codificato le stesse ambiguità che stavamo cercando di eliminare, e ha avuto un risultato nettamente negativo nelle nostre valutazioni rispetto a un livello più piccolo e curato dall'uomo. Per questo motivo, consigliamo di generare la documentazione con Claude, ma di lasciare che la definizione sia affidata a un essere umano.
- Lineage e grafico delle trasformazioni: quando il livello semantico non copre una domanda, il lineage e la classificazione nella tabella (in base al numero di riferimenti) consentono all'agente di ragionare su quali modelli a monte alimentano un concetto, quali sono deprecati e quali sono gli stessi modelli in comune. Questo trasforma il messaggio “Non conosco la metrica” in “So da quale modello partire per aggregarle”. Questo costituisce anche la spina dorsale dei segnali di attualità e provenienza che emerge nella convalida online di seguito.
- Corpus delle query: SQL storico da dashboard, notebook e analisi precedenti. Intuitivamente, dovrebbe essere di grande valore: è un registro di ogni domanda a cui è già stata data una risposta corretta. In pratica, abbiamo scoperto che dare accesso al raw retrieval di migliaia di query precedenti ha migliorato l'accuratezza degli agenti di meno di un punto (spiegheremo questo punto in una sezione successiva di seguito). Il recupero non strutturato non riusciva a mappare una nuova domanda all'elemento giusto precedente. Ciò che funziona è trasformare il corpus in documenti di riferimento strutturati per dominio e modelli di analisi riutilizzabili descritti nelle Skills. Gestisci la cronologia delle query come una materia prima per la selezione, non come una fonte di verità che l'agente legge direttamente.
- Contesto aziendale: è il livello che la maggior parte dei team salta e quello che abbiamo sottovalutato più a lungo. Un agente che non comprende la tua attività risponderà a ciò che l'utente ha chiesto, ma non saprà cosa intende. Non saprà che “il lancio del secondo trimestre” si riferisce a un prodotto specifico, che due team definiscono lo stesso termine in modo diverso o che viene posta una domanda perché giovedì ci sarà una riunione del consiglio di amministrazione. Integra un knowledge graph aziendale composto da documenti indicizzati, roadmap, log delle decisioni e la nostra struttura organizzativa in modo che l'agente possa risolvere i riferimenti ambientali e porre domande di chiarimento più efficaci.
Il modello di errore comune a tutti e quattro i modelli è lo stesso dal livello delle basi dei dati: documentazione scadente oppure obsoleta. Claude è eccezionalmente utile per colmare le lacune (come la redazione di descrizioni di colonne, la compilazione di proposte di metriche dai pattern delle query, la segnalazione di modelli non documentati in CI), ma la cura dei dati e la proprietà devono essere gestite dagli esseri umani.
Nelle prossime due sezioni, discuteremo come rendere questo aspetto abbastanza economico da farlo diventare efficace.
Skills
Se le fonti di verità sono le conoscenze dichiarative dell'agente (ovvero, cosa significa una metrica), una skill è la sua conoscenza procedurale: quali fonti consultare e in quale ordine, come orientarsi tra dati ambigui e come si presenta un'analisi completata.
In Claude Code, una skill è una cartella di markdown che l'agente legge su richiesta. In Anthropic, le competenze che abbiamo sviluppato costituiscono un enorme valore aggiunto. Senza competenze, la capacità di Claude di rispondere con precisione alle domande di analisi non superava il 21% delle nostre valutazioni. Aggiungendo le Skills, questi numeri raggiungono costantemente valori superiori al 95% in totale e regolarmente intorno al 99% in determinati settori. Consulta l'appendice per consultare lo scheletro che utilizziamo per creare la maggior parte delle nostre skill.
Alcune best practice:
Crea le skill pairwise: una skill di conoscenza funge da router di primo livello che consente di caricare su richiesta ulteriori dettagli di dominio. Dice: “Prova prima il livello semantico, ma se non c'è copertura, ecco circa 30 file di riferimento per questo dominio che descrivono le tabelle, le colonne, le unioni e le gotcha pertinenti”. Questo router è, in effetti, la nostra risposta ai fallimenti di recupero: anziché lasciare che l'agente cerchi in un warehouse di dati di milioni di campi, restringe lo spazio a poche decine di file curati prima ancora che venga scritta la query. La skill runbook codifica il processo che un analista senior seguirebbe: chiarisce la domanda, trova le fonti (tramite la skill knowledge), esegue la query e infine invia il risultato agli agenti secondari di revisione contraddittoria. Raccoglie inoltre una dozzina di modelli di analisi riutilizzabili (curve di ritenzione, composizione dei tassi, analisi del funnel) in modo che le richieste più comuni non debbano essere reinventate ogni volta.
Crea documenti di riferimento adeguati: scritti per essere recuperati dagli LLM. I nostri documenti di riferimento descrivono tabelle (granularità, ambito ed esclusioni), i meccanismi dei gotcha (ad esempio “Escludi i domini gratuiti noti, ma mantieni quelli personalizzati come anthropic.com”) e gli espliciti trigger di routing (ad esempio “SE la domanda riguarda l'aggiornamento degli esperimenti… NON utilizzarla per il numero grezzo degli eventi”) senza ricette prescrittive che possono diventare obsolete. Di seguito, puoi trovare lo scheletro che utilizziamo per creare i documenti di riferimento.
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]
Tratta la manutenzione delle competenze come una questione di prim'ordine: i documenti sulle competenze descrivono un modello di dati che cambia quotidianamente, senza una manutenzione attiva possono diventare errati in poche settimane. Abbiamo visto la nostra accuratezza offline passare da ~95%, al lancio, a ~65% entro un mese prima di trattarlo come un problema di ingegneria. Ciò ha significato collocare i file di markdown delle competenze nello stesso repository dei nostri modelli di trasformazione, in modo che la PR che modifica un modello sia la stessa PR che aggiorna il documento che lo descrive. Un hook di revisione del codice segnala eventuali modifiche al modello di reporting che non influiscono su un file di skill. Circa il 90% delle nostre PR sui modelli di dati ora include una modifica alle competenze nello stesso diff. Inoltre, aggiorniamo regolarmente lo scaffolding delle competenze, man mano che i modelli migliorano e le modalità di errore precedenti non sono più applicabili.
Crea un'esperienza coerente e senza interruzioni su tutte le superfici: la stessa skill deve fornire la stessa risposta alle domande in Slack, nell'IDE, in uno strumento di dashboard e nelle sessioni standalone degli agenti. Abbiamo ottenuto questo risultato assicurandoci di avere un'unica fonte canonica (il repository dei dati) e la sincronizzazione automatica delle modifiche alle skill. Al momento del merge, la skill viene sincronizzata con un marketplace di plugin (per gli utenti IDE), con i blob di storage cloud (per le app ospitate che leggono un singolo file) e viene messa a disposizione direttamente come risorse su MCP. Abbiamo inoltre progettato la portabilità fin dall'inizio, evitando percorsi di repo hardcoded e namespace specifici per gli interfacce.
Convalida
Infine, la convalida è il modo in cui scopri quale delle tre modalità di errore è ancora presente in modo evidente.
Valutazioni offline
Un andamento comune che riscontriamo è che i data team creano ambienti analitici elaborati senza disporre di alcun processo per comprendere l'accuratezza dei propri agenti di analisi.
Un modo per affrontare questa lacuna è attraverso le valutazioni offline, che sono semplici coppie domanda/risposta. Puoi pensare alle valutazioni offline come ai test offline per un modello di ML, in quanto non ti danno informazioni sulle prestazioni degli agenti online, ma consentono di capire in modo ragionevole se vi saranno eventuali lacune critiche.
In Anthropic implementiamo due tipi di valutazioni offline. Le valutazioni basate su dashboard vengono generate automaticamente da Claude (quindi convalidate da esseri umani), e rispondono alle domande più comuni poste dagli stakeholder. Le valutazioni di lunga portata, invece, ci consentono di integrare il contesto aziendale di Claude (roadmap, documenti di tabella) e di fare in modo che generi domande plausibili in tutto il resto del dominio. Inoltre, raccogliamo continuamente quando uno stakeholder corregge l'agente in un thread, poiché tale correzione è una candidata per essere valutata.
Ulteriori best practice, tra cui:
- Ancora la verità di base in modo che non possa andare alla deriva: un'eval scritta sulla base di dati in tempo reale diventa obsoleta nel momento in cui il numero sottostante cambia. Fissa ogni valutazione su una data istantanea, scrivila su una tabella stabile dei fatti o chiedi al valutatore di convalidare la query dell'agente anziché il suo numero. Integra la suite in CI in modo che una PR che interessa una dipendenza riesegua le valutazioni interessate.
- Archivia i risultati come telemetria, non come log dei test: ogni esecuzione viene memorizzata in una tabella di warehouse con la versione delle skill, git SHA, ID del modello, numero di token e valore del wallclock. “Questo cambiamento ha aiutato?” diventa una query che consente di ottenere le serie storiche per individuare le regressioni lente che una singola esecuzione di CI non riesce a rilevare.
- Lanci di gate per dominio: un proprietario di un dominio non può annunciare l'agente ai propri stakeholder finché la sua porzione di eval set non supera una certa soglia (inizialmente abbiamo utilizzato ~90%). Impone le correzioni nei documenti di riferimento prima che gli utenti vedano i difetti.
- Crea il numero appropriato di eval: il numero di eval necessario dipende dalla complessità dell'area di business e del modello di dati sottostante. Calibra monitorando l'efficacia delle previsioni offline rispetto a quella online: abbiamo riscontrato che ci sono rendimenti decrescenti oltre alcune decine di dollari per argomento (ad esempio, “crescita”) e che tale limite scende con ogni nuova generazione di modelli.
- La precisione offline dovrebbe essere del 100% circa: ogni risposta corretta dovrebbe essere presente anche nel livello semantico (se ne hai uno). Anche in questo caso, questo livello di accuratezza non significa che il sistema non produrrà una risposta sbagliata, ma significa solo che non ci saranno lacune evidenti, purché tu abbia una copertura adeguata delle valutazioni.
Tecniche di ablazione
Ogni decisione strutturale sulla skill (ad esempio, quali fonti esporre, se un sub-agente guadagna la sua latenza, se unire due skill in una) viene presa tenendo fisso il nostro set di valutazione offline.
Variamo esattamente un componente e confrontiamo i tassi di passaggio. Ogni esecuzione richiede solo un'ora e sostituisce un sacco di argomentazioni. La metodologia conta più del singolo risultato:
- prevedi risultati nulli. La nostra ablazione più utile è stata un'ablazione negativa. Abbiamo dato all'agente accesso diretto a tutta la nostra dashboard, alla trasformazione e al notebook SQL degli analisti (migliaia di file). Abbiamo quindi verificato nelle trascrizioni che il sistema le leggesse effettivamente prima di ogni risposta. L'accuratezza è aumentata di meno di un punto in entrambe le direzioni. Abbiamo quindi verificato le evidenze ovvie: la risposta era effettivamente nel corpus alle domande errate? Circa l'80% delle volte, la risposta era sì. Rispondere “È presente” prevedeva “ora è stato capito bene”? No, il tasso di flip era stabile. Le informazioni erano lì, l'agente le vedeva eppure non le utilizzava. Quel singolo esperimento ci ha rivelato che il nostro collo di bottiglia non era l'accesso al lavoro precedente, ma la struttura (ossia, l'assegnazione di una domanda all'entità giusta). Questa intuizione ha riorientato mesi di lavoro sulla roadmap.
- Ablazione alla granularità delle PR. Ogni modifica significativa alle abilità viene accompagnata da un test “prima/dopo” sulla sezione di valutazione pertinente, con il delta indicato nella descrizione delle PR. Questo metodo mantiene la sincerità dell'affermazione “Ho migliorato la documentazione” e coglie il caso sorprendentemente comune in cui un'aggiunta ben intenzionata peggiora le cose.
- Annota ciò che non ha funzionato. Ecco due delle nostre: 1) aggiungere ulteriori cicli di perfezionamento dei documenti oltre un certo punto (abbiamo raggiunto tre iterazioni negative negative nette perché i documenti stavano diventando più lunghi, non migliorando) e 2) sostituire il revisore contraddittorio con un modello più economico per ridurre la latenza (ha perso la maggior parte dei vantaggi in termini di accuratezza, senza alcun aumento reale). I risultati negativi sono facili da registrare e impediscono alla persona successiva di ripetere lo stesso esperimento.
Convalida online
Il passaggio finale è garantire che le prestazioni effettive del sistema online siano il più accurate possibile. Alcuni dei passaggi che adottiamo includono:
- Revisione contraddittoria: abbiamo scoperto che l'utilizzo di una skill di Claude per mettere in discussione tutte le ipotesi di base su una potenziale risposta finale ha aumentato l'accuratezza del 6% all'interno del nostro set di valutazione, ma al costo di un aumento del 32% di token e di una latenza superiore del 72%.
- Piè di pagina di provenienza: ogni risposta contiene un piè di pagina che indica il livello di origine da cui proviene (livello semantico › riferimento curato › tabella raw), l'aggiornamento dei dati sottostanti e il proprietario del modello. Non rende la risposta più corretta, ma aiuta a valutare quanto possiamo fidarci della risposta. Un footer “Tabella non elaborata, aggiornamento sconosciuto” è un segnale da verificare prima di inviare l'applicazione a monte ed è una delle poche misure di mitigazione che abbiamo per i problemi nascosti.
- Controlli sulla qualità dei dati: è possibile che l'agente stia utilizzando il campo giusto nel modo appropriato, ma i dati stessi non siano corretti. Aggiungere controlli di base sulla qualità dei dati per garantire che il campo di riferimento sia aggiornato, completo e privo di anomalie è generalmente una buona prassi di igiene.
- Monitoraggio passivo: due segnali di produzione che monitoriamo continuamente sono la quota di query degli agenti che vengono risolte tramite il livello semantico e la quota di risposte che utilizzano il linguaggio di correzione (“Quella è la tabella sbagliata”, “Manca il filtro antifrode”). Entrambi alimentano una dashboard revisionata settimanalmente insieme al tasso di passaggio offline.
- Raccolta attiva delle correzioni: la parte che chiude il ciclo. Un agente pianificato analizza i canali degli stakeholder ogni poche ore alla ricerca di linguaggi di correzione simili, redige una correzione di una riga per il documento di riferimento pertinente e apre una pull request contrassegnata con il proprietario del dominio. Il percorso di correzione è volutamente noioso (modifica di un file markdown > unione > sincronizzazione automatica ovunque) in modo che il proprietario di un dominio non debba dedicare troppo tempo a questa attività. Le stesse correzioni vengono reintrodotte nel set di valutazioni offline.
La modalità di errore che nessuno di questi riesce a cogliere appieno è quella silenziosa. La risposta è sbagliata, ma sembra plausibile e viene utilizzata senza obiezioni. Le nostre misure di mitigazione sono il piè di pagina di provenienza, l'esplicita approvazione umana per qualsiasi cosa vincolata dalla leadership e una valutazione permanente per i principali KPI di ogni settore che vengono confrontati quotidianamente con la dashboard approvata, anche se non disponiamo ancora di una soluzione solida.
Iniziare con l'analisi self-service
Se stai partendo da zero, una manciata di set di dati canonici, alcune decine di valutazioni offline e una skill di conoscenza sottile potranno fornirti la maggior parte dei vantaggi. Tutto il resto del post riguarda ciò che abbiamo aggiunto una volta che essi sono stati creati.
Abbiamo inoltre condiviso molte best practice, ma non tutte saranno appropriate per ogni data team. Allinea la tua organizzazione su alcuni principi che influenzeranno il tuo approccio chiedendoti quanto segue:
- Quanto è importante una risposta corretta oggi rispetto a in futuro? I modelli di IA stanno progredendo a ritmi rapidi. Vediamo spesso aziende che sviluppano una quantità significativa di infrastrutture per tenere conto delle attuali carenze dei modelli che diventano irrilevanti una volta che questi vengono migliorati. Sapere dove i modelli sono carenti e aspettarne i miglioramenti per colmare le lacune riduce significativamente i costi generali, ma potrebbe non essere una misura adeguata alla tolleranza al rischio della tua azienda.
- Come prevedi che cambi nel tempo la complessità della tua attività? Alcuni dei processi di cui abbiamo parlato potrebbero sembrare eccessivi se, ad esempio, non produci molti dati, hai solo pochi utenti dell'output o il tuo modello di dati probabilmente rimarrà semplice.
- Quanto è tecnico il pubblico di destinazione del risultato? Detto in modo diverso, se stai sviluppando un sistema di analisi per data scientist in grado di riconoscere quando una risposta è errata, potresti essere più tollerante agli errori rispetto a una situazione in cui il pubblico non ha familiarità con il modello di dati sottostante.
- Quanto vuoi spendere per migliorare la precisione? Abbiamo scoperto che alcuni processi come la convalida avversariale può migliorare significativamente l'accuratezza, ma spesso a costi e latenze più elevati.
- Quanto sei a tuo agio riguardo ai controlli di accesso e alla privacy dei dati interni? Gli agenti sono spesso significativamente più performanti quanto più contesto hanno; tuttavia, un accesso ampio ai dati compromette la governance della maggior parte delle aziende. Questo determina lo sviluppo di uno o più aganti.
Indipendentemente dalla tua scelta, i nostri maggiori vantaggi sono derivati dall'affrontare ciascuna delle tre modalità di fallimento: ridurre l'ambiguità in un'unica risposta governata, rendere la risposta facilmente reperibile e segnalare quando una delle due diventa obsoleta.
Questo articolo è stato scritto da Chen Chang, Clement Peng, Justin Leder, Johanne Jiao e Josh Cherry del team Data Science and Data Engineering. Gli autori desiderano ringraziare Michael Segner per il suo contributo.
Appendice
Scheletro del file di Skill
Di seguito è riportata la struttura della nostra principale skill di warehouse: la struttura effettiva del file, con le specifiche interne sostituite da [placeholder tra parentesi]. Non è pensato per essere copiato alla lettera, ma per farti capire il tipo di sezioni che pensiamo sia meglio annotare.
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]