Cómo Anthropic permite el análisis de datos de autoservicio con Claude
Como muchos equipos de ciencia de datos e ingeniería de datos pueden atestiguar, habilitar el autoservicio de análisis de datos ha sido tradicionalmente una tarea ardua.
Hacer que el modelo de datos sea más accesible para compañeros de trabajo menos técnicos a través de tablas amplias y desnormalizadas suele conllevar un solapamiento de puntos de vista con definiciones incoherentes a medida que la empresa crece (y hace pocas cosas para cerrar la brecha para los empleados con pocas ganas de aprender SQL). Por otro lado, crear entornos más cerrados para los usuarios a menudo evita tener en cuenta las cuestiones de negocio y provoca una saturación de métricas y paneles de control al dividir el trabajo en silos.
El auge de los LLM proporciona una ruta adicional para el análisis de autoservicio que evita esos desafíos. Sin embargo, señalar a Claude en un almacén y dejar que los agentes se ejecuten puede crear una falsa sensación de precisión.
La ilusión inicial de liberarse de las solicitudes ad hoc se convierte en miedo al darse cuenta de que esta configuración separa a las partes interesadas de la infraestructura, la documentación y la experiencia subyacentes que antes les guiaban hacia conjuntos de datos cuidadosamente seleccionados.
En Anthropic, el 95 % de las consultas de análisis empresarial se automatizan a través de Claude, con una precisión de ~95 % en total. Al delegar este trabajo, a menudo rutinario y repetitivo, en Claude, nuestro equipo de ciencia de datos puede centrarse en tareas más estratégicas, como el modelado causal, la predicción y el aprendizaje automático.
Tras reunirnos con docenas de los principales usuarios de Claude Code de Anthropic y ver multitud de patrones de diseño para agentes de análisis, hemos desarrollado algunas prácticas recomendadas para otros equipos de datos que trabajan con LLM. En esta publicación, compartiremos estos consejos y enfoques para maximizar la capacidad de Claude de impulsar información empresarial de forma autónoma, entre los que se incluyen:
- Por qué la precisión de los análisis es un problema de contexto y verificación, no de generación de código;
- Los tres modos de fallo que causan la mayoría de los errores;
- La pila de análisis de IA de agentes que hemos creado para abordar estos errores;
- Cómo medimos la efectividad; y
- Una plantilla básica de cómo creamos la mayoría de nuestras skills (véase el apéndice)
Los datos no son software
Las skills generativas de los LLM son un arma de doble filo: los mecanismos que permiten soluciones creativas a problemas complejos también pueden producir alucinaciones o resultados erróneos. Para comprender completamente los desafíos de los agentes de análisis, es útil compararlos con los agentes de programación.
La programación es un espacio de soluciones abierto que premia la creatividad de los modelos, mientras que la documentación y las pruebas proporcionan barreras de seguridad naturales contra las alucinaciones. Por el contrario, para los casos de uso de analítica, a menudo solo hay una respuesta correcta y una única fuente correcta en la que no hay una forma determinista de demostrar la corrección.
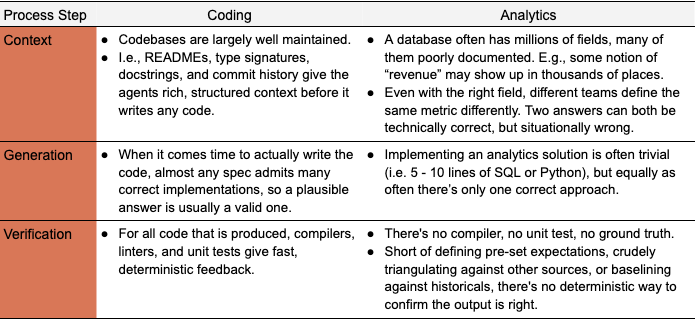
Para el análisis empresarial de autoservicio basado en agentes, la complejidad radica principalmente en la ambigüedad de los datos. El problema central se reduce a nuestra capacidad para asignar la pregunta de un usuario a entidades específicas y actualizadas de nuestro modelo de datos y conocer la forma correcta de trabajar con ellas. Si podemos hacer eso, entonces la ejecución resultante y el SQL se vuelven triviales.
Hemos identificado tres atributos de este problema que explican la inmensa mayoría de las respuestas inexactas:
- Ambigüedad de concepto y de entidad: con cientos de opciones viables en un modelo de datos (de potencialmente millones de campos), el agente no puede elegir los campos correctos que mejor respondan a la pregunta de un usuario. Por ejemplo, al medir el número de usuarios activos: ¿qué acciones constituyen el estar "activo"? ¿Incluyes a usuarios fraudulentos? ¿Qué ventana temporal utilizas?
- Datos obsoletos: las fuentes de datos, las definiciones empresariales y los esquemas cambian constantemente; los activos y el conocimiento de los agentes se vuelven obsoletos y comienzan a dar respuestas ligeramente erróneas.
- Error de recuperación: la información correcta puede estar en el modelo de datos y estar debidamente anotada, pero dada la amplitud del espacio de búsqueda, el agente simplemente no la encuentra.
Nuestra pila de análisis de autoservicio de agentes
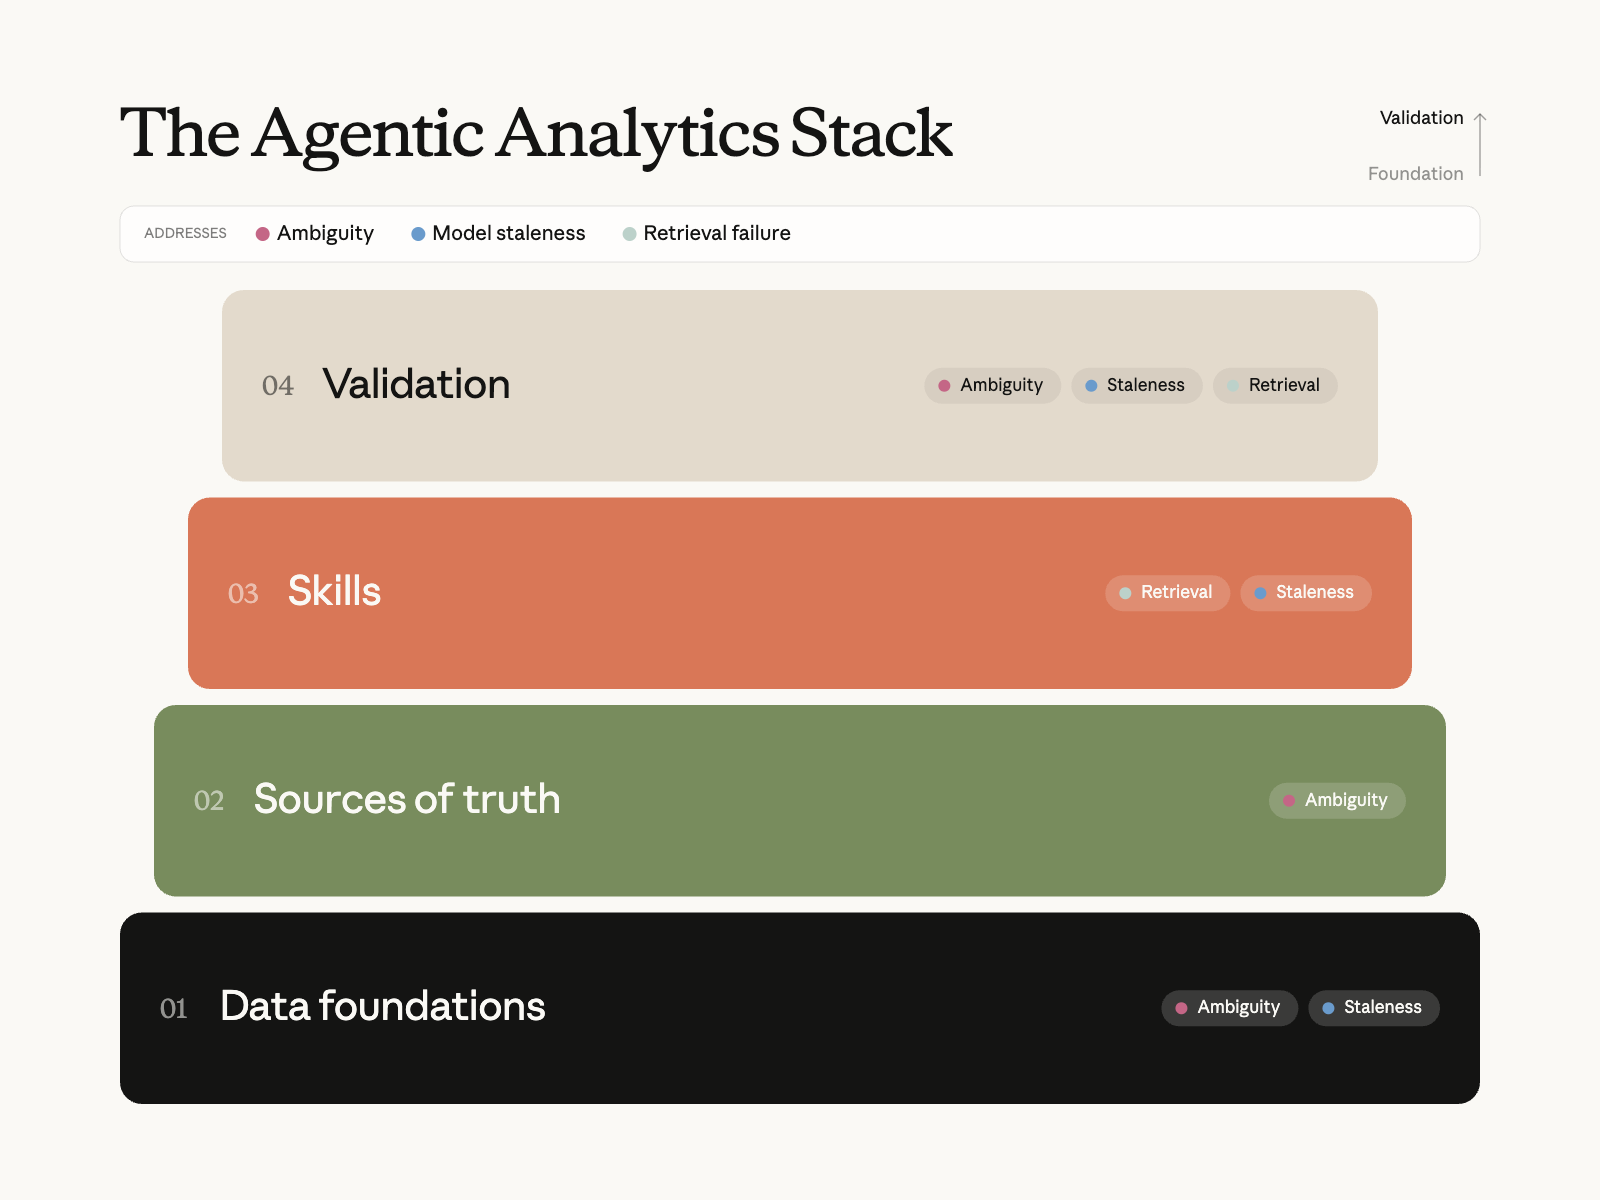
En Anthropic, la principal forma de minimizar estos tres errores es a través de nuestra pila de datos agénticos. Cada capa existe principalmente para abordar uno o más de estos problemas:
- Ambigüedad de entidades: los fundamentos de datos y las fuentes de verdad reducen el espacio de entidades plausibles hasta que existe una única respuesta gobernada.
- Obsolescencia: los procesos de mantenimiento y validación evitan que todo se deteriore a medida que cambia el negocio.
- Error de recuperación: las skills aseguran que el agente encuentre esa respuesta de forma fiable y la use correctamente.
En esta sección, analizaremos cómo construimos cada capa.
“Para preguntas puntuales hechas directamente en Slack, descubre cómo nuestro equipo de datos implementa un agente de análisis de datos con Claude Tag.”
Bases de datos
El aspecto más importante para garantizar que los agentes de análisis sean precisos es contar con sólidos fundamentos de datos, que incluyen los modelos de datos, las transformaciones, las pruebas y las tablas de un almacén de datos, junto con los metadatos que los describen. Las prácticas estándar de ingeniería de datos y calidad de datos, como el modelado dimensional, las pruebas de shift-left y las comprobaciones de actualización y exhaustividad de los flujos de datos críticos, siguen siendo aplicables (y no las revisaremos).
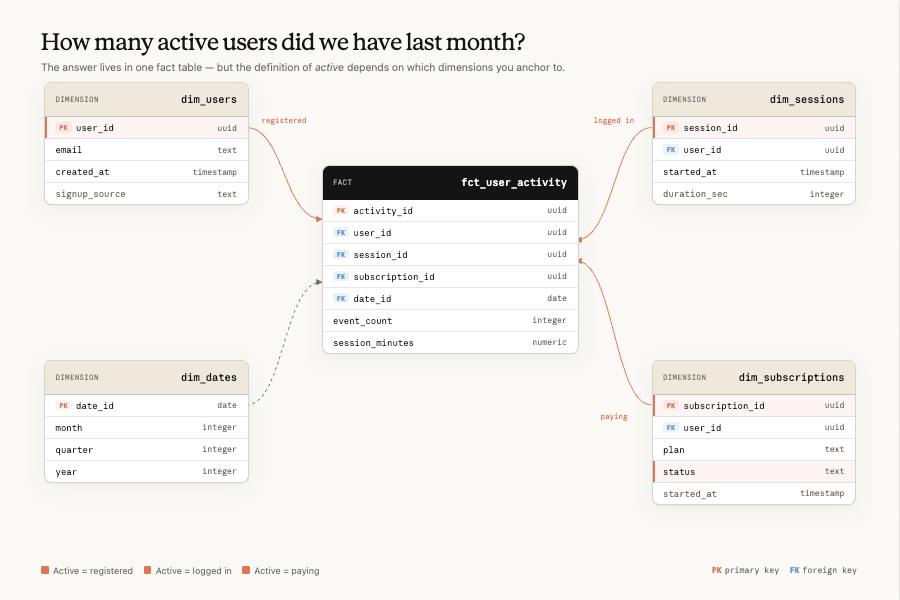
Lo que sí cambia es que el usuario final de tu modelo de datos ya no es un experto en datos (por ejemplo, un científico de datos), sino más bien agentes que actúan en nombre de usuarios con diversos grados de experiencia en datos o de comprensión de la infraestructura subyacente. Este cambio presenta un reto, ya que los resultados no pueden requerir que el usuario valide la exactitud subyacente, simplemente porque el usuario final no tiene los conocimientos necesarios.
La capa de fundamentos de datos está dirigida principalmente a la ambigüedad: si los ingresos, por ejemplo, se reducen a un conjunto de datos gobernado en lugar de cuarenta candidatos plausibles, el problema desaparece en gran medida antes de que el agente tenga que buscar. También es donde reside la primera defensa contra la obsolescencia, ya que el mismo repositorio que define los modelos canónicos es el lugar natural para exigir que se mantengan actualizados.
Hemos visto que algunas prácticas funcionan especialmente bien:
- Crear conjuntos de datos canónicos: con mucho, el error más común es que el agente no pueda asignar un concepto («ingresos por producto X») a la única definición correcta de tabla, columna y métrica, generalmente porque hay múltiples candidatos plausibles con implementaciones ligeramente diferentes. La solución es tener menos modelos lógicos y más fuertemente gobernados: seleccionar un pequeño grupo de conjuntos de datos canónicos y de fuente única de verdad que tengan un propietario claro, estén listos para el consumo y sean localizables, y luego descontinuar agresivamente los casi duplicados. Los rollups físicos y las cachés siguen siendo importantes desde el punto de vista del coste y el rendimiento, pero deberían derivarse mecánicamente de los modelos canónicos en lugar de coexistir con ellos como alternativas. El objetivo es que cuando un agente busca un concepto, encuentre una única respuesta gobernada.
- Hacer cumplir tus estándares: Hemos descubierto que los fundamentos solo se mantienen si los modelos canónicos y las definiciones de métricas se aplican mediante herramientas (el agente se les envía estructuralmente primero; más sobre eso más adelante), mediante CI (cambios que evitan la revisión de errores) y por mandato (los equipos en sentido descendente desarrollan la capa gobernada o explican por qué no). La gobernanza sin cumplimiento, de lo contrario, degenera rápidamente de nuevo en el problema de los múltiples candidatos.
- Colocalizar artefactos: nuestra principal defensa contra los modelos de datos y la lógica empresarial que cambian constantemente es la colocalización. Casi todo el código de datos (es decir, modelización, capa semántica, documentos de referencia, definiciones de paneles canónicos) reside en un solo repositorio, con verificaciones de CI que protegen la integridad entre capas. Si un cambio de modelado interrumpiera un panel en sentido descendente o invalidara una métrica documentada, CI lo señala y la solución se incluye en la misma PR. (Volveremos a la mecánica de esto en la sección de Skills que aparece a continuación).
- Tratar los metadatos como un producto de primera clase: los agentes de programación funcionan bien en parte porque las bases de código son legibles: README, firmas de tipo, docstrings, etc. Tu almacén puede ser igual de legible, pero solo si las descripciones de columnas y tablas, las definiciones de métricas canónicas, la documentación detallada, los rangos de valores válidos, el linaje, la propiedad y la clasificación por niveles de modelos se mantienen con el mismo rigor que las transformaciones mismas. Si bien no es una nueva perspectiva, la buena gobernanza proporciona un contexto crítico que ayuda al agente a elegir el conjunto de datos correcto.
Fuentes de verdad
Si los cimientos de datos son el almacén de datos en sí, las fuentes de verdad son las interfaces de referencia que el agente consulta para navegar por él. Esta capa reduce la ambigüedad de concepto <> entidad y convierte los «usuarios activos semanales» en la pregunta de una parte interesada en una entidad específica y gobernada en tu modelo de datos. Aproximadamente en orden descendente de confianza:
- Capa semántica: las definiciones de métrica y dimensión compiladas. Si una pregunta se asigna claramente a una métrica definida, el agente llama a una función y obtiene un número, el mismo número que produce cualquier otra interfaz de la empresa. Se requiere estructuralmente (por instrucción de skills) que nuestros agentes aprovechen primero la capa semántica (véase el apéndice). Una idea que probamos y que no funcionó: poner en marcha la capa semántica haciendo que un LLM generara automáticamente definiciones de métricas a partir de tablas sin procesar y registros de consulta. Produjo definiciones que parecían plausibles y que codificaban las ambigüedades que estábamos tratando de eliminar, y fue netamente negativa en nuestras evaluaciones frente a una capa más pequeña y creada por humanos. Por lo tanto, recomendamos generar la documentación con Claude, pero dejar que un humano se encargue de la definición.
- El linaje y el gráfico de transformación: cuando la capa semántica no cubre una pregunta, el linaje y la clasificación de tablas (en función del número de referencias) permiten al agente razonar sobre qué modelos en sentido ascendente alimentan un concepto, cuáles están obsoletos y cuáles comparten el mismo grado. Esto transforma el "No conozco la métrica" en "Sé desde qué modelo gobernante puedo realizar la agregación". También es la columna vertebral de las señales de frescura y procedencia que mostramos en la validación online a continuación.
- Corpus de consultas: SQL histórico de paneles de control, cuadernos y análisis previos. Intuitivamente, esto debería ser de gran valor: es un registro de todas las preguntas que ya se han respondido correctamente. En la práctica, descubrimos que dar al agente acceso de recuperación sin procesar a miles de consultas anteriores modificaba la precisión en menos de un punto (analizaremos esa ablación en una sección posterior). La recuperación no estructurada no pudo asignar una nueva pregunta al precedente correcto. Lo que sí funciona es destilar ese corpus en documentos de referencia estructurados por dominio y patrones de análisis reutilizables descritos en las Skills. Trata el historial de consultas como materia prima para la selección, no como una fuente de verdad que el agente pueda leer directamente.
- Contexto empresarial: la capa que la mayoría de los equipos se saltan y la que hemos subestimado durante más tiempo. Un agente que no entiende tu empresa responderá a lo que el usuario preguntó, pero no a lo que quiso decir. No sabrá que "el lanzamiento del segundo trimestre" se refiere a un producto específico, que dos equipos definen el mismo término de manera diferente o que se hace una pregunta porque una reunión de la junta directiva es el jueves. Integramos un gráfico de conocimiento de la empresa que consta de documentos indexados, hojas de ruta, registros de decisiones y nuestra estructura organizativa para que el agente pueda resolver referencias contextuales y formular mejores preguntas aclaratorias.
El patrón de fallo común en los cuatro es el mismo que en la capa de fundamentos de datos: documentación deficiente u obsoleta. Claude es excepcionalmente útil para cerrar la brecha (redactar descripciones de columnas, proponer documentación de métricas a partir de patrones de consulta, señalar modelos no documentados en CI), pero la curación y la propiedad están a cargo de humanos.
En las dos secciones siguientes, analizaremos cómo conseguir que esa propiedad sea lo suficientemente barata como para que realmente ocurra.
Skills
Si las fuentes de verdad son el conocimiento declarativo del agente (es decir, lo que significa una métrica), entonces una skill es su conocimiento procedimental: qué fuentes consultar y en qué orden, cómo navegar por datos ambiguos y cómo se ve un análisis terminado.
En Claude Code, un skill es una carpeta de markdown que el agente lee bajo demanda. En Anthropic, las skills que hemos desarrollado son de gran valor añadido. Sin skills, la capacidad de Claude para responder con precisión a preguntas de analítica no superaba el 21 % en nuestras evaluaciones. Al añadir Skills, estas cifras se sitúan de forma constante por encima del 95 % en total y de forma regular en torno al 99 % en determinados ámbitos. Consulta el apéndice para ver un esqueleto que usamos para crear la mayoría de nuestras skills.
Algunas prácticas recomendadas:
Crea skills por parejas: una skill de conocimiento actúa como un enrutador delgado de nivel superior que permite cargar detalles adicionales de dominio bajo demanda. Dice "prueba primero la capa semántica, pero si no hay cobertura, aquí tienes unos 30 archivos de referencia para este dominio que describen las tablas, columnas, uniones y gotchas relevantes". Este router es, en efecto, nuestra respuesta al error de recuperación: en lugar de dejar que el agente busque en un almacén de millones de campos, reduce el espacio a unas pocas docenas de archivos seleccionados antes de que se escriba una consulta. La skill runbook codifica el proceso que seguiría un analista senior: aclarar la pregunta, encontrar fuentes (a través de la skill de conocimiento), ejecutar la consulta y luego pasar el resultado a través de subagentes de revisión contradictoria. También incluye una docena de patrones de análisis reutilizables (curvas de retención, descomposición de tasas, análisis de embudo) para que las solicitudes comunes no tengan que reinventarse cada vez.
Crea documentos de referencia adecuados: escritos para que un LLM los pueda recuperar. Nuestros documentos de referencia describen tablas (granularidad, alcance y exclusiones), la mecánica de los gotchas (p. ej., "excluye los dominios de correo electrónico gratuito conocidos, pero mantén los personalizados como anthropic.com") y los desencadenadores explícitos de enrutamiento (p. ej., "SI la pregunta es sobre el incremento de experimentos… NO las uses para el recuento de eventos en bruto") sin recetas prescriptivas que se queden obsoletas. A continuación encontrarás un modelo que usamos para crear documentos de referencia.
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]
Trata el mantenimiento de skills como un ciudadano de primera clase: los documentos de skills describen un modelo de datos que cambia a diario, así que sin mantenimiento activo se equivocarían en cuestión de semanas. Vimos que nuestra precisión offline pasaba de ~95 % en el lanzamiento a ~65 % en un mes, antes de tratarlo como un problema de ingeniería. Eso significaba colocar los archivos de skill markdown en el mismo repositorio que nuestros modelos de transformación, por lo que el PR que cambia un modelo es el mismo PR que actualiza el documento que lo describe. Un hook de revisión de código señala cualquier cambio en el modelo de generación de informes que no afecte a un archivo de skills. Aproximadamente el 90 % de nuestras PR de modelos de datos ahora incluyen un cambio de skill en la misma diferencia. También ajustamos periódicamente el andamiaje de skills a medida que los modelos mejoran y los modos de fallo anteriores ya no se aplican.
Crea una experiencia coherente y fluida en todas las interfaces: la misma skill debe proporcionar la misma respuesta a las preguntas en Slack, en el IDE, en una herramienta de panel de control y en sesiones independientes con agentes. Para ello, nos aseguramos de que hubiera una fuente canónica (el repositorio de datos) y de que los cambios de skills se sincronizaran automáticamente. En el momento de la fusión, la skill se sincroniza con un marketplace de plugins (para usuarios de IDE), con blobs de almacenamiento en la nube (para aplicaciones alojadas que leen un solo archivo) y se pone directamente a disposición como recursos a través de MCP. También diseñamos teniendo en cuenta la portabilidad desde el principio, evitando rutas de repositorios de código duro y espacios de nombres específicos de interfaces.
Validación
Por último, la validación es la forma de averiguar cuál de los tres modos de fallo sigue filtrándose.
Evaluaciones sin conexión
Un patrón común que vemos es que los equipos de datos configurarán entornos analíticos elaborados sin tener ningún proceso para comprender la precisión de sus agentes de análisis.
Una forma de abordar esta brecha es a través de evaluaciones offline, que son simples pares de pregunta y respuesta. Las evaluaciones offline se pueden comparar a las pruebas offline de un modelo de aprendizaje automático, ya que no te dicen el rendimiento de tus agentes online, pero sí te dan una buena idea de si tendrás alguna laguna crítica.
En Anthropic implementamos dos tipos de evaluaciones offline. Las evaluaciones basadas en dashboards son generadas automáticamente por Claude (y luego validadas por humanos) y cubren las preguntas más comunes de los interesados. Las evaluaciones de larga talla son donde aportamos contexto empresarial a Claude (hojas de ruta, documentos de tabla) y le permitimos generar preguntas plausibles para el resto del dominio. También registramos continuamente cada vez que una parte interesada corrige al agente en un hilo, ya que esa corrección es una evaluación de candidatos.
Otras mejores prácticas incluyen:
- Anclar la verdad en el fondo para que no se desvíe: una evaluación realizada en función de datos en tiempo real se vuelve obsoleta en el momento en que el número subyacente cambia. Fija cada evaluación a una fecha instantánea, compártela en una tabla de hechos estable o pide al evaluador que juzgue la consulta del agente en lugar de su número. Conecta la suite a la CI para que un PR que toque una dependencia vuelva a ejecutar las evaluaciones afectadas.
- Almacena resultados como telemetría, no como registros de pruebas: cada ejecución termina en una tabla de warehouse con la versión de la skill, git SHA, ID de modelo, número de aprobación/fracaso por aserción, recuento de tokens y reloj de pared. "¿Ese cambio ayudó?" se convierte en una consulta y obtienes las series temporales para detectar regresiones lentas que una sola ejecución de CI no detectará.
- Control de lanzamientos por dominio: el propietario de un dominio no puede anunciar el agente a sus partes interesadas hasta que su porción del conjunto de evaluaciones supere un cierto umbral (inicialmente usamos ~90 %). Forza las correcciones de reference-doc antes de que los usuarios vean los errores.
- Crea el número adecuado de evaluaciones: el número de evaluaciones que deberías tener depende de la complejidad del área de negocio y de la complejidad del modelo de datos subyacente. Calibra haciendo un seguimiento de qué tan bien la precisión offline predice la precisión online: hemos descubierto que hay rendimientos decrecientes por encima de unas pocas docenas de dólares por tema (por ejemplo, «crecimiento»), y que ese límite se reduce con cada nueva generación de modelo.
- La precisión de la evaluación offline debe ser de ~100 %; cada respuesta correcta también debe llegar a tu capa semántica (si tienes una). Una vez más, este nivel de precisión no significa que tu sistema no vaya a producir una respuesta incorrecta, sino que solo no haya lagunas obvias, suponiendo que tengas una cobertura de evaluación adecuada.
Técnicas de ablación
Cada decisión estructural sobre la skill (por ejemplo, qué fuentes exponer, si un subagente adquiere su latencia o si fusionar dos skills en una) se toma manteniendo nuestro conjunto de evaluaciones offline sin cambiar.
Variamos exactamente un componente y comparamos las tasas de aprobación. Cada ejecución solo lleva una hora y sustituye a muchos argumentos. La metodología importa más que cualquier resultado individual:
- Diseñar para obtener resultados nulos. Nuestra ablación más útil fue una negativa. Le dimos al agente acceso directo mediante grep a todo nuestro panel de control, transformación y SQL de los analyst-notebooks (miles de archivos). Luego verificamos en las transcripciones que realmente las leía antes de cada respuesta. La precisión cambió menos de un punto en cualquier dirección. Luego verificamos los factores de confusión obvios: ¿estaba la respuesta realmente en el corpus para las preguntas que se habían equivocado? Alrededor del 80 % de las veces, sí. ¿Acaso "responder presente" predijo "ahora lo hace bien"? No, la tasa de cambio era estable. La información estaba allí, el agente la veía, y aún así no la usaba. Ese único experimento nos dijo que nuestro cuello de botella no era el acceso al trabajo anterior, sino la estructura (es decir, asignar una pregunta a la entidad correcta). Esa información reorientó meses de hoja de ruta.
- Ablate con detalle de PR. Cada edición significativa de una skill recibe un antes y un después del segmento de evaluación relevante, con el delta en la descripción de la PR. Mantiene la sinceridad de "He mejorado la documentación" y captura el caso sorprendentemente común en el que una adición bien intencionada empeora las cosas.
- Haz una breve lista de lo que no funcionó. Dos de las nuestras: acumular rondas adicionales de refinamiento de documentos pasado cierto punto (llegamos a tres iteraciones consecutivas con resultados netos negativos: los documentos se iban haciendo más largos, no mejorando), y sustituir al revisor contradictorio por un modelo más barato para reducir la latencia (perdió la mayor parte de las ganancias de precisión, sin una verdadera aceleración). Los resultados negativos son baratos de registrar y evitan que la siguiente persona vuelva a ejecutar el mismo experimento.
Validación en línea
El último paso es garantizar que el rendimiento real del sistema en línea sea lo más preciso posible. Algunos de los pasos que damos incluyen:
- Revisión contradictoria: hemos descubierto que emplear una skill de Claude para desafiar agresivamente todas las suposiciones subyacentes de una posible respuesta final aumentó la precisión en un 6 % dentro de nuestro conjunto de evaluaciones, pero a costa de un 32 % más de tokens y un 72 % más de latencia.
- Pie de página de procedencia: cada respuesta tiene un pie de página que indica de qué nivel de origen procede (capa semántica › referencia seleccionada › tabla sin procesar), qué tan recientes son los datos subyacentes y quién es el propietario del modelo. No hace que la respuesta sea más correcta, pero sí ayuda al consumidor a juzgar hasta qué punto puede confiar en la respuesta. Un pie de página de "tabla sin procesar, frescura desconocida" es una señal para verificar antes de enviarla en sentido ascendente, y es una de las pocas mitigaciones que tenemos para los fallos silenciosos.
- Comprobaciones de calidad de los datos: es posible que tu agente esté usando el campo correcto de la forma adecuada, pero los datos en sí sean incorrectos. Añadir controles básicos de calidad de datos para garantizar que el campo de referencia esté actualizado, completo y libre de anomalías suele ser una buena práctica.
- Monitorización pasiva: dos señales de producción que rastreamos continuamente son la proporción de consultas de agentes que se resuelven a través de la capa semántica y la proporción de respuestas que utilizan lenguaje de corrección ("esa es la tabla equivocada", "te falta el filtro de fraude"). Ambos alimentan un panel que se revisa semanalmente junto con la tasa de aprobación fuera de línea.
- Recolección activa de correcciones: la parte que cierra el ciclo. Un agente programado escanea los canales de las partes interesadas cada pocas horas en busca de lenguaje correctivo similar, redacta una corrección de una sola línea para el documento de referencia relevante y abre un PR etiquetado para el propietario del dominio. La ruta de corrección es deliberadamente aburrida (editar un archivo de markdown, fusionar, sincronizar automáticamente en todo), por lo que el propietario de un dominio no pasa demasiado tiempo en la tarea. Las mismas correcciones se reflejan en el conjunto de evaluaciones offline.
El modo de falla que nada de esto capta completamente es el silencioso. La respuesta es incorrecta, pero parece plausible y se utiliza sin objeciones. Nuestras mitigaciones son el pie de página de la procedencia, la aprobación humana explícita de cualquier cosa vinculada al liderazgo y una evaluación permanente de los principales KPI de cada dominio que el cordón compara diariamente con el panel de control aprobado, aunque aún no tenemos una solución sólida.
Primeros pasos con el análisis de autoservicio
Si comienzas desde cero, un puñado de conjuntos de datos canónicos, unas pocas docenas de evaluaciones offline y una pequeña skill de conocimiento bastarán para obtener la mayor parte de los beneficios; todo lo demás de esta publicación es lo que añadimos una vez que se completaron.
También compartimos muchas buenas prácticas, y no todas serán apropiadas para todos los equipos de datos. Ponte de acuerdo con tu organización sobre algunos principios que afectarán tu enfoque preguntando:
- ¿Qué tan importante es una respuesta correcta hoy frente a en el futuro? Los modelos de IA están progresando a un ritmo vertiginoso. A menudo vemos que las empresas construyen una cantidad significativa de infraestructura para cubrir las deficiencias de los modelos actuales, las cuales se vuelven irrelevantes una vez que esos modelos mejoran. Saber dónde fallan los modelos y esperar a que las mejoras del modelo cubran la brecha supone significativamente menos sobrecarga, pero puede que no se ajuste a la tolerancia al riesgo de tu empresa.
- ¿Cómo prevés que la complejidad de tu empresa cambie con el tiempo? Algunos de los procesos que hemos analizado pueden ser exagerados si, por ejemplo, no se producen muchos datos, solo se tienen unos pocos consumidores de los resultados o es probable que tu modelo de datos siga siendo simple.
- ¿Qué tan técnico es el público al que va dirigido el resultado? Dicho de otra manera, si estás creando este sistema de análisis para científicos de datos que puedan reconocer cuándo una respuesta es incorrecta, puedes ser más tolerante a los errores que si estuvieras en una situación en la que el público no estuviese familiarizado con el modelo de datos subyacente.
- ¿Cuánto estás dispuesto a gastar para mejorar la precisión? Hemos descubierto que ciertos procesos como la validación adversaria pueden mejorar significativamente la precisión, pero a menudo a un coste y una latencia más altos.
- ¿Qué tan cómodo te sientes con los controles de acceso y la privacidad de los datos internos? Los agentes suelen tener un rendimiento significativamente mejor cuanto más contexto tienen; sin embargo, un acceso amplio a los datos va en contra de la postura de gobernanza de la mayoría de las empresas. Esto determina si estás creando un agente o muchos con un alcance determinado.
Cualquiera que sea la ruta, nuestros mayores beneficios han venido de abordar cada uno de los tres modos de fallo: reducir la ambigüedad en una única respuesta gobernada, hacer que la respuesta sea fácilmente detectable y señalar cuándo cualquiera de los dos se haya vuelto obsoleta.
Este artículo fue escrito por Chen Chang, Clement Peng, Justin Leder, Johanne Jiao y Josh Cherry, miembros del equipo de Ciencia de datos e Ingeniería de datos. Los autores desean agradecer a Michael Segner sus contribuciones.
Apéndice
Esqueleto del archivo de skills
Lo que sigue es el esqueleto de nuestra principal skill de almacén: la estructura real del archivo, con detalles internos sustituidos por [marcadores de posición entre corchetes]. No está pensado para copiarse textualmente; su objetivo es mostrar el tipo de secciones que nos pareció que valía la pena escribir.
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]